PoS SAE:词性信息分布在一组潜变量中
95%覆盖不等于95%精度;可线性读出也不等于模型因果使用
研究把 Llama-3-8B 的稀疏自编码器激活与 GUM 词性标签对齐,寻找可跨样本复用的小组。结果支持词性信息分布式存在,却没有得到“一种词性对应一个纯净特征”的结论;控制句中的高召回、低精度尤其值得注意。
图解主要方法
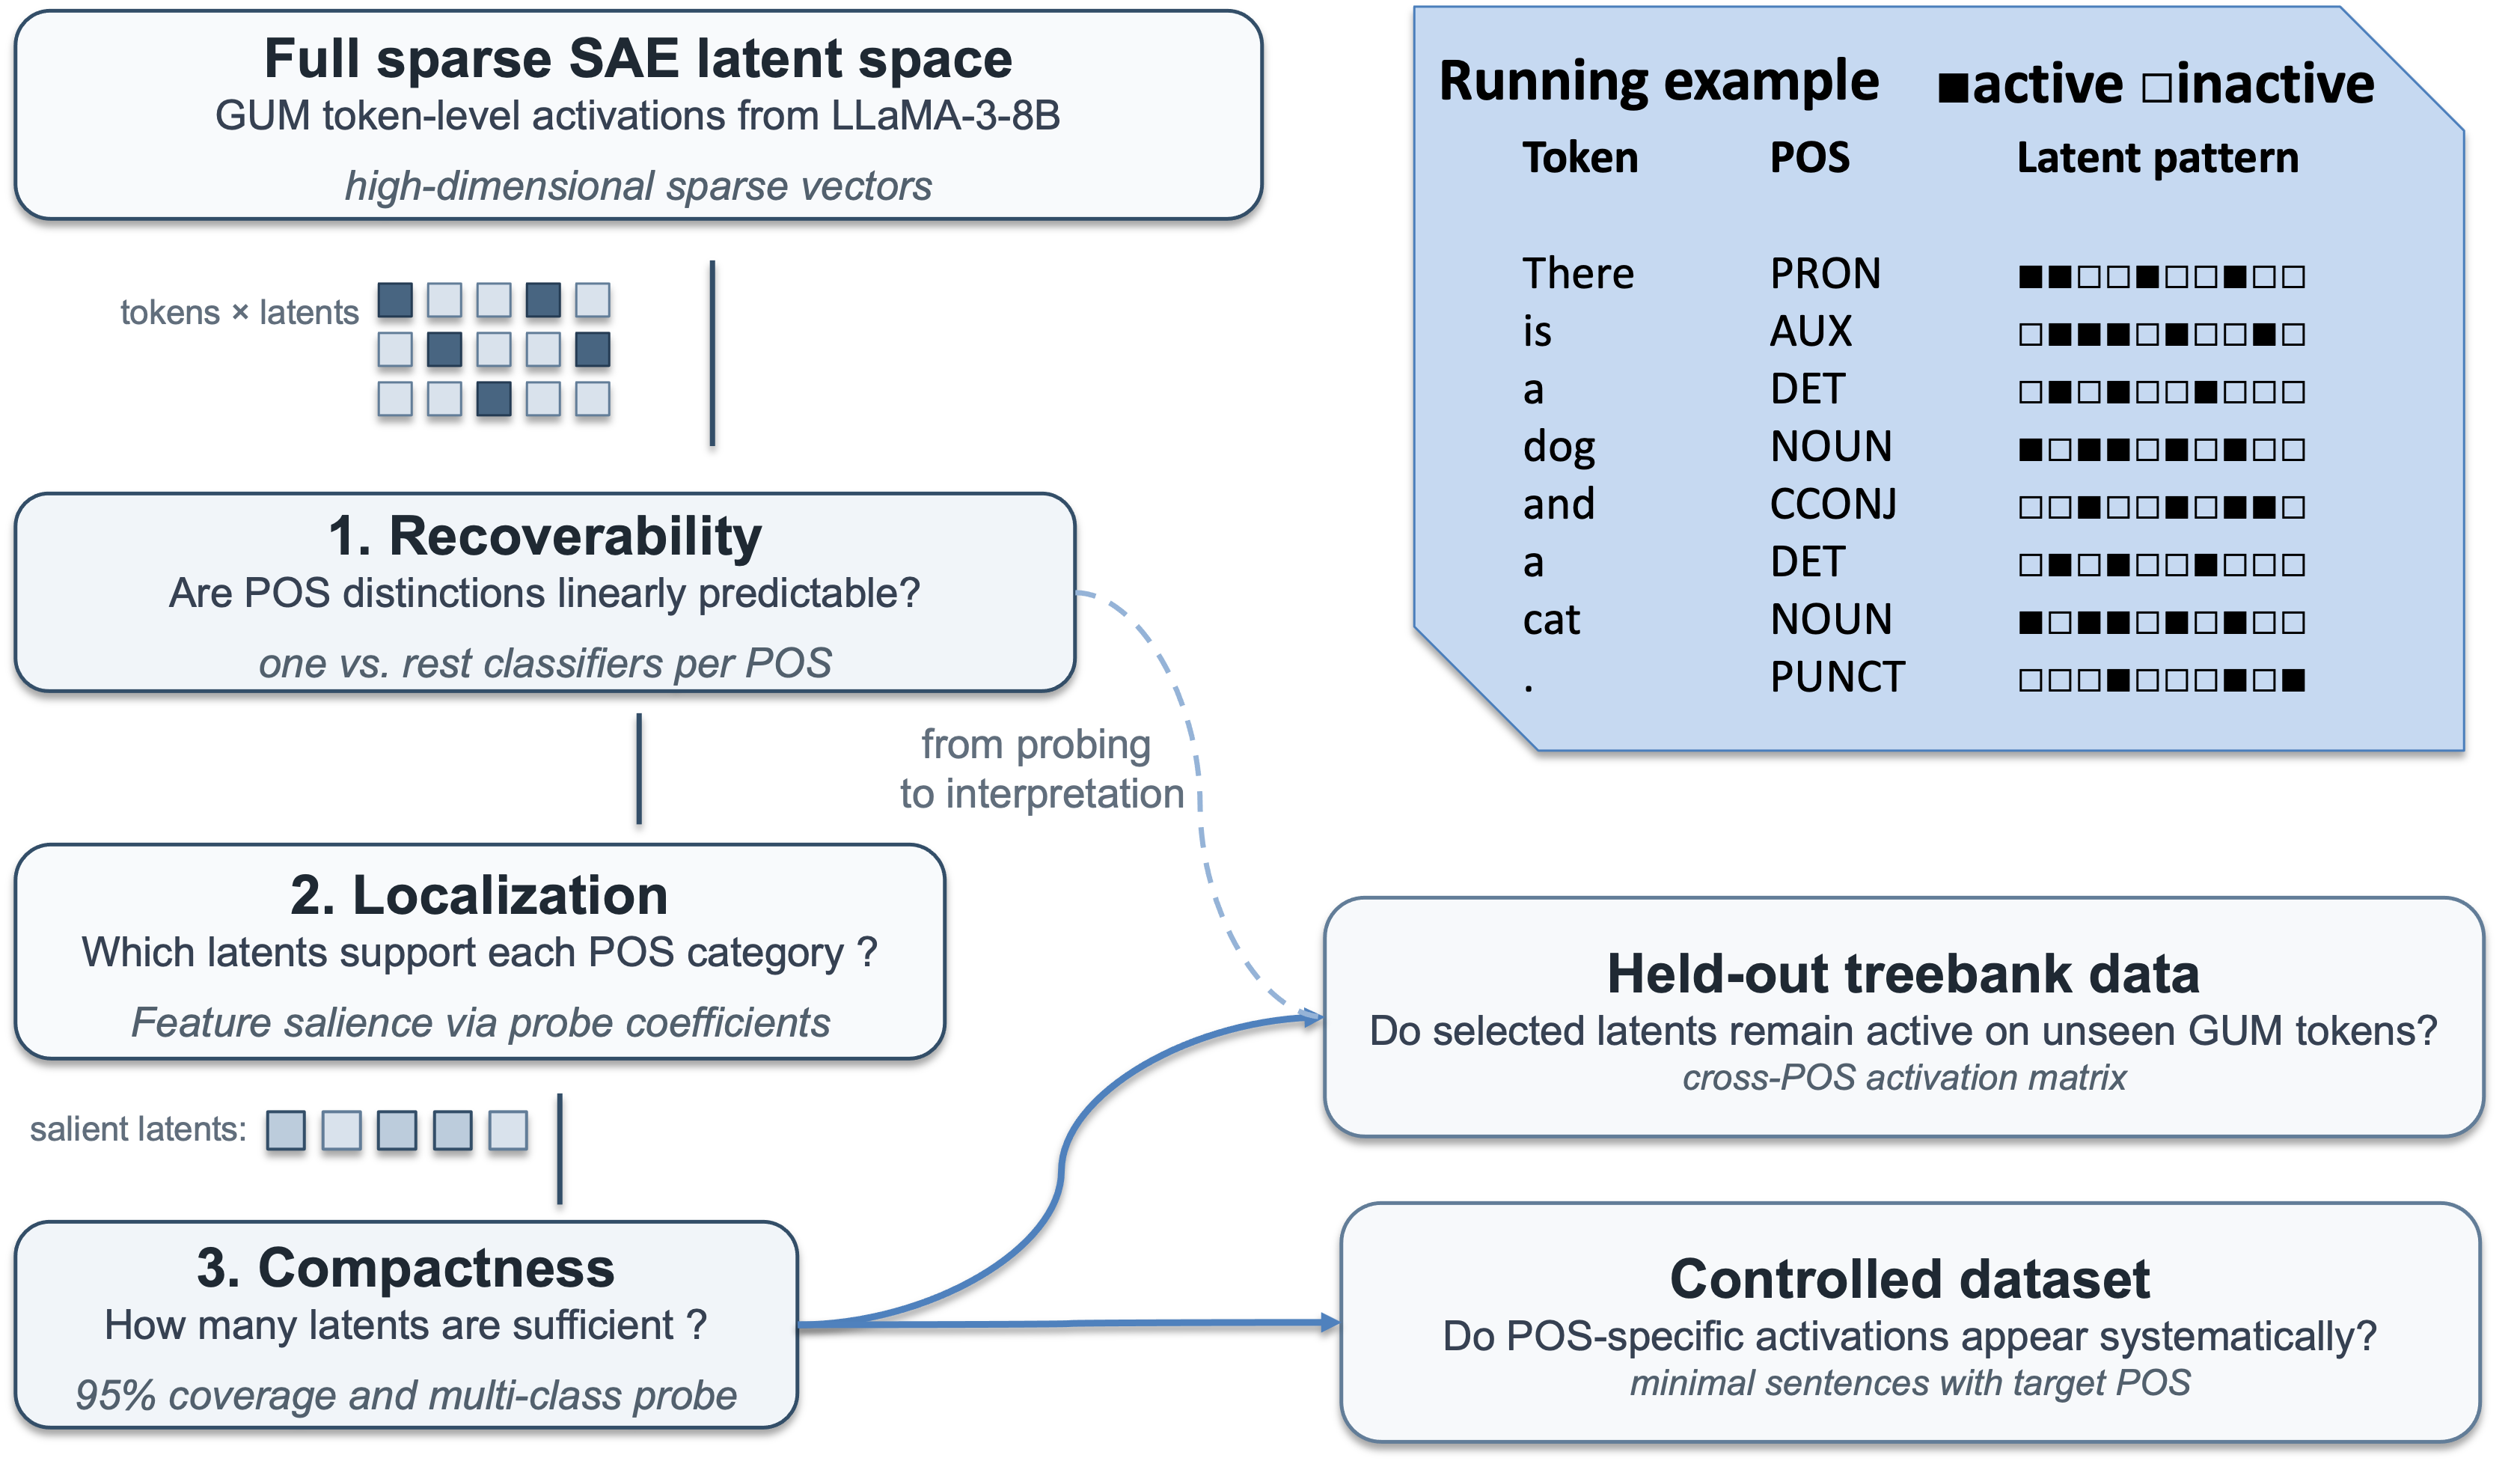
图1的探针、紧凑分组和独立验证分别回答什么问题?
- 1
对齐词与稀疏激活
图左将14,353句、252,284个词的GUM树库与Llama-3-8B对齐,取最左子词激活作为词锚点,而非对整个词池化。主实验用第30层、32倍扩展的131,072维SAE;这种对齐选择会影响多子词词形的解释。
- 2
用监督探针寻找相关潜变量
图中对17种词性分别训练带L1正则的逻辑回归,训练集五折交叉验证,C=0.1并平衡类别。按正系数排序,是找到对词性预测有用的维度,不是自动发现互不重叠的自然语法模块。
- 3
按激活覆盖压缩词性组
每类取最小集合,使95%的该类金标准词至少激活其中一个特征。所有组并集为498维,约12%特征被两类以上共享。覆盖只保证“碰到”,并不惩罚其他词性也激活这些特征,所以不是95%分类正确率。
- 4
用留出数据和受控词形检验
图右在留出集评多类分类,并用180个词项及模板控制词性与词形。前置“1.”后首位置效应随位置移动,说明激活还编码句子位置等因素。跨第2、15、30层分析支持结构稳定性,但没有通过特征干预验证模型是否因果使用这些组。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【分类条件】第30层紧凑498维测试准确率0.89、宏F1为0.81;原始稠密层表示为0.92/0.84。 表2、附录分层实验 ↗
我的解读我的解读:紧凑组保留了不少可读信息,但没有证明SAE比原表示更擅长词性判断。
来源证据【控制模板】受控词形实验微平均精度0.192、召回0.937、F1为0.318。 受控模板实验与附录 ↗
我的解读我的解读:广泛激活有利于召回,却难以给单个潜变量贴排他词性标签;词汇身份与上下文仍会混入。
来源证据【报告一致性】随机词型标签控制与真实标签有差距,但正文一处真实标签宏F1写0.97,与表2的0.78不一致。 控制任务段落、表2 ↗
我的解读我的解读:不引用这个冲突数字计算提升幅度;以明确条件的表格和控制实验判断证据。
开放情况与使用许可
官方仓库已有激活提取、探针、覆盖和控制分析实现;HF数据目录有train/test parquet但需人工审批访问,本站未下载受限数据。
LICENSE实现根LICENSE为MIT;Llama模型与GUM数据沿用各自上游条款,不能用MIT覆盖;论文原图许可见图注。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
以显式压缩规则、留出评估和词形控制约束可解释性主张,适合检查语言学类别是否形成分布式特征组。
反方 · 哪些结论还不够
高覆盖低排他性、词形和位置混杂,以及缺少因果干预,使结果不能直接变成可控语法模块。
综合判断
更适合作为语言表示审计工具;应把“信息可读出”与“模型靠它决策”分开。
我会先做的验证
未执行的验证方案:固定词汇分割并按词型留出,在多语言和不同层重复实验;对所选组与等大小随机组分别消融或激活,测词性敏感行为及非目标行为变化,而非只测探针。