FORK:让评分细则既奖励覆盖,也惩罚多余与错误
用句子级必要性和事实正确性,约束按rubric训练的回答膨胀
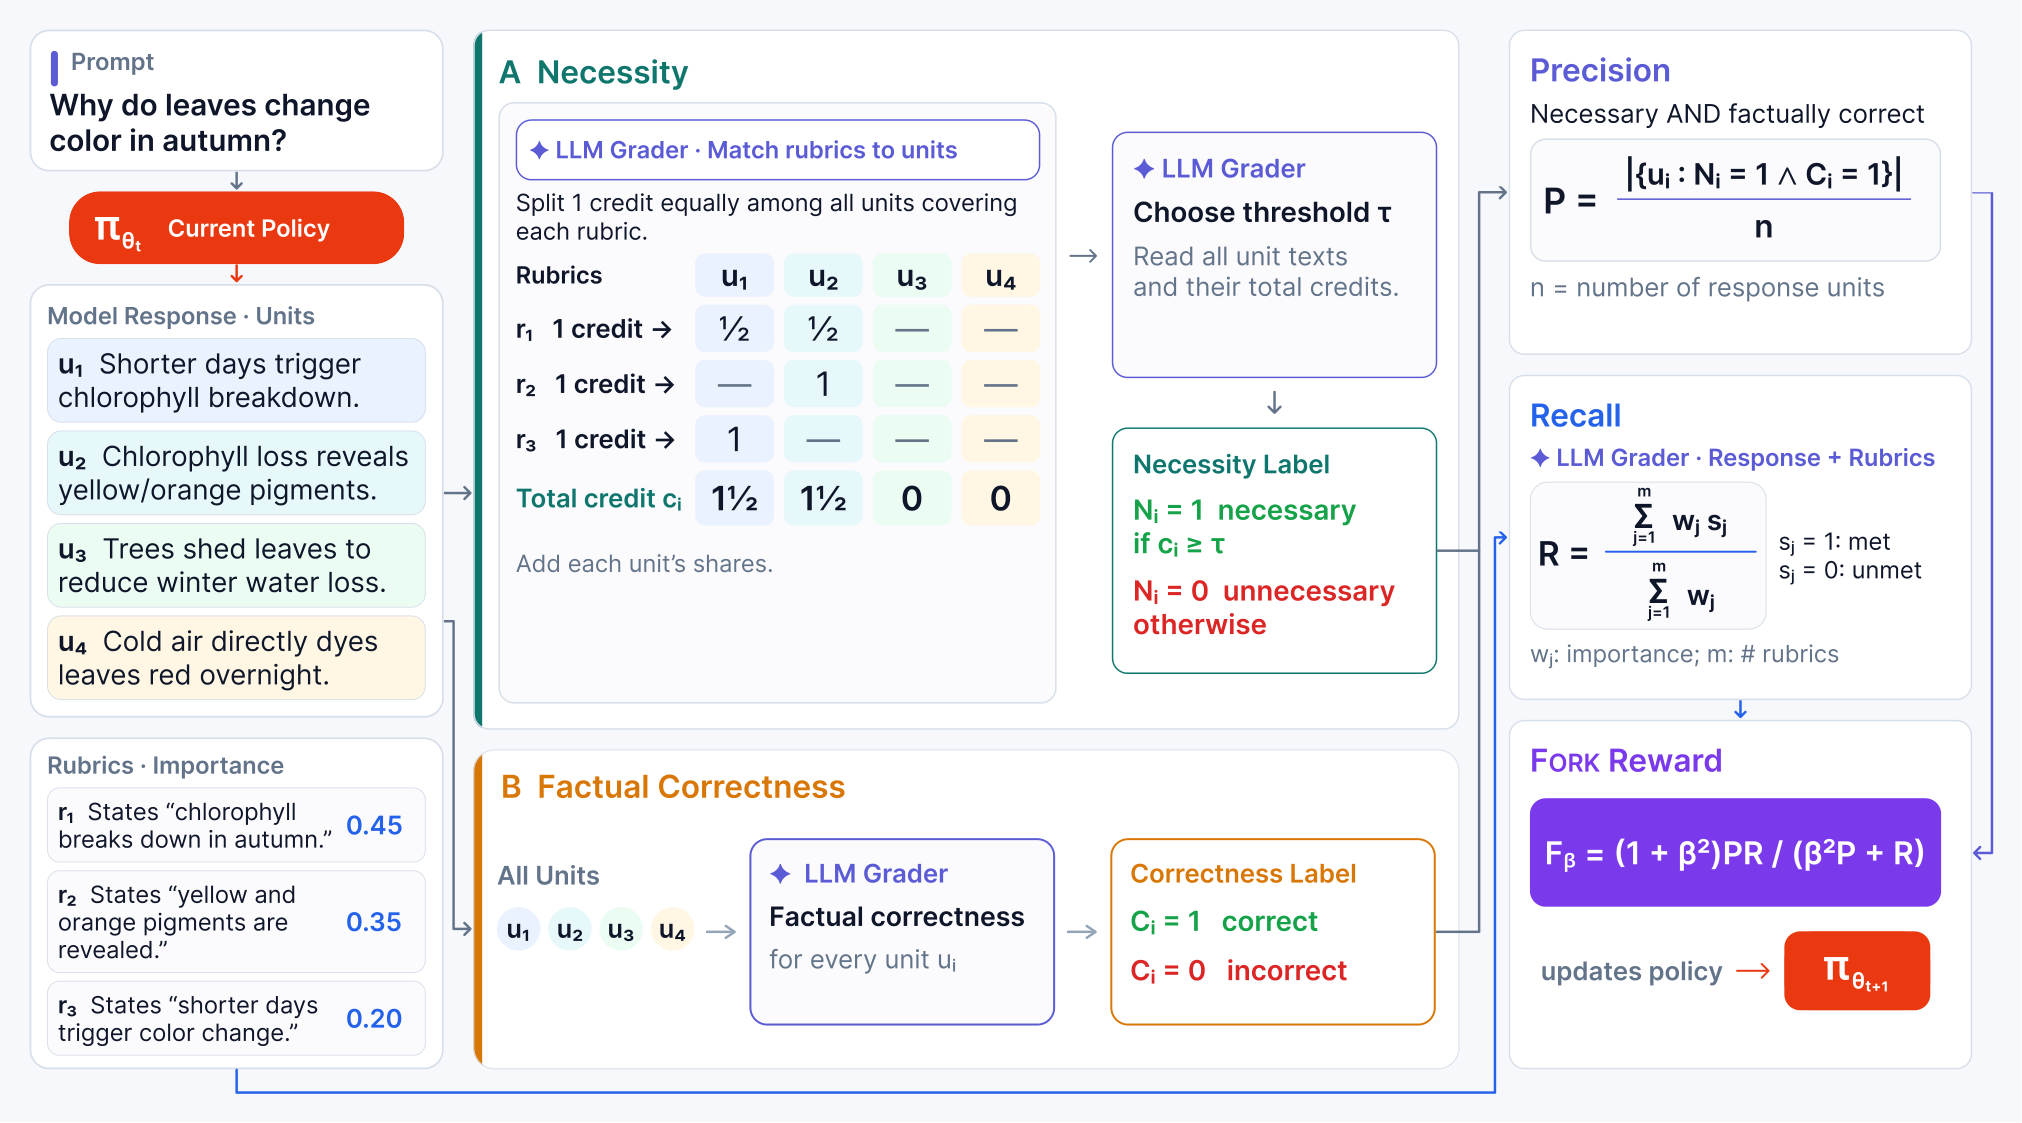
只按评分要点是否被覆盖给奖励,模型可以靠堆砌内容得分。FORK把回答拆成句子单位,分配rubric贡献,再分别判定必要性与正确性,将精确率和覆盖率的Fβ分数用于GRPO;重点不是简单限字,而是减少无用或不可靠的陈述。
图解主要方法
用句子级必要性和事实正确性,约束按rubric训练的回答膨胀
- 1
图2左:把回答拆成有上下文的单位
保留句子及原有标题语境,去掉纯组织性文本。评分器先判rubric是否满足,再把已满足条目映射到所有支撑它的句子;一条rubric的信用在匹配句子间均分,避免把同一要点反复说就反复得分。
- 2
图2中上:信用不是必要性的最终判决
必要性评分器根据问题与信用分布选阈值,并去掉重复的必要句。列表问题可以合理分散信用,简短问答则不应无限扩展。这里仍有模型判断,不是一个客观长度公式;附录提示要求区分语义新增与换说法。
- 3
图2中下:独立检查每个句子的正确性
另一路标注正确、错误、不确定或不可核查。精确率只计同时必要且正确的单位,避免一个相关但错误的句子被覆盖奖励保护;该判断来自训练评分模型,不是通过外部实验或临床审查逐句证实。
- 4
图2右:用Fβ平衡召回与精确
召回衡量rubric覆盖,精确衡量句子质量,两者通过Fβ调和后作为GRPO奖励。β较大更重覆盖;β=1和1.25必须分开报告。实验用Qwen2.5-7B、8张H100、16次采样和3轮训练,其中评分调用也占显著资源。
实验与证据
已阅读正文、方法实验附录A–C及关键评分提示,核对实验条件与原图;未独立复现。
来源证据FORK召回32.5、精确53.2、F1为37.5;标准奖励为35.7、25.5、26.4,平均长度由9,195降至3,533。对应偏好胜率为68.0对3.1。 表1:医疗域、β=1 ↗
我的解读精确度提升伴随覆盖下降。摘要出现的10.6是OnlineRubrics的胜率,不能当标准奖励数值;本稿按表格保留比较对象。
来源证据β=1.25医疗设置召回35.8、精确49.0、F1为38.6;HealthBench的β=1胜率74.1,而标准为7.1,召回25.2对25.9。 表6与域外评测:不同设置分开 ↗
我的解读增大β缓和覆盖损失,但不要把不同β的最佳指标拼成一行。偏好来自模型裁判,不代表临床有效性。
来源证据训练评分器的选择用40个回答,平均Pearson相关0.714,必要性项仅0.534。官方实现含奖励、数据构建、训练与评测,但明确不含全部其他基线和消融。 附录与官方仓库:复现范围 ↗
我的解读必要性判断是薄弱环节;应同时检查不在rubric里的有用信息是否被误删,不能只看篇幅缩短。
开放情况与使用许可
官方GitHub含src、configs、data和脚本,Apache-2.0;本次确认实现可见,未运行训练,未核实成品策略权重。仓库说明其他基线与消融不在本次发行范围。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:把“有没有回答要点”和“写出的每句话值不值得保留”分开,可直接诊断覆盖奖励的投机行为,组件也能嵌入既有训练管线。
反方 · 哪些结论还不够
事实与必要性由模型裁判决定,错误偏好可能被优化放大;rubric遗漏的有价值信息会受罚,胜率依赖裁判提示。论文部分正文混用β和基线数字,不能照抄笼统提升。
综合判断
适合有明确rubric的受控训练,暂不适合把自动精确率当成医学或科学事实审计的替代品。
我会先做的验证
未执行的验证方案:冻结训练token、采样数与评分预算,加入人工盲审的关键遗漏和有害新增标注;比较β=1/1.25、单纯长度惩罚及原奖励,报告每条有效事实的评分成本。