ProofGap:把数学证明拆成可验证的局部义务
单步能证明,不代表能独立完成整道题;发布数据与论文规模也不同
ProofGap把数学分析教材解答中的中间结论变成带局部假设的证明任务,用Lean或受限DSL验证。它能定位整题分数掩盖的推理短板,但每一步获赠前序结论,不能把单步成功率当成端到端证明能力;当前仓库数据规模也与论文表格不同。
图解主要方法
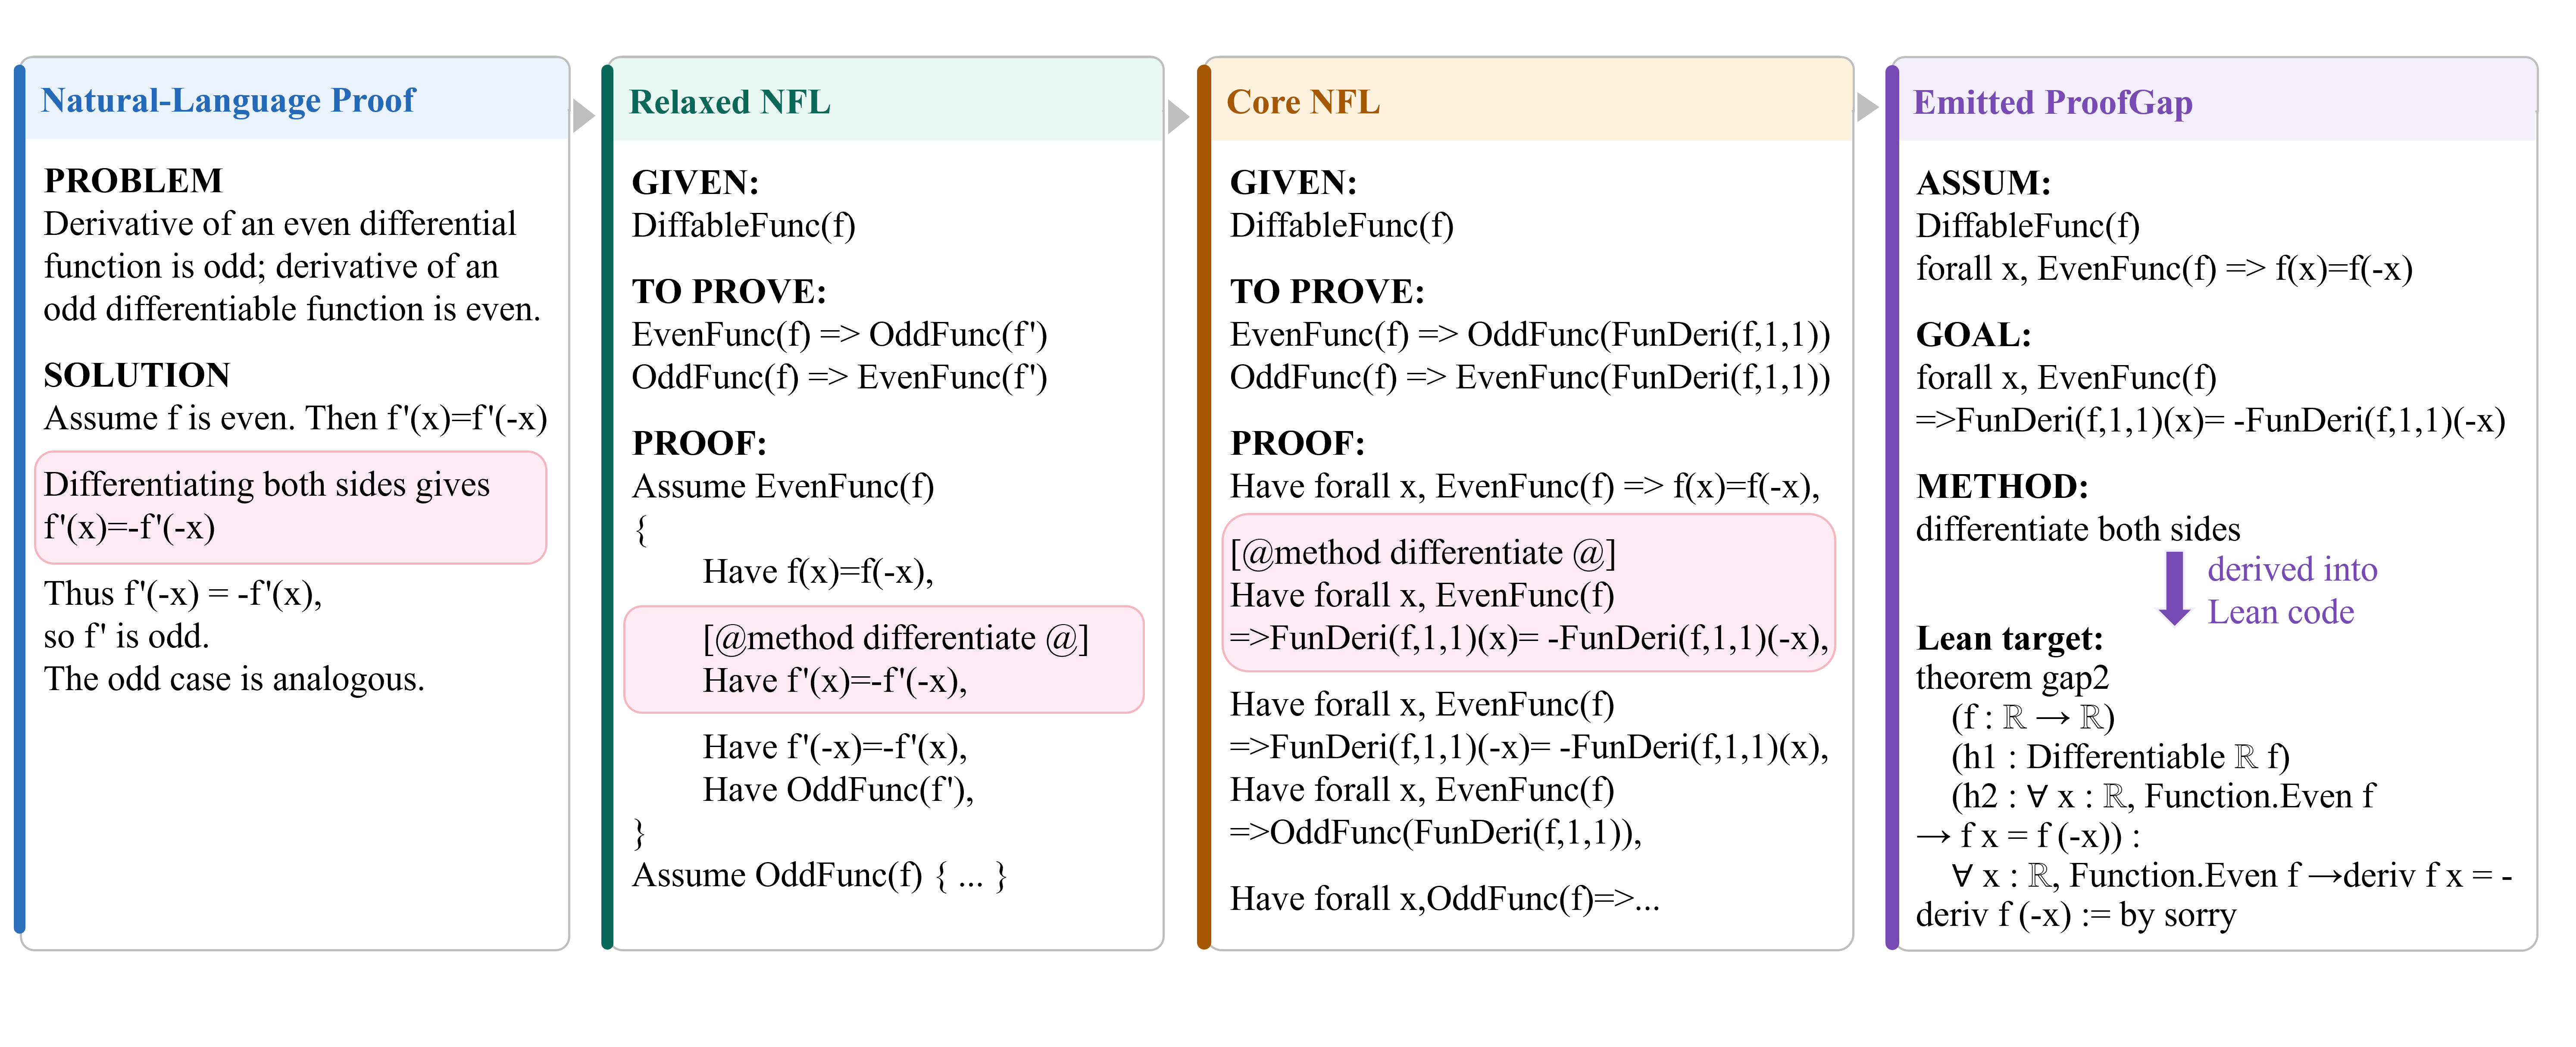
图1如何从自然语言解答走到局部形式化目标,哪些信息已经由数据构造者提供?
- 1
先保存作用域,再规范数学记号
图左把解答解析为宽松自然形式语言RNFL,保留假设、量词、变量绑定和证明结构,再规范到CoreNFL。以偶函数导数为例,形式参数及求导变量必须明确;语法可解析不等于原中文含义已完全保真。
- 2
从语法树提取独立证明缺口
对前向推导、反向目标和子目标生成Γ、目标g及方法标签m。前面步骤的中间结论被直接放入局部假设,不要求模型先证明它们;方法标签用于组织,不作为模型输入。因此每个缺口测的是条件化局部义务。
- 3
分别接入Lean与轻量DSL验证
Lean由转换模型形式化,结合交叉检查和人工复核疑点;DSL有18种命令和514条定理,要求可重放。Lean拒绝sorry、依赖链中的未证假设和逃逸机制,但内核通过只能保证形式命题,不会自动证明其忠实对应教材。
- 4
同时报告缺口与整题覆盖
Lean每题生成8候选、最多8192token、温度0.6,固定Lean4.29rc6及mathlib。整题分数要求该题各缺口都成功;每个缺口分别获得预算,所以这个整题汇总仍不同于同总预算从头写一份完整证明。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【论文规模】3015道题、26116个缺口;DSL自动解2838个,再由agent补4889个,共7727个已验证参考解。 数据构造、验证与附录 ↗
我的解读我的解读:其余缺口未解不等于命题为假,也不能说全部任务已有参考证明。
来源证据【模型结果】三种证明专用模型的缺口成功率约31.99%–35.39%,整题仅2.92%–4.28%;280缺口子集里两通用模型均87.86%,整题仍为21.43%与13.93%。 主结果、280缺口分层子集 ↗
我的解读我的解读:局部高分掩盖长证明的串联困难;子集结果不能和全量直接排统一榜。
来源证据【发布差异】09-30实际仓库README写2947题、25987缺口、9385个DSL答案,Lean后端与LLM转换分两组。 作者仓库README;与论文表格对读 ↗
我的解读我的解读:公开版本有实质范围差异;复现应锁定提交及清单,不能宣称下载即获得论文完全相同数据。
开放情况与使用许可
已核实仓库含NFL缺口、DSL参考答案、Lean模块和验证入口;平台验证器以二进制形式分发,不能等同完整验证器源码公开。公开数据规模与论文不同,详见实验对读。
LICENSE仓库未见根LICENSE,代码、验证器与教材衍生数据的再利用授权未确认;论文为CC BY 4.0,不自动覆盖仓库全部材料。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把自然语言证明中的局部义务和验证路径显式化,适合诊断形式推理究竟在哪一步失败。
反方 · 哪些结论还不够
给定前序结论、翻译语义风险、分步预算与发布版本差异,限制端到端能力及可复现性的推断。
综合判断
可作为证明系统的故障定位基准,整题独立完成、错误步骤检测和自动形式化仍须单独评测。
我会先做的验证
未执行的验证方案:固定公开提交与题目清单,对照独立缺口、依赖前步结果的顺序证明、整题等总token预算;人工抽查原文与Lean语义一致性,分开报告格式失败、证明失败和翻译错误。