R-Quest:自我进化先问“题目成立吗、是否只换了说法”
有效性与结构新颖性抑制十轮退化;初始化仍用了外部强模型和人工核验
R-Quest 发现自生成数学题会逐渐变得无效或重复,而中等答案一致性筛选甚至偏向无效题。它先教解题器识别题目缺陷,再让有效性和冻结基础模型的题型比较共同约束出题奖励。Qwen3-4B的十轮实验避免R-Zero式退化,但并非无外部知识、无限自我提升或每个测试都更好。
图解主要方法
为什么自问自答会越练越差,检查问题本身能否阻止训练闭环退化?
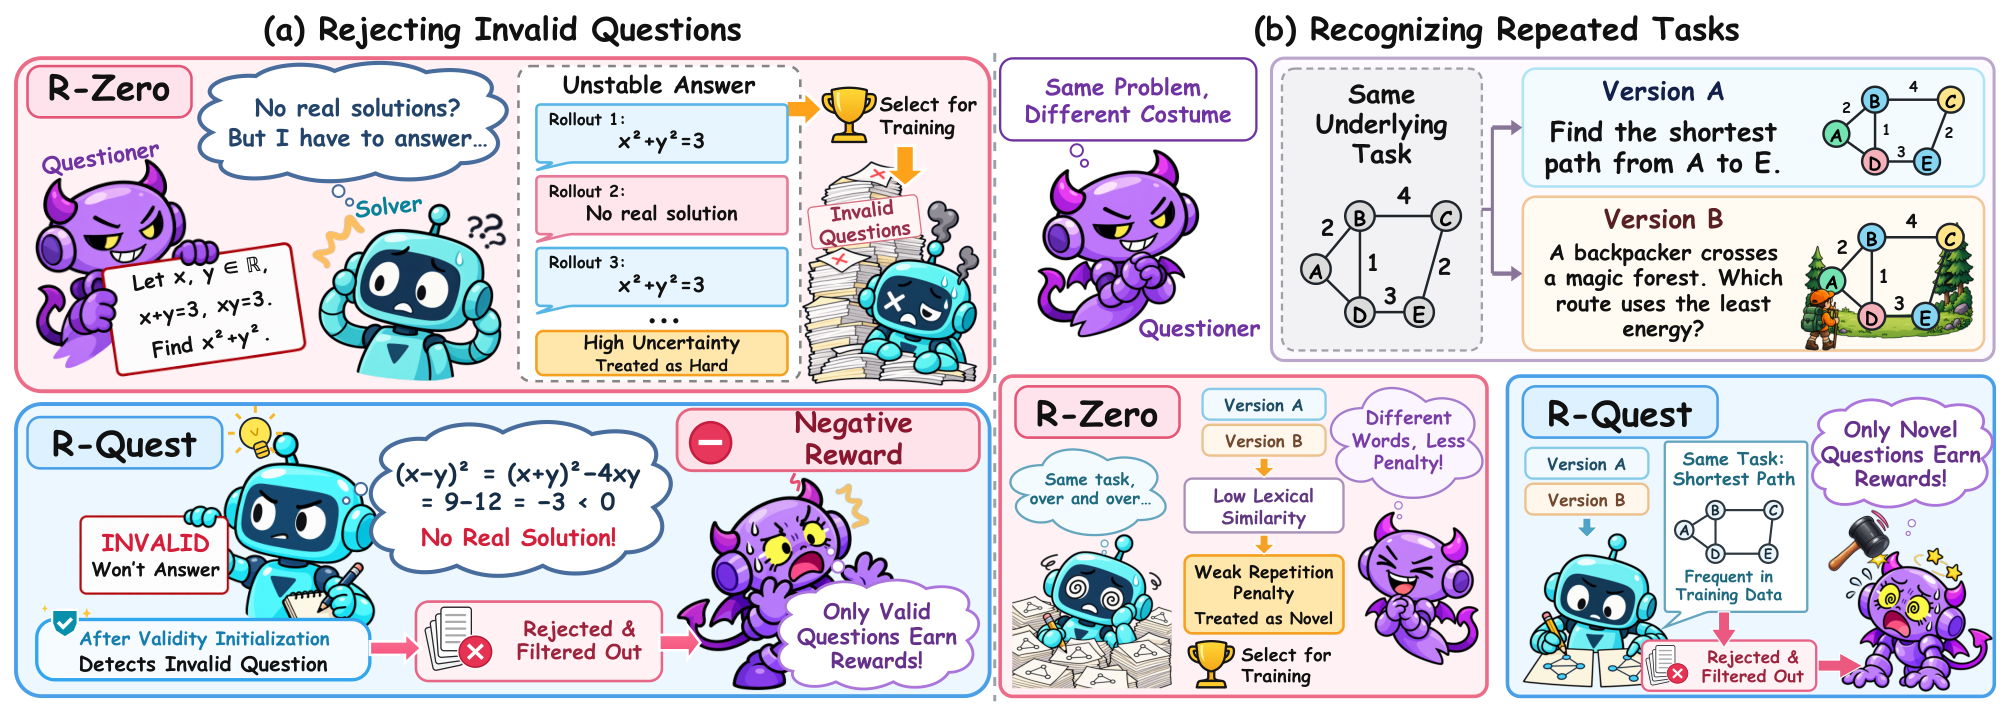
- 1
先教解题器识别题目缺陷
从R-Zero前五轮抽题去重,强模型判题与独立作答,再检查冲突,未解决者排除或人工复审。1943训练题做15步GRPO,正确答/拒绝+1,误拒有效题−0.5,缺空答案−0.1;这一步不是无外部监督。
- 2
为每题投票有效性
解题器9次响应尝试解题并判断缺陷,过半INVALID才拒绝;拒绝题出题奖励0.5−无效率,为负。通过后重新采10个数学解,不复用判题回答,计算最大答案簇比例。
- 3
按数学任务结构抽样查重
冻结同一基础模型,对每个候选与当前批8道其他题比较;任何一对同型便关新颖性门。精确通过概率是无放回超几何,近似(1−同型比例)^8;不等于穷尽去重或全历史新颖性保证。
- 4
只给通过题适中难度奖励
有效且新颖的题获得min(s,1−s),重复题为0;出题器按GRPO更新。题型只是措辞或数字改变仍可重复,共享宽泛数学领域则不够判重复。
- 5
答案自投票训练并回放判题能力
筛选答案一致性0.3–0.8且多数答案非空的题,用多数答案作伪标签;混入10%初始化数据维护拒绝能力。出题器每轮5步、解题器15步交替,但多数答案仍可能共同错误。
实验与证据
v1全文70962字符及附录A–F完整阅读,v2正文逐段差异核对一致;原图2、仓库实现树/LICENSE、HF权重模型卡与数据文件清单实际核验。
来源证据诊断每轮抽200题,R-Zero第一到第五轮有效率76.5→39.5%,第五轮一致性筛后27.64%。 2.2.1;图3 ↗
我的解读难题与坏题都可能产生答案分歧,简单中等一致性筛选不能代替题目有效性。
来源证据原始与修复各1273题,共享766有效题,507题替换为修复版本;最终数学均值46.54→49.91。 图3b ↗
我的解读控制了题量和多数内容,但修复仍可能改变难度,支持部分因果贡献而非唯一退化原因。
来源证据初始化1943训练题=802有效+1141无效,297验证题=121+176;类别F无法可靠判断也归无效。 附录A ↗
我的解读标注方案带保守拒绝偏好,需要与真正矛盾、信息缺失区分。
来源证据五轮内按各域最佳检查点:Qwen数学51.64对R-Zero49.10、基础46.17;Octo30.69对28.25、24.90。 表1、9 ↗
我的解读是七个基准平均,不是所有单项领先;表中还有平局或消融更优项目。
来源证据Qwen第十轮51.92,R-Zero34.60,差17.32pp;基础46.17,对基础+5.75pp。 图1、5 ↗
我的解读大差距含对照退化11.57pp,不应宣传为自身从基础提升17.32pp。
来源证据代码Qwen62.69对基础58.79,通用32.75对28.79;AMC/AIME为mean@32,其他推理贪心,代码EvalPlus贪心pass@1。 表2;附录E ↗
我的解读不同域不同指标且各自选最佳轮次,不能当作同一模型单次采样统一总分。
来源证据第十轮有效性平衡准确率72.93%,无效召回86.36%;有效题多数答案准确率R-Quest54.69%、R-Zero2.06%。 4.3.2;图6 ↗
我的解读即使改善后近半有效题多数答案仍不正确;validity不是答案正确保证。
来源证据第五轮前五题型占比R-Zero69%、R-Quest K8为24%;K16第四轮进一步降30→16.8%,但数学表现低于K8。 图7;附录B ↗
我的解读多样性不是越强越好;200条样本三种随机顺序衡量聚类稳定,不是三次独立训练。
来源证据每轮10000候选,OCNR按其设计20000;9判题+10新解+K8判断,默认训练配置4×80GB。 4.1;附录C/D;仓库README ↗
我的解读算力成本和额外初始化/模型调用需要一起比较,本文没有给出等总token成本结论。
开放情况与使用许可
GitHub实际含训练、有效性/新颖性奖励、配置和评估实现,Apache-2.0。HF公开两个safetensors分片的15步Validity-RL初始化权重,不是第十轮最终模型;训练/验证JSONL可见但数据卡无license字段、树无LICENSE。
LICENSE论文/图2 CC BY 4.0;代码及初始化模型卡Apache-2.0。数据可下载但许可未明确,不能将代码许可扩展到数据。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
匹配1273题的原始/修复对照,较直接支持题目缺陷会影响后续训练。
有效性和新颖性消融、冻结判断器对照及K强度变化,解释了方法为何需要平衡。
发布可执行训练代码、初始化权重和审计数据,比只给伪代码更利于复核。
反方 · 哪些结论还不够
17.32pp是第十轮对已退化R-Zero的优势;相对基础模型提升5.75pp,五轮最佳对R-Zero仅2.54pp,分母不能混用。
每领域挑测试基准平均最高的轮次,领域分数可能来自不同检查点,也存在选择乐观偏差。
初始化判题将“无法可靠判断”也映射INVALID,可能把困难题误作坏题;第十轮有效性平衡准确率72.93%仍有明显误差。
每题9次判有效、10次新解和8次题型对比,候选数量相近不等于计算预算相等。
综合判断
证据支持对题目有效性和语义重复的控制可缓解有限轮次的自训练退化;它是经外部初始化的自生成训练方案,尚非无需外部锚点的持续自主进化。
我会先做的验证
建议实验(尚未执行):固定总推理token与GPU时长、多种子重复十轮,使用独立验证集选检查点;人工盲审有效/无效混淆,分离初始化、10%回放与动态判题贡献,增加跨批语义记忆并检查难度是否被过度过滤。