Qwen3.8-Next:混合注意力、门控残差与主机侧容量
回顾独立架构报告:125B、激活 6B,另有 51B n-gram 容量
这份架构报告研究如何同时降低长上下文成本并稳定大规模训练:三层 Gated DeltaNet 搭配一层 Qwen Sparse Attention,门控残差控制读写,另将 n-gram 容量放到主机内存。它与已收录的通用 Qwen3.8 发布不是同一项工作。
图解主要方法
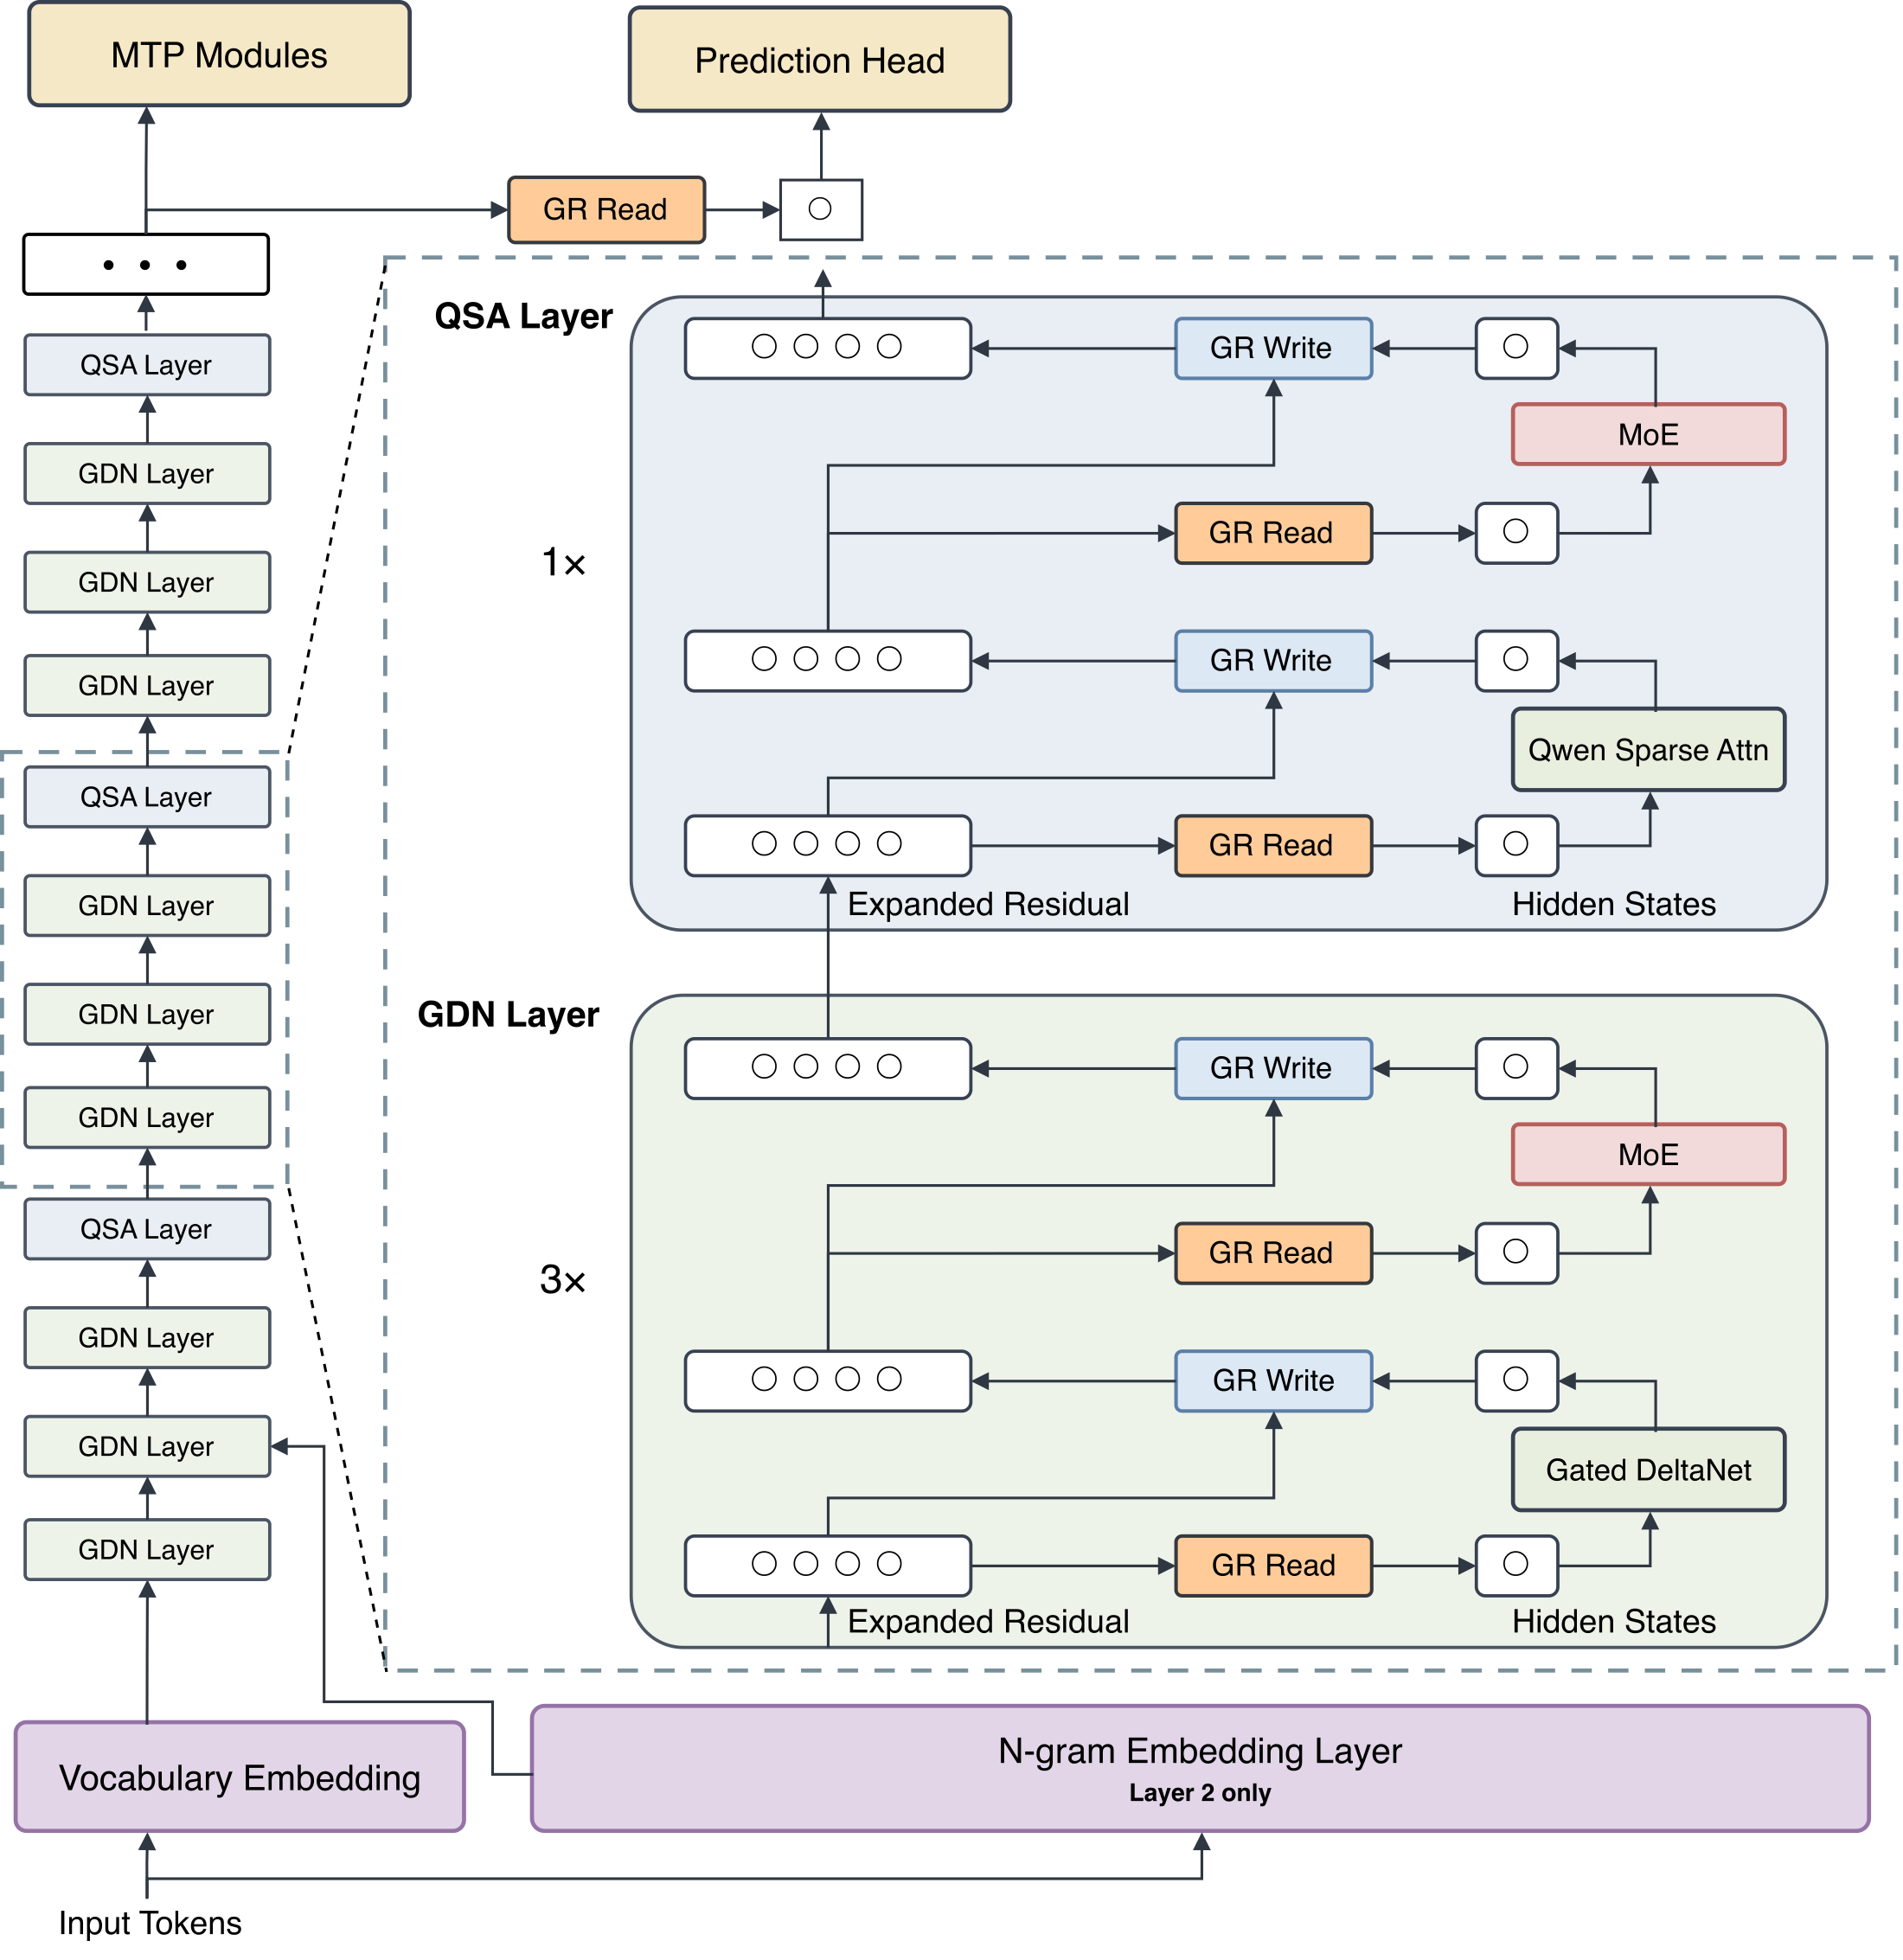
图 1 中循环状态、稀疏注意力、残差通道和主机嵌入分别解决什么问题?
- 1
用循环状态承接大部分 token mixing
图左每四层中三层为 GDN:衰减门与写入门更新快速权重状态,查询从压缩状态读取信息。它减少历史逐词注意力的成本,但固定容量状态不能无损保存任意长历史,所以保留周期性的 QSA 层检索细节。
- 2
让 QSA 先选块,再执行细粒度稀疏注意力
索引器对因果完整块先池化再施加位置编码,选取高分块展开为 micro-block 稀疏掩码。报告的长上下文继续预训练使用压缩比 4、K=2048,并保留近端尾部;先做约 2B token 索引器蒸馏,再联合训练约 200B token 至 256K。索引器仍有 O(n²/r) 部分,不能把整体描述成严格线性。
- 3
在扩宽残差上控制读取与写回
图右 GR 使用四条残差分支,对读取进行归一化与逐元素门控,再控制子层输出写回;它不等于增加一个独立外部记忆。FP8 残差存储针对扩宽流的成本,不代表所有运算一律 FP8。局部门控实验显示稳定性与平均分的收益大小也不同。
- 4
将额外容量移到主机,并匹配优化器预算
图底第二层接入哈希 n-gram 嵌入,通过预取利用主机内存中的约 51B 参数。主体为 125B、每 token 激活约 6B;不能把主机容量漏掉。Muon 的 Newton–Schulz 迭代、分头处理与 Canzona 调度改善训练吞吐,路由器、输出头、GR 和 n-gram 又使用不同优化器设置。
- 5
把内核速度与完整模型效果分开
MTP 复用 QSA 索引支持推测解码,但内核基准不包括所有通信、主机预取和服务调度。架构、训练 token 数与优化器共同改变,因此“训练算力更少”不能单独归功于某个注意力模块。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【基础模型对比】报告在 14 项基础评测中有 8 项超过 397B-A17B 对照,训练 FLOPs 约为其九分之一;训练 token 数也约为三分之一。 整体效果表与预训练评测说明 ↗
我的解读我的解读:支持组合设计的效率,但不是固定数据和预算下仅替换架构的因果消融。SWE-Bench-Pretrain 使用补丁相似度,不是实际通过测试的 resolved rate。
来源证据【长上下文与速度】1M 条件下报告内核 prefill 7.6 倍、decode 4.9 倍加速;MRCR 为 26.44,对照 20.71。 长上下文与内核效率实验 ↗
我的解读我的解读:内核倍数不能直接当作用户端吞吐;更高的 MRCR 仍不意味着超长检索可靠或所有任务支持同等长度。
来源证据【门控与稳定性】一组 GR 动态设计平均分为 54.66,对照 54.47;压力实验中 loss spikes 从每万步 32 次降至 3.2 次。 GR 消融及训练稳定性附录 ↗
我的解读我的解读:平均能力提升较小,训练稳定性更值得关注。实验仍配置 0.5 梯度裁剪,只是在所示运行中未触发;取消 batch warmup 也不等于取消学习率 warmup。
开放情况与使用许可
08-31 首发报告,今日回顾补收。已核实 FlashQLA 具有 GDN 内核、基准和测试代码;它是一个组件,不等于本报告完整模型、训练流水线或全部权重公开。
LICENSEFlashQLA LICENSE 为 MIT;未核实本报告完整模型权重许可。论文 arXiv 非独占分发许可不等于图片开放许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
报告把残差、注意力、优化器和内存放在同一训练系统中讨论,能帮助解释效率从哪里来、代价转移到哪里。
反方 · 哪些结论还不够
组合训练方案与数据量共同变化,内核指标不是端到端收益;51B 主机嵌入、带宽及复杂部署依赖不能省略。
综合判断
适合做架构与训练系统研究参考;是否适合自己的长任务服务,要以完整部署的质量、内存和延迟实测决定。
我会先做的验证
未执行的验证方案:在固定 token、总 FLOPs 与数据顺序下逐项消融 GDN/QSA、GR、n-gram 和优化器,并计入主机 RAM、PCIe 传输、TTFT、逐 token 延迟及长任务成功率。