模型已经学会,输出层却还没跟上?沿训练轨迹拆开表征与表达
同一个隐藏状态换一个读出器,能否解释早期能力评测的变化?
论文将最终隐藏状态中的可解码信息、模型原生输出和跨检查点读出扫描分开测量,再以参数轨迹稀疏字典追踪输出矩阵。主张是早期评测存在读出层滞后,不是已经找到通用能力增强算法。
图解主要方法
同一个隐藏状态换一个读出器,能否解释早期能力评测的变化?
- 1
固定隐藏状态,分开三种测量
先保留某检查点的最终归一化隐藏状态,分别接原生输出矩阵、监督训练的线性探针,以及其他检查点的输出矩阵。探针用了任务标签;主实验的最佳读出器又是在看完评分后选择的上包络,两者都不是可直接部署的无监督能力。
- 2
用词表行对齐参数轨迹
每个检查点的输出矩阵减去词表均值并按均方根缩放,以相同 token 行连接32个检查点。跨检查点共享稀疏编码、各自使用解码器,门控由编码与解码器范数共同决定,因而追踪的是共同字典中的贡献轨迹,并非天然唯一的语义单元。
- 3
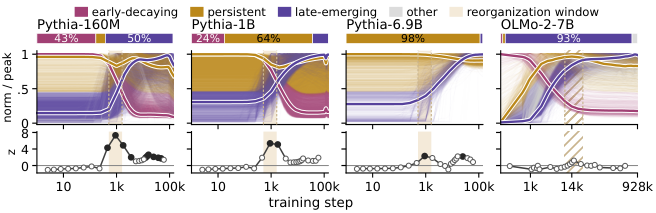
把图2的变化窗口与因果编辑区分
图2每条曲线除以自身峰值,曲线高度不能跨特征比大小;六种结构变化量组成重组分数并与循环移位空模型比较。另在固定的 Pythia-1B 第1000步隐藏状态上,删去或只保留8个高归因特征,定位特定主谓一致边际。
- 4
单独改变读出器学习率
31M模型共享初始化和数据顺序,比较0.25、1、4倍输出层学习率与减半预热。每条件只有一次预训练,三个字典拟合种子不等于三个模型训练种子;改变训练学习率也会连带改变隐藏状态。
实验与证据
已阅读正文及附录A–I,核对实验条件与原图;未独立复现。
来源证据Pythia三种规模的重组窗口都落在512–约1621步;21种字典拟合中20种选此窗。OLMo-2-7B对应窗口的空模型检验p=0.12,并未分离。词形分组后160M词义类别最终中位准确率由行切分的0.874降为0.841。 正文4.1、附录C–E;图2 ↗
我的解读早期窗口较稳,但不同架构普遍同相变以及词表类别完全泛化,都超出证据。
来源证据固定早期状态与重构终态读出器的SVA准确率0.900,删8特征降0.487,仅留8特征为0.938,符号与范数等匹配的删除对照为0.931;终态读出器替换原生矩阵的增益在Procrustes对齐后明显减弱。 正文4.3–4.4、附录F–G ↗
我的解读因果证据限于这个重构矩阵与二选一任务配置。词表完整生成、其他任务和上游电路不能由此推定;部分数字任务初始化探针已很高。
来源证据4倍学习率在约0.27B token时验证损失比基线低1.20 nats;10B token停止时四条件损失相差不超过0.06 nats。此时学习率仍近峰值,读出层约占31M模型参数42%。 正文4.5、附录H ↗
我的解读支持早期收敛时序变化,尚不能证明大模型最终训练质量提高,也不是最终收敛比较。
开放情况与使用许可
已核对官方仓库存在训练、评估与复现代码,LICENSE为MIT;Hugging Face字典仓库可访问且包含实际文件。论文原图CC BY 4.0;上游模型和数据各自条款继续适用,未下载或运行权重。
LICENSE论文与原图 CC BY 4.0;代码 MIT
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把输出读数本身作为变化中的测量装置,有助于避免将早期 logits 的变化全部归因于隐藏层突然获得能力。
反方 · 哪些结论还不够
探针监督、事后读出扫描、词形泄漏和输出坐标系都影响结论;干预只有31M单次训练,较大模型的读出层占比不同。九语言换读出器的总损失收益主要来自非英语,英语不能套用总体收益。
综合判断
适合加入训练诊断仪表盘,同时保留原生输出、初始化探针基线和受控读出替换;暂不作为能力涌现或安全能力的独立判据。
我会先做的验证
未执行的验证方案:在更大模型上使用多个预训练种子,预先固定读出选择规则;按词元和文档严格隔离探针训练测试,分别报告完整词表生成、各语言损失、成本及最终收敛结果。