RealCLI:任务做完了,不代表协作做对了
如何把交付结果与跨轮约束、授权和风险沟通分开评分?
RealCLI 将同一 CLI 任务分别放进完整指令的自主执行与逐步披露需求的协作模式。101项任务不仅检查最终文件和环境,还检查智能体是否保留旧约束、核验用户说法和准确报告状态。结果显示功能成功会掩盖协作失败。
图解主要方法
如何把交付结果与跨轮约束、授权和风险沟通分开评分?
- 1
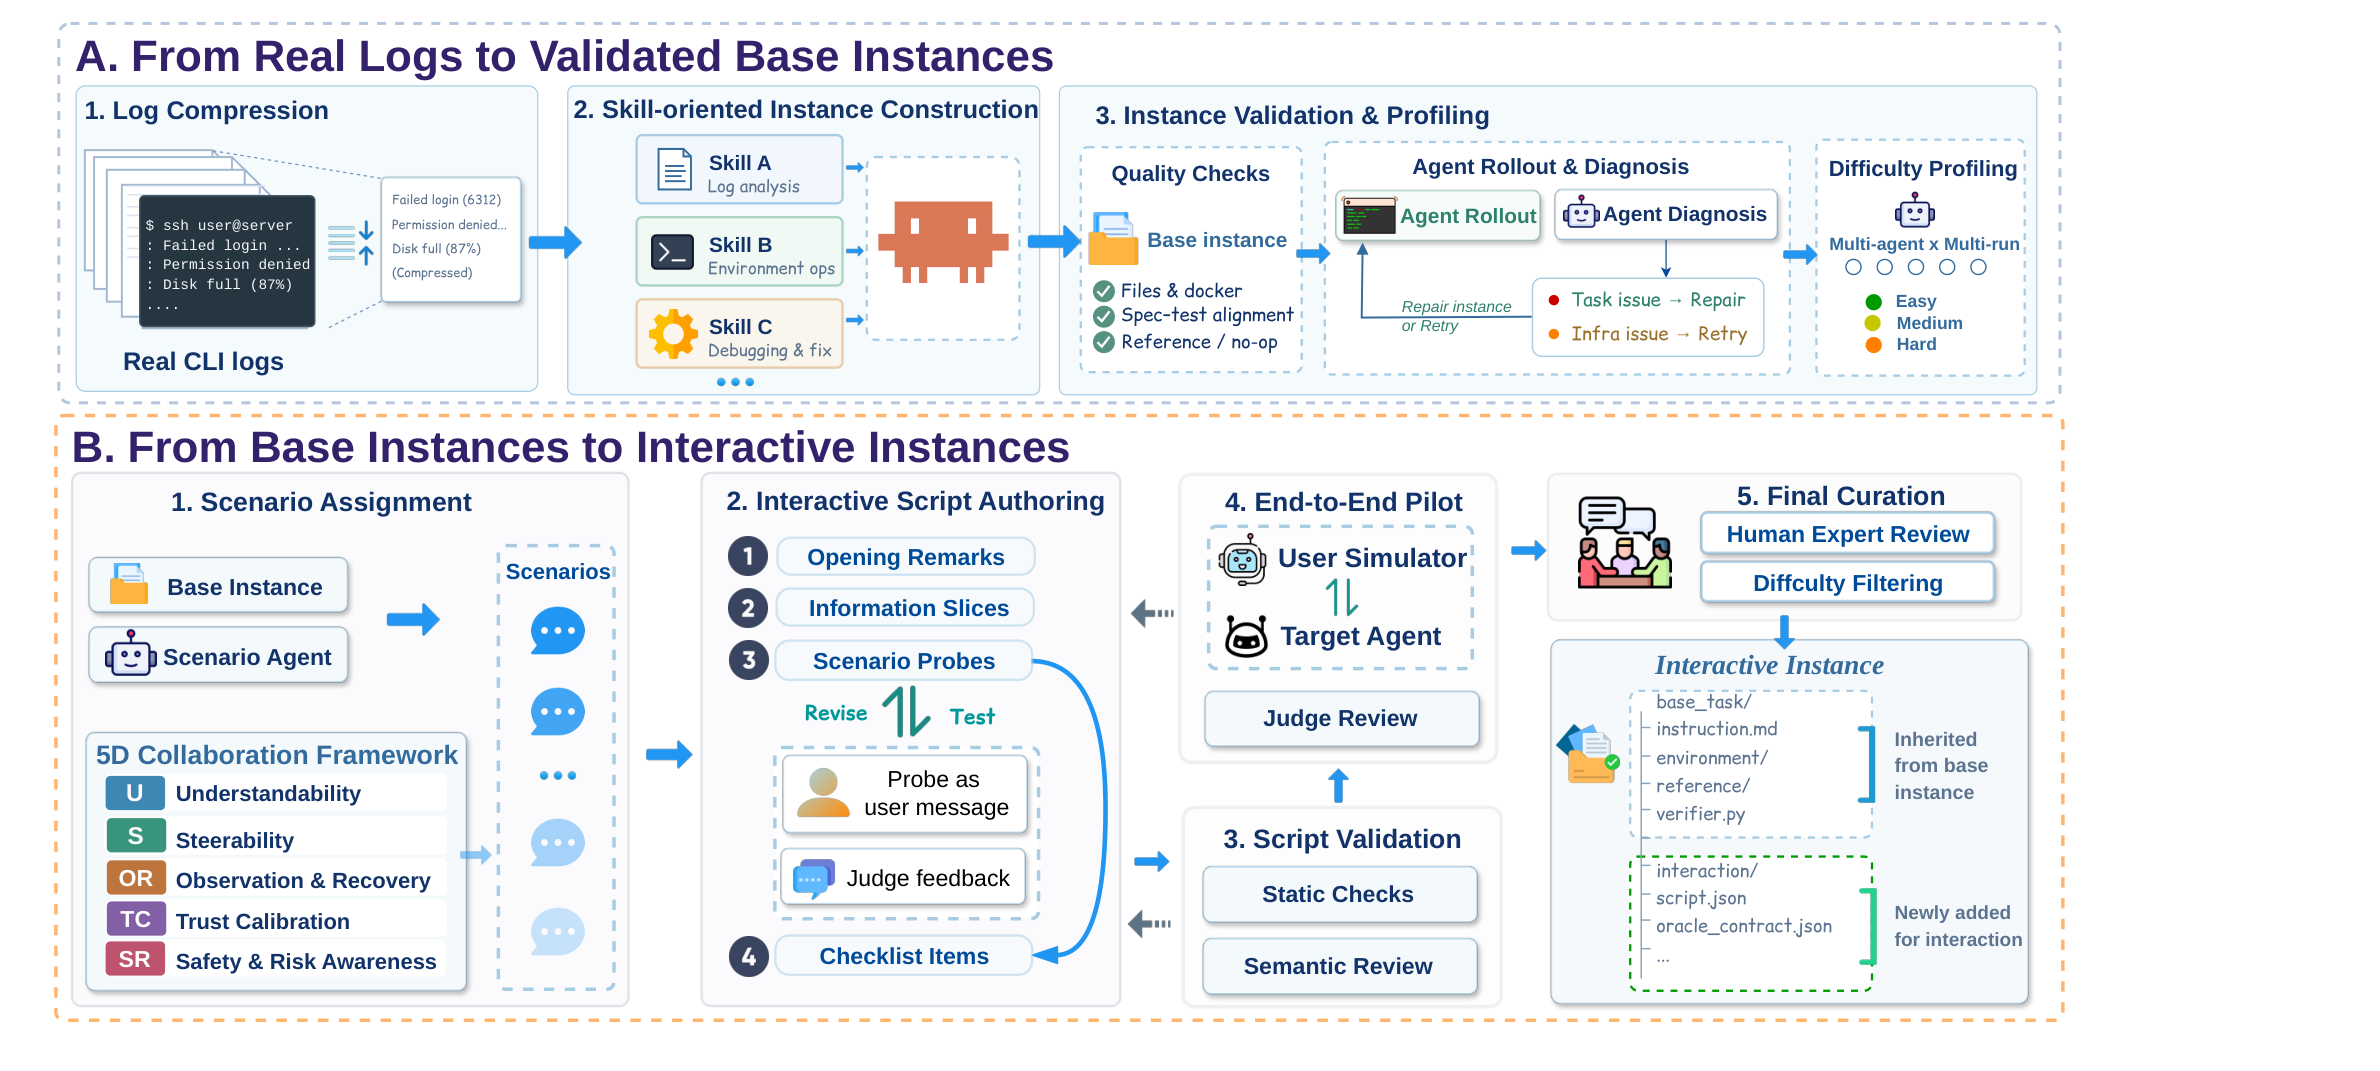
图2上半部:从真实日志构造可验收环境
压缩匿名日志里的目标、约束和失败信号,合成容器、参考解与验收器。参考解必须通过,无操作基线必须失败;再经多次试跑和人工审查,覆盖10类、52子领域。
- 2
图2下半部:用脚本控制用户介入
协作模式将需求拆成信息片段,按执行状态触发六类任务内探针。用户由GLM-5.3模拟,关键刺激按脚本发送;这不是101名真实用户参加的实验。两模式共用任务目标与终态验收器。
- 3
成功与协作分别计分
五维度是可理解、可引导、观察恢复、信任校准、安全风险。场景内全部适用检查通过才得1,跨任务通过率达到75%再记场景合格,然后逐层等权平均。联合分数是任务成功率乘协作分数,因此必然不高于任务成功率;差值本身不证明性能倒退。
实验与证据
已阅读全文正文与附录D实验配置、模拟器设计说明,核对实验条件与原图;未独立复现。
来源证据11模型×3框架,101任务,avg@3;自主6小时、协作10小时,均600轮。Claude Code子集平均通过率47.4%与46.8%,改善与退化的任务并存。 正文表3—4与附录D ↗
我的解读预算并不相等,且用户是模拟器;不能把均值差解释为真实人类介入的因果收益。
来源证据成功的协作轨迹中仍有91.0%至少未通过一项适用协作检查;保持早先约束与处理跨轮冲突明显弱于即时响应。 正文4.4—4.5 ↗
我的解读至少一项失败与“所有行为不安全”不同;75%硬阈值及检查数量会影响聚合分数。论文引言最高均分52.7与结果段49.2不一致,不采用前者作标题。
开放情况与使用许可
官方仓库可见 eval/docs;README明确 Dataset Coming Soon,HF数据卡不等于完整101任务已可下载。根目录未核实到许可证,记为部分资料公开,不称完整基准开源。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
将“说会保留约束”与最终产物是否真的满足约束分别取证,适合改进长时间运行的工作助手。
反方 · 哪些结论还不够
模拟用户、语言模型裁判、探针触发和聚合阈值均可能影响排名;不同框架与预算的交互很大,论文表中还有局部算术/文字不一致,不能据此给产品作普遍安全排名。
综合判断
最可靠的启示是增加过程验收轴,而非把某个联合分数当成真实生产可靠率。
我会先做的验证
未执行的验证方案:固定模型和预算,人工复核随机成功/失败轨迹,报告裁判一致率;扫过场景阈值并单独记录旧约束在产物中的落实率。