SSR:在同一推理前缀下,学会拒绝少数低价值续写
首个可分辨退化点监督LoRA门控;不等于证明该步逻辑错误
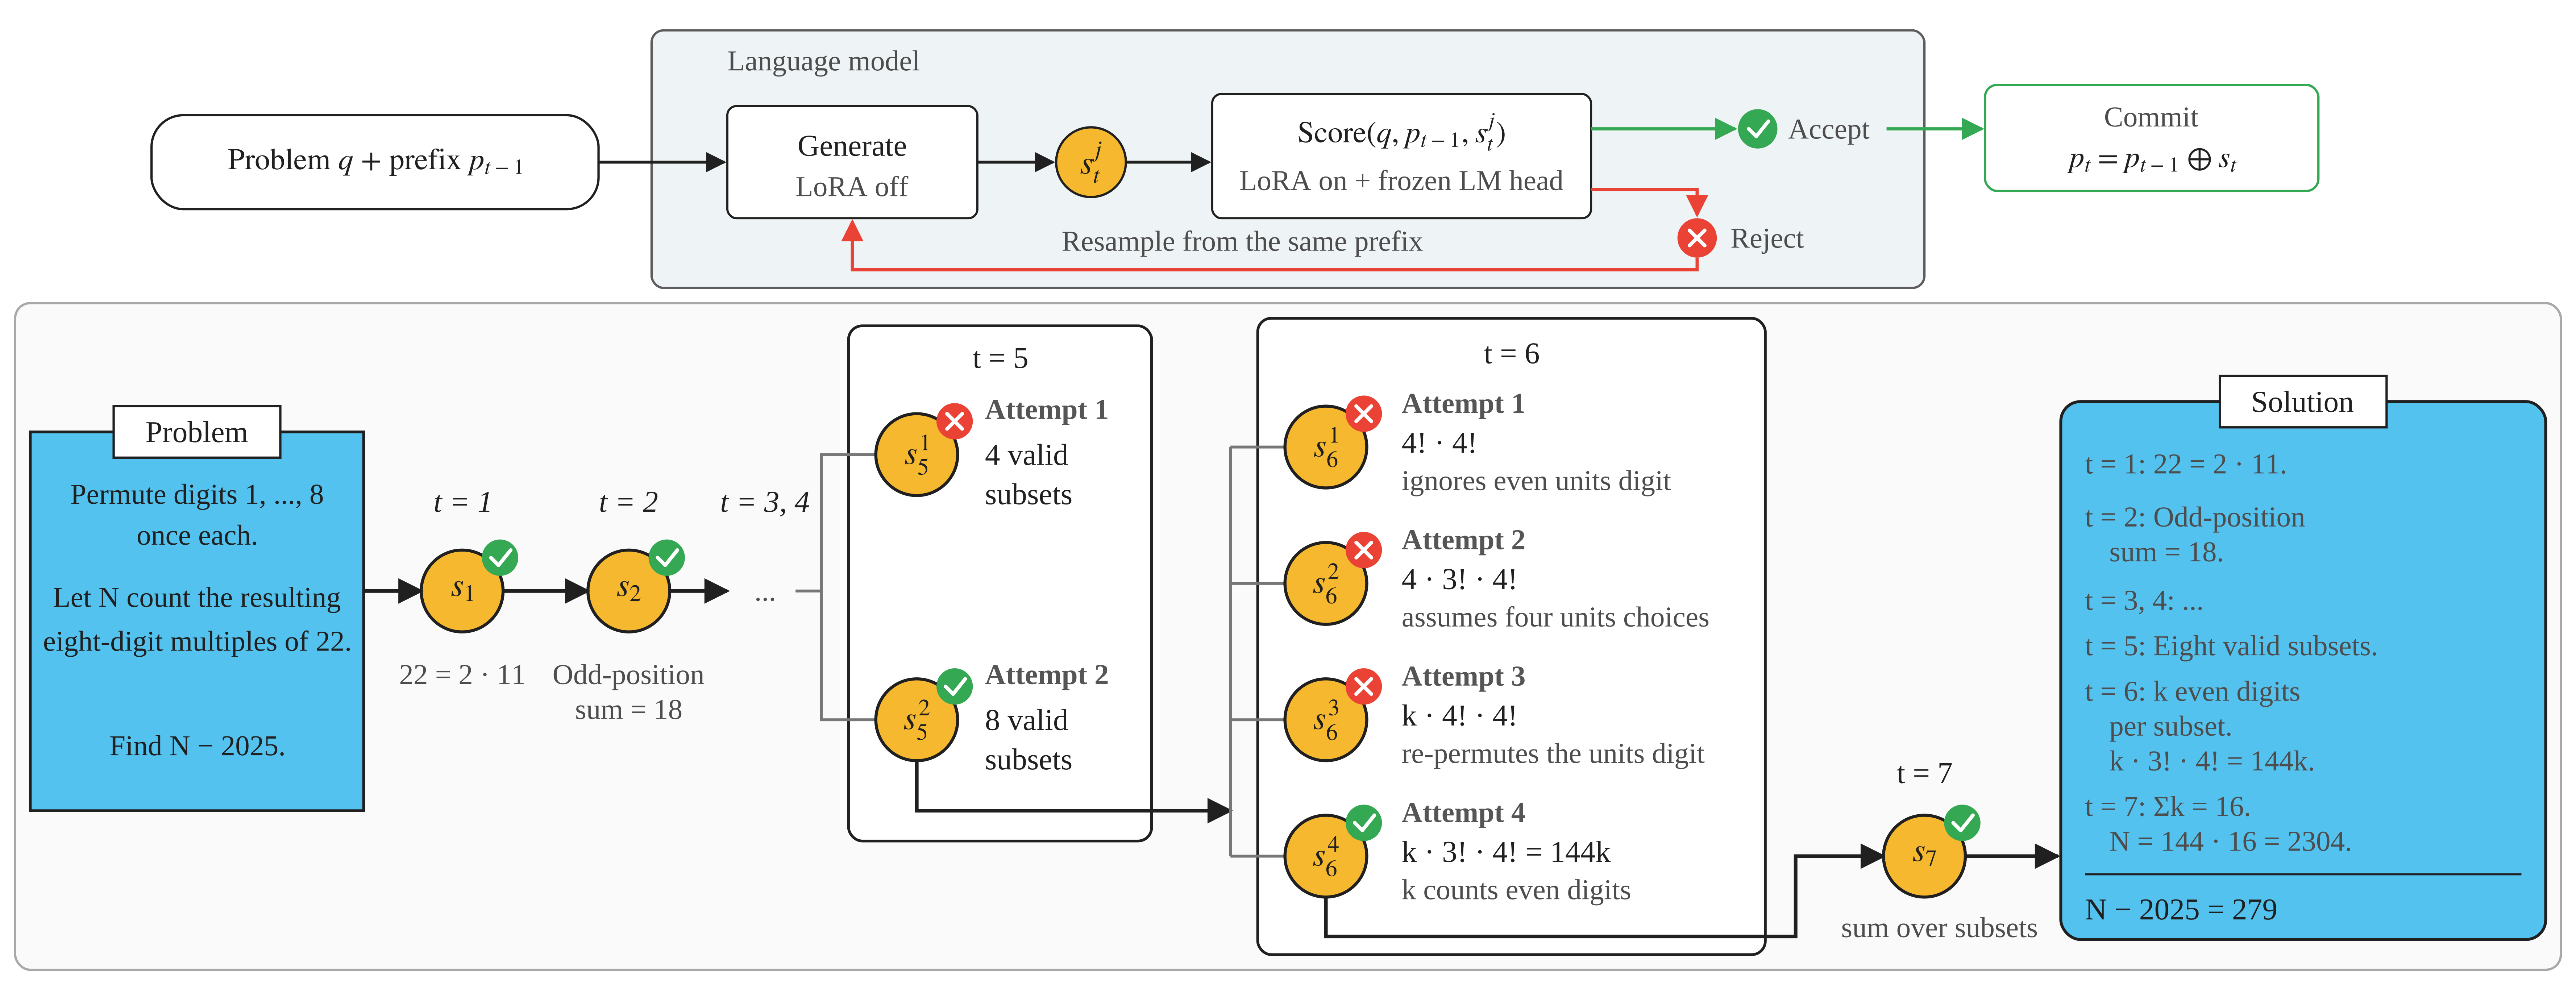
Self-Step Rejection 冻结推理模型,用同骨干LoRA适配器判断新生成的一段是否接受,拒绝则从原前缀重采样。训练以相对初始解题成功概率首次明显下降为负标签,并用同前缀排序和最终答案奖励优化。三模型五数学测试显示较好的准确率/生成token折中,但需离线标签与训练,并非模型无需监督自然自检。
图解主要方法
模型能否在不改写已经接受的推理前缀时,识别并重采样少数会降低最终成功机会的续写?
- 1
用续写成功率定义恢复能力
从初始题和已提交前缀分别多次续写,以最终答案规则检查得到成功概率。相邻差分噪声大,改比较候选后成功率是否低于初始的70%;这衡量特定策略可恢复程度,不直接判逻辑真伪。
- 2
只标第一次置信跨越
按8→12→16次采样在边界附近加预算,c=1区间全在障碍上方则接受,首个全在下方标拒绝并停止给后缀标签;未分辨者和根值0者排除,避免把继承错误的后续每步都判坏。
- 3
同骨干LoRA学习接受与排序
冻结主模型、词嵌入与输出头,rank16 LoRA接query/output/MLP投影。给题目+前缀+候选末尾附标记,以既有正负token的logit差作门控;BCE之外增加同前缀接受/拒绝对的RankNet损失。
- 4
用最终答案优化二元策略
每题8个解码episode,终局0/1奖励减同题组均值,REINFORCE优化接受/拒绝决策;不按标准差归一化,常量结果组无梯度。开发集校准阈值后固定,部署转确定性阈值。
- 5
受预算约束地拒绝重采样
生成时关LoRA,打分开LoRA;接受扩展前缀,拒绝回到未改动前缀。每位置最多8次、全程最多12次拒绝;全位置都拒绝就选最高分,预算耗尽后直接续写。生成和评分各维护缓存,不是免费复用所有计算。
实验与证据
全文72551字符、附录A–D全部算法/设置/案例读完;图4原SVG转换后视觉核验;官方日期许可、所列仓库网页与API实际检查。
来源证据训练池Omni-MATH过滤去污染后1100题,1004训练、96开发;测试293题=AIME25 30、OlymEasy/Hard各100、HMMT25 30/HMMT26 33。 附录B/C ↗
我的解读训练与测试按题分离且开发选择阈值/检查点;不能把三次评估运行当三次完整独立训练。
来源证据16次/端点时相邻变化可分辨比例Qwen24.0%、R1 2.3%、gpt-oss18.7%;同前缀低值尾部6.0/11.0/11.5%。 表2 ↗
我的解读说明局部监督噪声与稀疏拒绝动机;不是所有推理步都有可识别坏候选。
来源证据Qwen3-14B均值54.5→64.6,token1.21倍;R1-Llama8B25.1→30.5、1.40倍;gpt-oss20b56.7→66.8、1.28倍。 表1 ↗
我的解读增加5.4–10.1pp是五基准宏平均,分母不是全部题微平均;成本只指生成token。
来源证据Qwen USC65.1对SSR64.6但8.24倍token;R1 ORM32.5对30.5且8.06倍;gpt-oss Majority70.6对66.8且7.34倍。 表1 ↗
我的解读SSR在所测步骤级方法均值最佳,仍低于部分全解方法,选择体现准确率/成本折中。
来源证据Qwen全配方64.6;所有低于障碍都标负57.1、无同前缀配对58.5、无策略优化60.0。 表3 ↗
我的解读支持首次跨越、局部排序与终局优化都有作用,但预算/拒绝率变化也随之发生。
来源证据目标拒绝17.8%,实际21.0%,每题10.7次评分;位置封顶0.4%、全程预算耗尽3.0%。 表4 ↗
我的解读校准目标不是部署实际比例;即便拒绝率低,仍需几乎每段评分。
来源证据六H200上每次评估单次生成1.09h、SSR1.26h、ESC4.85h;训练单H200节点总约200h/模型。 表5;附录C ↗
我的解读该工程实现墙钟开销约15.6%,与生成token1.21倍不同,不能泛化到任意硬件/服务。
来源证据Qwen目标拒绝17.8→30%准确64.6→64.7,token1.21→1.37;步长256/512准确54.7/54.4,1024–4096约64.1–64.6。 表6–7 ↗
我的解读更多拒绝不是线性更好,太短步骤也会损害表现;论文的“步”应理解为分段上限。
开放情况与使用许可
论文声称代码和检查点在github.com/xiongsiheng/SSR,但实测仓库网页、API及main内容均返回404;可能未公开或地址有误,当前不能核实代码/模型可下载,不标开源。
LICENSE论文及图4 CC BY 4.0;原SVG转PNG内容未改动。无法核实SSR实现和适配器权重许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
前缀相同的排序目标控制了题目难度和深度,让验证指标对准实际重采样决定。
无配对损失、无策略优化及把所有后续坏状态都标负的消融均明显下降。
报告生成token、拒绝率、预算耗尽和墙钟时间,便于区分不同成本。
反方 · 哪些结论还不够
标签是固定策略恢复能力下降,不是数学正确性;首次可置信跨障碍也可能晚于真正引入错误的步。
标注c=1、8/12/16次自适应采样,不是95%或随时有效置信保证,重复窥看会影响误差控制。
同骨干LoRA减少外部模型需求,但仍是额外学习的验证器,并需要规则答案监督和离线采样。
最强全解基线仍高0.5–3.8pp;本方法优点是较低生成成本的折中,不能将“步骤级均值最佳”写成所有方法准确率最高。
综合判断
值得关注的是把额外计算集中在同前缀的低价值候选,并以局部判别训练支持这一决策;证据是竞赛数学上的计算折中,尚非通用自我纠错或逻辑验证。
我会先做的验证
建议实验(尚未执行):以总GPU秒和显存匹配外部PRM及全解采样,独立训练多种子;使用随时有效区间重建标签,并人工检查“逻辑错误/正确但难续写”的区别,测试模型与领域迁移及预算耗尽案例。