Remory:给压缩摘要加一层可学习记忆,保留下一步决策需要的线索
冻结主模型、训练软token补充;输入缩短不等于总运行成本同比下降
Remory保留可读文本摘要,再根据历史和摘要生成有界连续记忆token,帮助冻结语言模型接近完整历史下的后续输出。它在多轮压缩时递归携带旧记忆,仍保留普通档案检索工具;实验显示来源归因、长程代理成绩及重复工具调用有所改善。
图解主要方法
上下文压缩后,能否用可学习的软记忆补足摘要遗漏的决策线索,而不修改主模型?
- 1
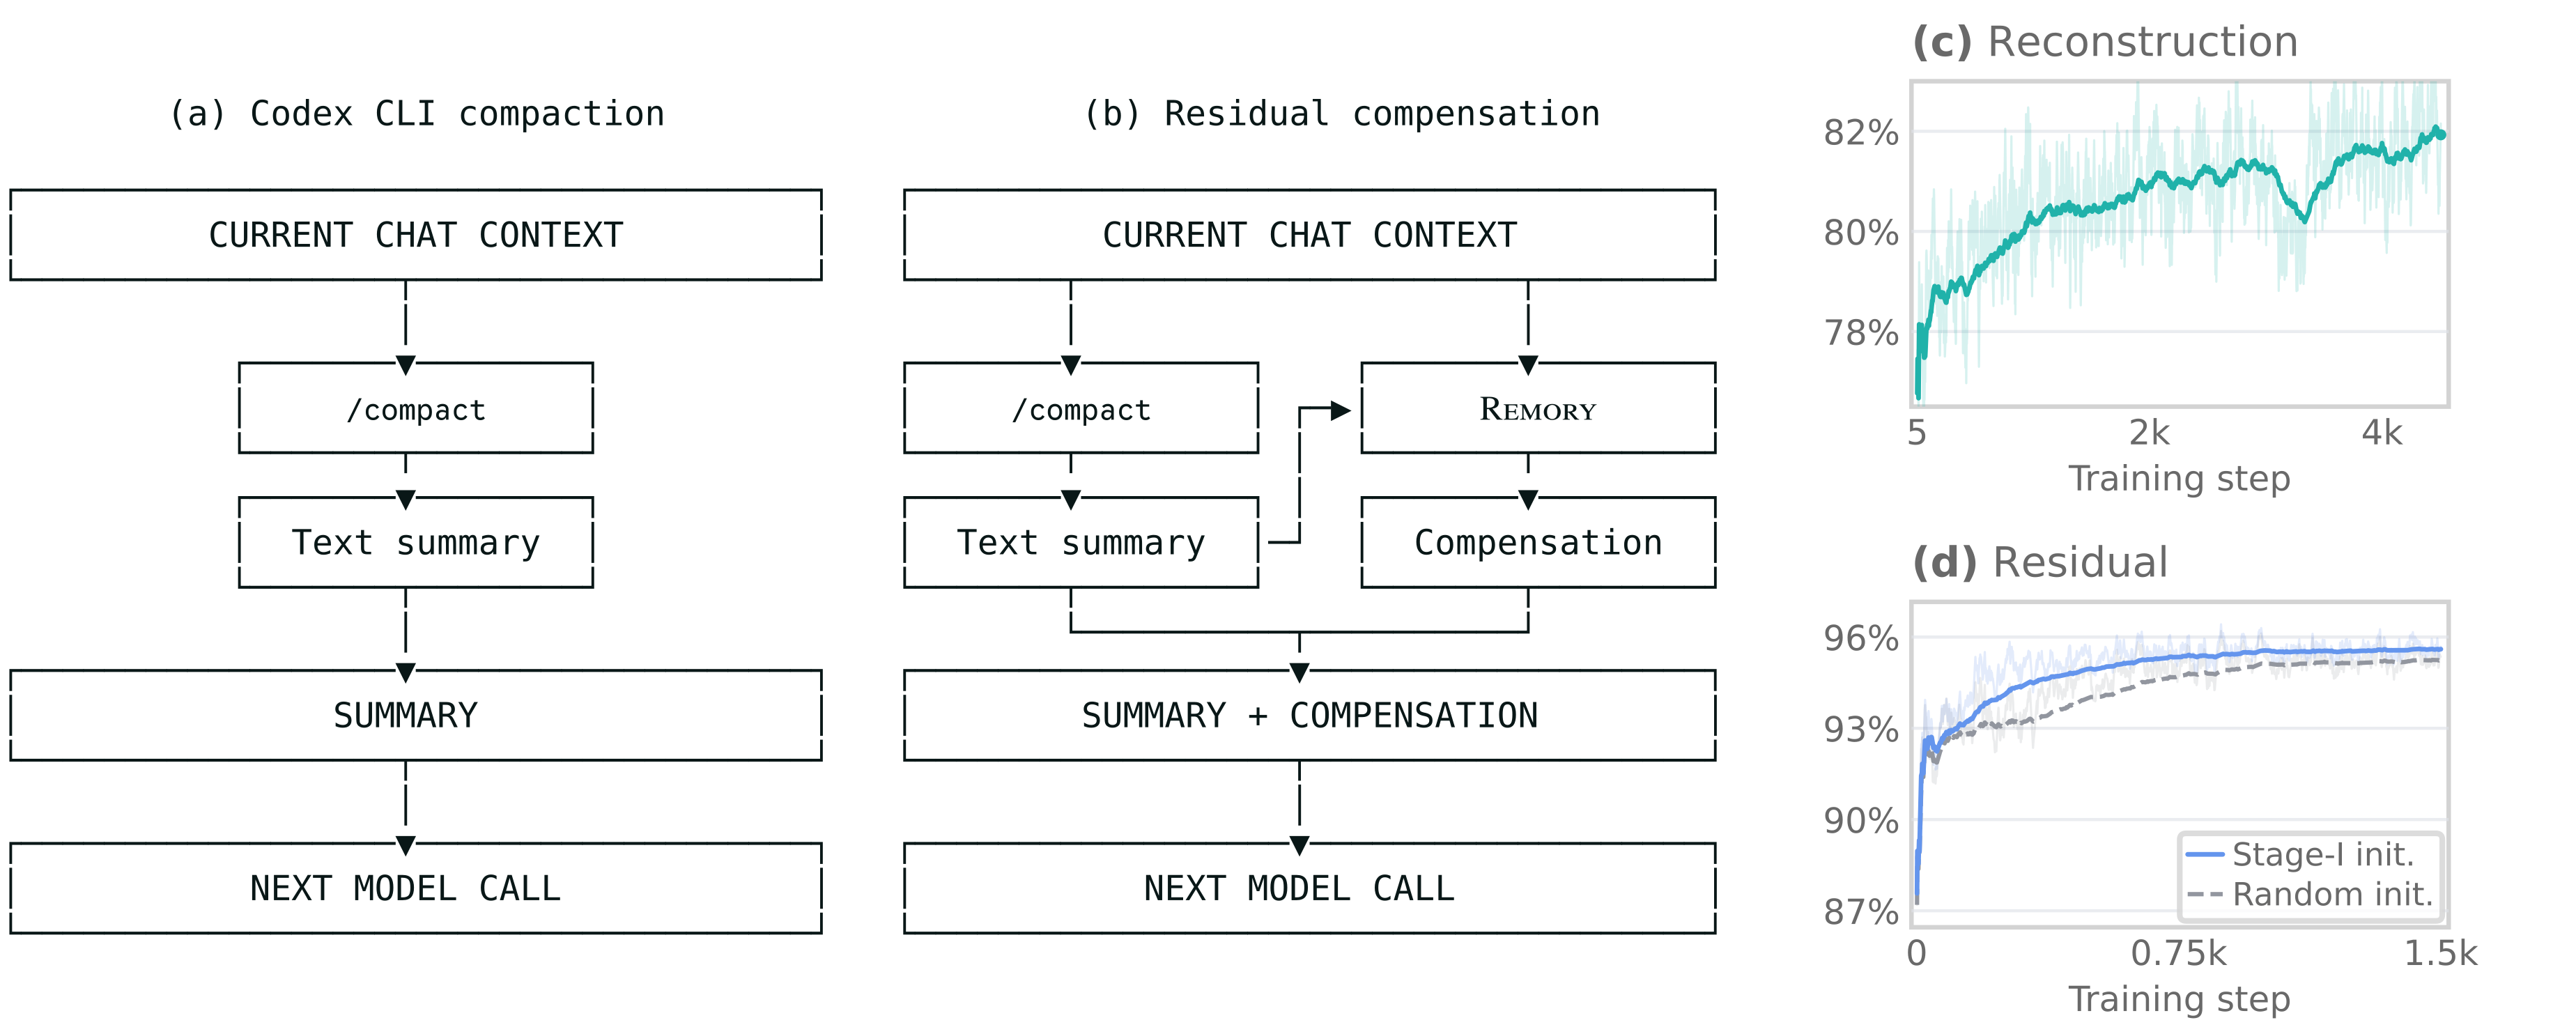
压缩时同时保留摘要和残余记忆
边界历史包含旧摘要、旧软记忆和新交互。先生成新文本摘要,再由Cφ(H;S)构造补充,按序把摘要与连续向量附在持久指令后;原始精确记录继续通过文件和档案工具读取。
- 2
利用主模型特征并分层控制槽数
冻结actor提供特征,学习查询并通过门控交叉注意力参考摘要。每最多1024源位置产生64软token,按源顺序层级压缩,最终不超过4096槽;这不限制源编码本身的长度与峰值开销。
- 3
先学重建,再学摘要缺口
Stage I让完整文本教师与软记忆学生重复同一源文,初始化信息保持能力;Stage II教师看完整交互、学生看固定摘要加记忆,预测同一后续助手响应。编码器不读取未来响应,训练按历史长度课程推进。
- 4
通过冻结actor优化反向KL
对整个响应、全词表计算KL(q学生∥p教师),稍偏重较早位置,只更新记忆网络。它学习补足后续预测,不要求每个遗漏事实可逐字重建,也允许与摘要信息重叠。
- 5
把软向量接入真实推理框架
公开实现用SGLang钩子读隐藏状态,继续生成时在摘要后插入保存向量。下一次压缩传入旧检查点与新增历史,调用者仍负责工具、压缩触发和档案;这是需要推理栈支持的接口。
实验与证据
完整阅读30328字符全文与参考文献,公开版本无额外附录;视检原图3,核对GitHub真实推理文件、MIT许可和Hugging Face模型文件清单。未执行模型或复现基准。
来源证据SummHay全部92查询、10集合、621参考insight:摘要Joint39.84,等预算文本39.78,残余记忆43.39,完整上下文43.41。 表1 ↗
我的解读接近完整上下文的是联合分,不是所有能力:记忆覆盖67.95低于完整72.46,引用F1 61.03高于完整56.60。
来源证据摘要→记忆覆盖67.55→67.95,引用F1 56.98→61.03;联合分增益集合配对bootstrap95%区间[+0.74,+6.21]。 第3.1节 ↗
我的解读区间条件于已生成和已判分输出,不涵盖重复生成或评审器不确定性;共同覆盖553项仍有归因提高,支持来源关联解释。
来源证据平均输入原始96872位置、摘要1393、摘要加记忆5024,后者约5.2%。 第3.1节 ↗
我的解读压缩后的输入预算不计记忆形成时读取原历史的计算,所以不可等同端到端95%节省。
来源证据Qwen五次运行AutomationBench35.5±1.3→45.3±1.0,JobBench33.4±1.25→41.0±1.41;±为标准差。 表2 ↗
我的解读多次工作流结果较稳,但JobBench生成代价3.09→3.21美元,收益并非每项同时降成本。
来源证据一次Terminal-Bench89任务:Qwen71.9→76.4、GLM84.3→87.6;BrowseComp1266任务:74.0→77.0、84.9→89.0。 表3、图1 ↗
我的解读控制证据来自同actor同框架,而图1其他前沿模型是各自协议的已发表参考,不可当严格排名对照。
来源证据四actor–基准组合重复输出总量降17.9–29.8%,错误总量降25.3–49.7%。 表3 ↗
我的解读重复排除了规划和轮询,错误包括失败命令/显式工具错误;运行长度与行动也改变,需每调用归一化和配对分析才能判断局部可靠性。
来源证据100条Qwen轨迹的488个压缩后下一行动,记忆345胜、21平、122负;反事实行动未执行。 第3.3节 ↗
我的解读这测评审对提议的偏好,不能将70.7%偏好率写成后续实际成功率。
来源证据模拟交易两账户结算ROI为−11.86%与+5.11%;压缩总数56→45,但每千响应10.5→14.9。 第3.4节 ↗
我的解读两条轨迹选市场和时机不同,不能推断收益因果或更少压缩频率;案例也不是投资效果证据。
来源证据论文Qwen/GLM记忆参数1.94B/1.502B;公开GLM仓库说明检查点1.24B,Qwen建议至少2×80GB部署。 第2.1节、官方仓库 ↗
我的解读必须固定检查点版本再复现论文,不能默认公开模型与所有报告完全一致。
开放情况与使用许可
已核实1ring2rta/Remory有推理服务、接入示例及测试,根MIT许可;Qwen记忆卡有config、manifest、SHA256SUMS和model.safetensors。仓库注明GLM公开1.24B检查点不同于论文1.502B;未确认完整训练管线/数据发布,未下载大权重运行。
LICENSE代码根许可MIT并保留第三方声明;Qwen记忆卡标MIT,基础actor另依自身许可。论文及图3为CC BY 4.0;原SVG转PNG并铺白底,内容未改动。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
SummHay固定actor、摘要和解码,以等额外位置文本补充作对照,改善主要在归因而非覆盖,机制解释更有针对性。
两个actor在同一运行框架内的多项任务比较均提高得分,支持残余记忆对压缩后任务执行有用。
反方 · 哪些结论还不够
Terminal-Bench和BrowseComp每配置仅一次,错误总量受轨迹长度影响;不能直接解读为每次工具调用可靠性提升同样幅度。
5.2%指输入位置,美元估计不含编码器、记忆网络和工具,不是总算力/成本节省95%。
公开GLM检查点规模与论文不同,训练超参数、长期递归压缩的误差积累及跨actor迁移仍缺充分证据。
综合判断
有力之处是让软记忆针对摘要留下的预测缺口学习,而不是要求一个短摘要无损保存全部历史。当前证据支持特定自托管actor与任务的改进,不能据此认定获得通用永久记忆或总成本优势。
我会先做的验证
建议实验,未执行:固定相同压缩边界和摘要,比较等位置文本、检索和软记忆,并计入编码、峰值显存、时延与总GPU成本;重复多次任务、延长递归压缩链,测来源绑定、过期事实和新任务迁移。