Research World Models:把真实实验记录变成下一次实验的预测依据
上下文中的失败与成功经验,能比单纯增加推理强度更有用
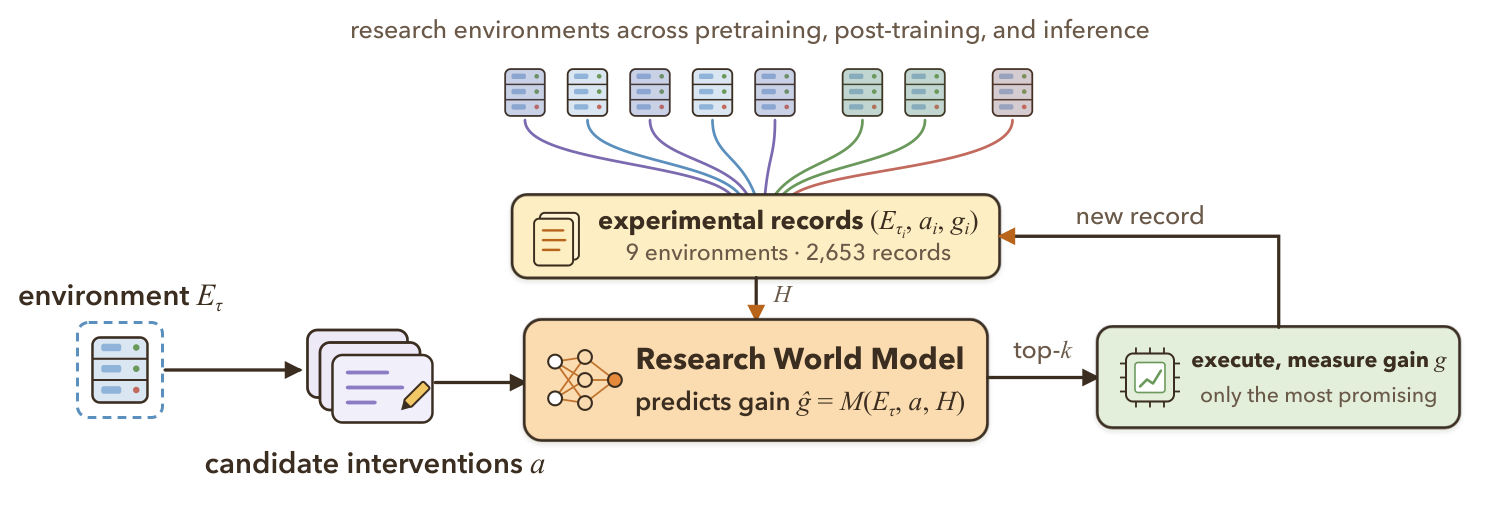
研究让冻结语言模型读取环境配置、代码改动和既往实验收益,预测候选实验的最终增益,再从预算允许的少数候选中选择。2653条真实记录覆盖九个环境;上下文经验改善同环境和部分跨环境排序,但多轮实验仍围绕固定基线与预先给定候选池,不能等同于开放式自我改进。
图解主要方法
昂贵实验留下的经验,能否帮助选择另一个配方中最值得运行的改动?
- 1
把研究动作定义为可执行改动
环境固定参考模型、数据、预算和评分协议,候选是相对该参考的代码diff或配置改动。BPB下降算正收益,准确率与吞吐上升算正收益;不同环境的原始单位不直接混加。
- 2
提供经验,但隔离待测结果
冻结语言模型读取环境、候选和允许的历史记录,输出最终收益的条件中位数估计。待预测候选的结果及运行后元数据不输入;跨环境测试还剔除同一改动及近重复语义组,避免直接查到答案。
- 3
以排序驱动小预算选择
静态测试把候选随机分成每组16个,预测器选3个。Regret@3衡量漏掉组内最佳方案的损失,NDCG@3衡量正收益与排序;200次共用分组减少分组偶然性,但仍复用同一固定测试面板。
- 4
累计已选实验反馈,保持基线不变
多轮评测每轮引入16个候选,未选的继续保留;每次选3个,八轮共24个。只把各方法先前选中实验的测得结果加入下一轮上下文。所有实验仍从同一参考系统开始,不是在上轮最佳模型上叠加改进。
实验与证据
完整阅读正文和附录A–E共74546字符,检查图1、首发记录、信息边界、分组bootstrap与多轮候选协议;未执行作者实验或调用模型复现。
来源证据2653条记录共171862 H100 GPU小时:五种自回归预训练、扩散预训练、数学蒸馏、代码RL、推理优化。默认预测器Claude Opus 5,1M上下文、HIGH推理。 表1、第3.1节 ↗
我的解读这是构建经验档案的已发生实验量,不是运行预测器所需训练量。本文通过上下文利用记录,没有更新预测器参数。
来源证据Marin/Qwen3/Nanochat为研究定制的153M/153M/149M左右模型,随机初始化;OLMo3-100M名称按非embedding参数计。 附录B.1 ↗
我的解读不能把跨环境效果直接宣传成对官方大尺寸Qwen3或所有同名发布模型有效,参数口径也需区分。
来源证据每个跨环境目标有71个待测改动、244条其他四环境记录;3000次按69个语义组配对bootstrap。OLMo3-190M提升区间为−0.07至+0.18,Marin为−0.05至+0.24。 表3、表7、附录D.1 ↗
我的解读点估计均提升不等于每个目标都获得明确统计支持;区间条件于已固定的历史、预测与一次记录结果。
来源证据同环境Regret相对下降58.2%按各环境下降比例平均;跨环境52.2%按宏平均Regret之比计算。NDCG排除没有任何正收益的候选组。 附录D.2 ↗
我的解读两种百分比聚合口径不同,不能直接比较以断言迁移仅损失多少效果;NDCG也没有涵盖全是失败方案的组。
来源证据五次多轮评测各从231个未见候选中抽128个,按机制复杂度安排到达顺序;初始同环境或跨环境均提供244条记录。 附录E ↗
我的解读这是共享到达计划下的选择与反馈评测,不是开放式候选生成竞赛;24次预算从历史已存在后开始,不含获取244条经验的成本。
来源证据作者观测预测16候选约6.3美元,按每GPU小时3美元及实验均值的中位数42.3小时估算,约为一项代表实验成本的5%。 第3.3节 ↗
我的解读这是论文当时模型调用和算力假设的局部估计,非当前价格或全流程净节约;应另外计算记录清洗、长上下文和初始实验档案成本。
来源证据13个预测骨干在OLMo3面板上无记录Spearman范围−0.362至0.621,有记录0.638至0.896;LOW加记录0.892,高于无记录MAX的0.648。 第3.5节、图3 ↗
我的解读支持这一固定面板中经验更重要,不能泛化为推理计算对所有科研任务无效;跨环境与大规模实验还需独立验证。
开放情况与使用许可
2026-10-11核对全文、arXiv与精确标题检索,未确认官方实验记录、预测器代码或专属模型权重发布。论文说明发布前将审查记录、代码和提示的许可与安全,并只提供缩写提示模板;基础模型仓库不算本研究开源。
LICENSE论文及图1为CC BY 4.0;未确认研究数据与实现的单独许可。被研究的商业API和基础模型各自受其条款约束。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
五个同环境任务平均Spearman从0.506升至0.774;五个预训练跨环境任务从0.628升至0.729。
OLMo3-100M的五次八轮评测中,同环境和跨环境初始记录分别提高最终最佳增益15.8%和11.6%,各方法都只选24次实验。
反方 · 哪些结论还不够
跨环境Marin的Regret@3由0.000740变差到0.000790,NDCG@3从0.74降至0.70;总体排序变好不保证最值得运行的前三个选择更好。
跨环境OLMo3-190M和Marin的Spearman提升95%分组bootstrap区间跨零,且固定历史和模型预测未把全部实验噪声纳入。
同环境推理优化任务的Regret@3为2.53 tokens/s,仍高于kNN的1.62和ridge的2.09;不能宣称所有决策指标优于简单方法。
综合判断
结果支持真实实验经验是预测排序的重要输入,且有有限的跨配方复用价值。它尚未证明一个已训练好的通用科研世界模型,也没有评测自主提出候选、滚动修改基线后的递归能力提升。
我会先做的验证
建议实验,未执行:按时间和机制家族双重留出,在未见模型规模上前瞻运行候选;比较语义嵌入、贝叶斯优化和校准不确定性基线,把历史获取、推理、失败执行成本全部计入,并跨种子重复被选实验及一部分被否决实验。