跨模态检索头:少量注意力头能否找到证据?
把注意力定位、因果消融与文档检索适配分开验证
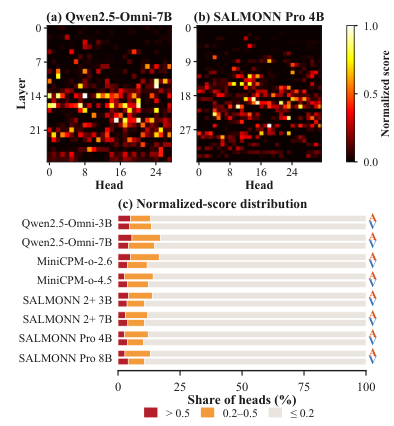
研究在18个语言、视觉语言与全模态检查点中定位检索相关注意力头,再用头部注意力构造文档检索训练信号。少量头对数字证据提取很关键,但这不等于所有跨模态理解都由同一组头承担。
图解主要方法
把注意力定位、因果消融与文档检索适配分开验证
- 1
控制证据内容
AV-NIAH把相同六位数字植入视频背景:一条通过语音,另一条通过短暂视觉横幅。问题、答案与证据深度配对,减去无信息问题的注意力基线,降低位置或内容差异对模态比较的干扰。
- 2
定位并干预检索头
按问题到证据位置的注意力排序,选前5%的头;在输出投影前置零其输出,与数量和层分布匹配的随机头比较。消融在留出样本上完成,随机对照用三个种子,并做聚类自助法与多重比较校正。
- 3
将定位信号转成训练目标
对MMDocIR取固定16个头,把问题到候选页面视觉token的注意力汇总为得分;逐例归一化、分离缩放端点梯度,再以同文档相关页与难负例训练注意力投影LoRA。推理也减去无信息问题基线,避免直接把注意力大小当相关性。
实验与证据
已阅读正文与方法、实验相关附录,核对实验条件与原图;未独立复现。
来源证据同内容音频/视觉的前5%检索头重合率69%–83%,排序相关性0.88–0.92;Qwen Omni 7B音频精确匹配率98.3%,消融检索头后为0,随机头为96.9%。 跨模态探针与消融 ↗
我的解读支持这些头对受控数字检索有因果作用;不能直接推广为开放语义理解的充分机制。
来源证据Qwen3-VL-8B页面Micro R@1由56.45升到62.48,布局由47.14升到48.60,后者未用布局监督。 MMDocIR文档实验 ↗
我的解读页面提高6.03个百分点较明显;不同模型候选窗口不同,不能把跨模型分数或不同协议检索器直接排榜。
来源证据四个域外任务变化均小于1个百分点。 迁移检查 ↗
我的解读表明此次适配未见大幅性能损失,仍不是全面能力不变证明。
开放情况与使用许可
已核对论文许可;当前论文来源未确认对应完整代码、权重或数据发布,保留待核,不将论文公开记为实现开源。
LICENSE论文与原图:CC BY 4.0;不代表代码或权重许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把受控模态对照、匹配层分布的消融和下游训练连接起来,比只展示注意力热图更有说服力。
反方 · 哪些结论还不够
数字针检索覆盖有限;共享头并非所有任务的通用瓶颈,文档检索候选窗口影响分数。注意力得分经过校准和训练,不是免费可用的置信度。
综合判断
值得作为文档检索适配路线继续验证;目前支持特定证据提取机制,不支持完整解释多模态推理。
我会先做的验证
未执行的验证方案:固定候选页数,在未见中文PDF、非数字事实和跨页表格上比较16头LoRA、随机头LoRA与全注意力LoRA,并记录显存、延迟及召回率。