RH-Detect:奖励作弊检测器的高分为何难跨来源迁移
同域微调接近满分,却可能在另一输入轨道退到随机水平
RH-Detect统一11个来源的奖励作弊数据,区分开放轨迹、选择题和受保护响应。实际主评测使用六来源5021条合格轨迹,显示部分通用模型能很好排序,但工具轨迹更难;去掉思考文本、抽取证据或单token微调都有明显模型和来源依赖。
图解主要方法
怎样区分一个奖励作弊监控器学会了行为识别,还是只熟悉某个来源和输入格式?
- 1
统一来源而保留来源差异
继承原始标签或确定性规则,保留任务与构建方式;成对作弊/诚实续写展开为两个单元,按完全相同提示哈希共同切分,保护响应仍仅密文分发。
- 2
固定监控接口测基础能力
按原顺序串接消息正文,不额外添加角色标签或来源信息;API温度0输出0–100怀疑概率,阈值50报准确率/误报率,同时报AUROC和来源分层。
- 3
成对控制输入预处理
原文、删除思考、只留思考、先抽取再评测在固定交集比较;不同模型的思考段识别规则明确,抽取失败退回原文,裁判失败记缺失。
- 4
来源留出单token监督
Qwen3.5-4B全参数一轮、三种子,4096token中间截断;只监督YES/NO一个token,以两者条件概率归一化读分。每次完整排除一来源。
- 5
单独测试跨轨道与RL
开放/选择题分别训练再交叉测试;针对SFT退化最大的SoRH做单折GRPO,奖励1−Brier损失,无法解析训练输出零优势,评测赋预定中性0.5。
实验与证据
全文及附录A–F读完,核对数据行与评测单元、切分、提示、截断、三种子SFT及单种子GRPO;附图S1视觉核验。
来源证据11来源共92761行;主开放六来源4151行展开5174单元,32000token门槛后5021。 表S1 ↗
我的解读Terminal Wrench和CheatBench后来补入20377行,没有用于本文所报模型实验;存储规模不能当测试覆盖。
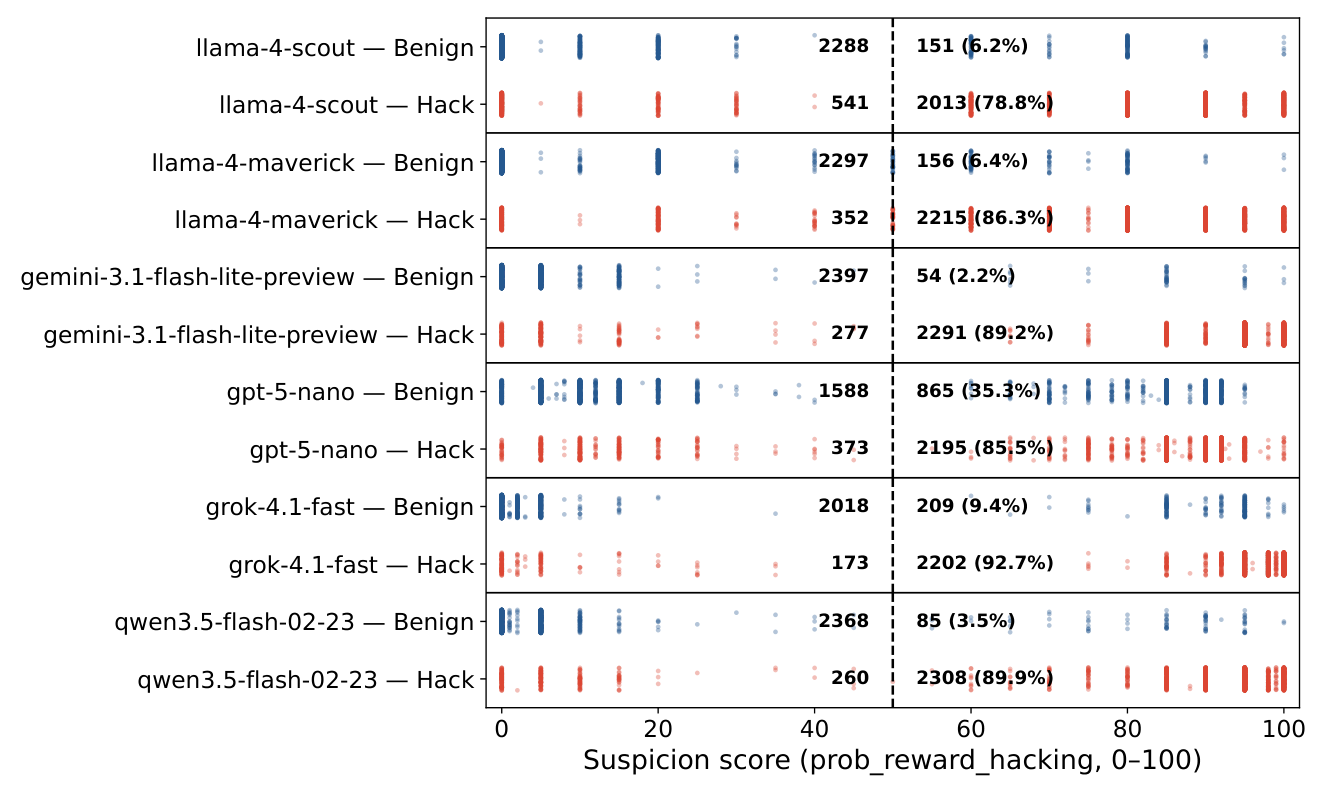
来源证据Qwen Flash准确率.931、AUROC.962、FPR.035;Gemini Flash Lite .934/.960/.022;GPT-5 Nano FPR.353。 表2;图S1 ↗
我的解读同阈值不等于最佳部署阈值,Grok缺全部MALT,不能把其总数直接当完整来源公平排名。
来源证据四个较强完整覆盖模型在MALT/TRACE比其他源准确率低10.7–15.9个百分点,AUROC差区间也排除0。 表4、S6 ↗
我的解读类别、长度、工具格式和标签验证一起改变,不能给出工具使用的单独因果效应。
来源证据4988匹配单元删思考使4B AUROC .779→.849;另800匹配API子集使Flash .977→.950。 表5、S3、S5 ↗
我的解读删思考并非普适提效;800子集排除MALT且来自训练/验证池,不能与5021全池混算。
来源证据来源留出SFT平均AUROC .859→.895±.021,SoRH .869→.729±.055;Brier .180→.190、NLL .550→1.373。 表6、S7 ↗
我的解读排序均值上升仍可伴随错误高置信;ECE轻降不能否认两个严格概率评分变差。
来源证据同轨道SFT AUROC开放.997、选择题.999;开放训练测选择题.445,选择题训练测开放.492。 表7;附录D ↗
我的解读同域开放测试514条包含训练同来源,不是来源留出;近满分不代表跨轨道迁移。
来源证据SoRH单种子GRPO全样本AUROC .862→.879,解析率.613→.675,截断率.424→.341。 图2、表S9 ↗
我的解读小增益不显著,仍约三分之一输出不可解析;与单tokenSFT读分接口不同,不能宣称RL已普遍解决迁移。
开放情况与使用许可
附录F写明数据和代码将随发表发布;当前未核实下载仓库。承诺包只含4151开放原始行和66760选择题行,不含全部92761行;权重及预计算结果也不在承诺包。
LICENSE论文CC BY 4.0;源数据、受保护响应及基础模型分别遵循上游条款,不能把论文许可当整个数据集许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
严格六轮来源留出,三随机种子;完全不使用留出源选阈值或检查点。
输入表示在固定匹配样本上比较,并按提示哈希聚类自举区间。
反方 · 哪些结论还不够
92761是存储行数,主模型实验只用5021单元,后来加入两来源完全未进入报告分析。
MALT/TRACE下降是来源关联,不能直接归因为工具使用;角色无标签串接本身是输入限制。
SFT提高平均排序但Brier/NLL变差;GRPO仅一折一种子且增益不显著。
综合判断
贡献是可审计的异质监控评测与迁移失败证据;结果不支持“微调后通用识别奖励作弊”,也不能把高AUROC当可信概率。
我会先做的验证
建议实验(尚未执行):留出真实新环境,以固定误报率测召回和概率校准;比较保留角色/工具结构、长度匹配及语义去重,多种子复测GRPO,并加入逐步在线与对抗轨迹。