RoboDoctor:冻结机器人策略外的诊断与纠偏
动作预览、实际执行和物体状态,如何分层核验?
RoboDoctor 不更新底层 WAM 权重,而在外部安排多模态诊断、短段放行和记忆修订。其价值在于区分“机器人到位”和“物体操作完成”,但报告来自回顾性运行档案,不是严格匹配预算的因果实验。
图解主要方法
动作预览、实际执行和物体状态,如何分层核验?
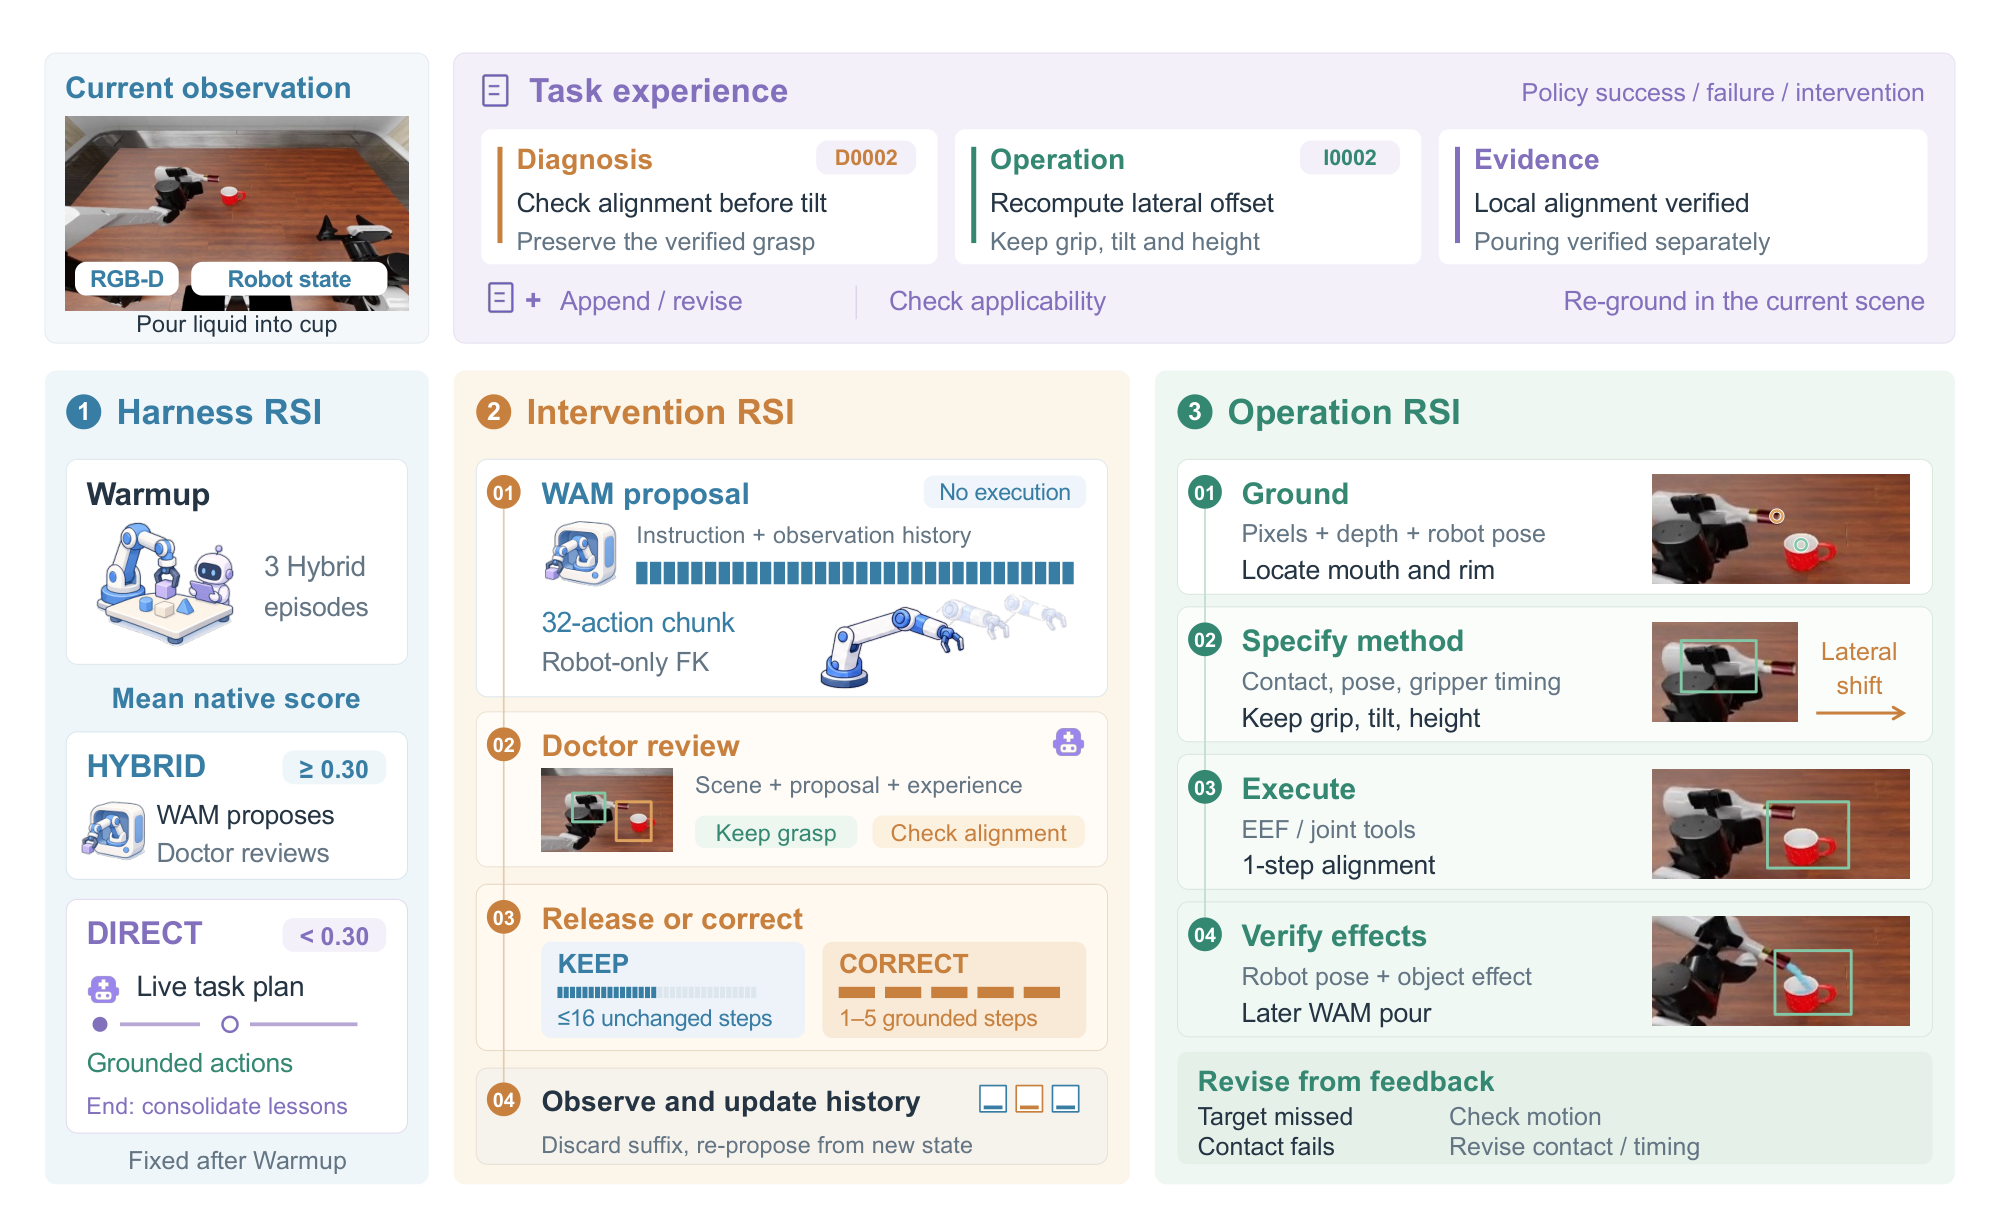
- 1
先决定控制方式
图2左侧以3次 Hybrid 热身均分决定后续模式:低于0.30切换 Direct,否则保持 Hybrid。模式确定后不逐回合任意切换。记忆参与热身,所以热身不是无辅助原始策略。
- 2
预览只筛机器人运动
冻结 Prism WAM 提出32步动作块,FK预览只包含机器人运动、不模拟物体动力学。诊断器选择放行1–16步,或纠正1–5步,丢弃旧动作尾部后重新观察,实际执行帧进入历史。
- 3
分层检查并记录经验
RGB-D点、可达姿态、接触方式与物体实际反应分别记录。末端位置正确不能代替抓住验证;经验包含诊断线索、动作、FK与实测、结果和适用条件,结构化写入检查也不能保证经验为真。
实验与证据
已阅读正文与方法、实验相关附录,核对实验条件与原图;未独立复现。
来源证据54任务,热身162/162条、精炼301/324条;采用各设置最高有效分候选并有缺失。平均分49.74→57.10,原生成功率40.83→49.44。 表1与档案协议 ↗
我的解读这是精选回顾档案中的变化,混合运行覆盖和预算不一致,不能直接归因于经验记忆。
来源证据24任务改善、20退步、10不变;长程类54.58→52.92。外部Hexa参考成绩来自不同协议。 表2与分任务结果 ↗
我的解读平均增益掩盖相当数量退化,尤其不能声称已解决长程可靠控制。
开放情况与使用许可
已核对论文与档案选择规则;尚未核实完整 RoboDoctor 实现和统一运行配置的公开发布。文中第三方策略链接不计作本工作开源。
LICENSECC BY 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
将几何落点、接触执行和物体效果分开核验,是比单纯增加语言反思更具体的控制接口设计。
反方 · 哪些结论还不够
仅仿真,缺少统一推理预算、完整成本汇总和匹配的无doctor对照;FK不提供碰撞或物体接触正确性保证,经验可能传播错误。
综合判断
可作为外部纠偏架构参考,尚不足证明无需训练即可稳定提升机器人能力。
我会先做的验证
未执行的验证方案:固定任务、模型版本、运行预算和随机种子,分别关闭经验、模式选择与纠偏;保留全部尝试,并统计物体成功率、人工接管和碰撞。