RoboJev:机器人成功裁判的域内收益与跨域代价
十帧加末帧多相机的终态判断,不能等同在线可靠性保障
RoboJev把任务描述、尝试视频的十帧及可用辅助相机末帧输入27B视觉语言模型,用一次前向输出成功概率。它在熟悉SO-101分布上明显改善原始JEV,但在未见实验室与机器人域上略低于基础模型,说明适配收益需要逐域核验。
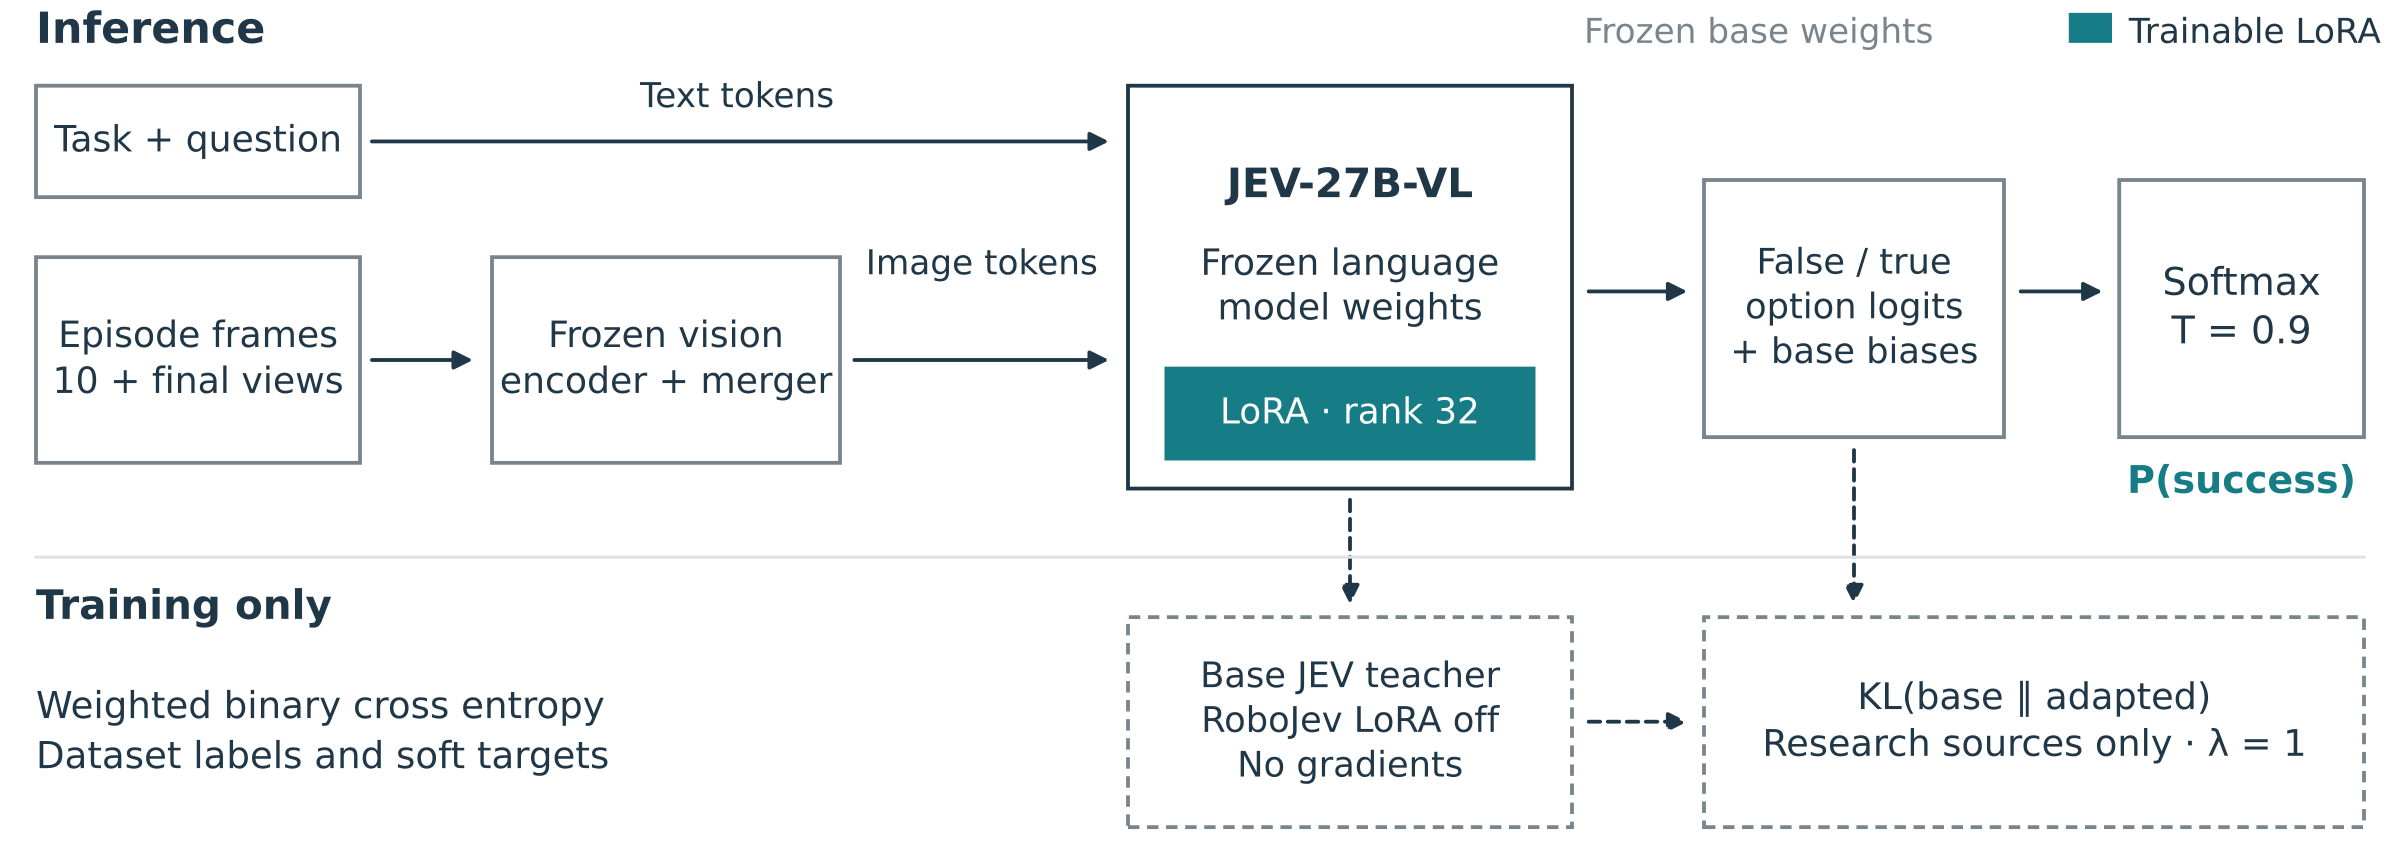
图解主要方法
十帧加末帧多相机的终态判断,不能等同在线可靠性保障
- 1
图2上路:输入协议影响比较
主相机均匀采十帧,附加其他视角的最后一帧,与任务文本共同编码。该协议偏向整次尝试是否完成,不是连续进度或碰撞检测;与只输入四帧的前沿API比较时,视觉证据预算不同。
- 2
图2中:只适配语言骨干
从JEV-27B-VL出发,冻结视觉编码器和融合层,仅对语言部分训练rank-32 LoRA。52,598条拟合记录不等于同样多独立去重轨迹;数据来自多个机器人集合与高置信教师标签。
- 3
图2下路:重加权和基础教师约束
训练采用按来源平衡的二元交叉熵与部分研究数据上的基础模型KL锚定,降低遗忘;不是所有社区来源都用KL。软标签和源权重仍会把教师偏差带入决策,论文也披露过标签或元数据缺口。
- 4
图2右:两类logit变成概率
读取false/true的logit,加发布配置中的偏置并用验证集温度0.9校准。结果是P(success),不是文本解释。阈值0.5和温度在验证环节选择;已有测试集曾用于开发观察,因此不属于完全一次盲测。
实验与证据
已阅读正文及附录A–D,核对实验条件与原图;未独立复现。
来源证据268次运行中,RoboJev平衡准确率95.2%、AUROC 0.993,十帧基础JEV为88.1%、0.979;准确率差的配对区间约+3.04至+11.45点。 SO-101:匹配输入的适配效果 ↗
我的解读这是较有力的域内增益;完全留出任务的80次子集中,平衡准确率92.5%,并非全面胜过前沿模型。
来源证据未见域AUROC为0.890,基础模型0.900;配对差-0.0092,95%区间[-0.0218,+0.0026]。平衡准确率78.2%对79.4%。 459次跨域测试:相反方向 ↗
我的解读不能宣称适配普遍提升泛化。SO-101的ECE 0.032到跨域变0.148,也不能搬用同一置信解释。
来源证据200社区片段中65个模糊结果被排除,135个清晰片段正确126个,即93.3%;标签来自一位标注者。 社区测试与人工标签 ↗
我的解读该准确率只适用于清晰子集,不是全部社区视频,也缺乏多标注者一致性估计。
来源证据H100串行中位0.257秒,以每小时2.69美元估算每千次0.192美元;bf16需要约80GB级GPU。20,628条预测覆盖29个模型/协议条目。 运行成本与复现材料 ↗
我的解读成本不含下载、解码、排队;29条目不是29种独立架构,重新计算指标不等于重新完成推理或策略学习。
开放情况与使用许可
Hugging Face已见12个safetensors分片、推理脚本、校准配置和Apache-2.0许可,模型卡给出论文评测权重固定提交;评测数据另发。当前文档更新不等同新权重成绩,未独立加载27B模型。
LICENSE论文与所引原图:CC BY 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:公开决策权重、协议与逐样本预测,使机器人数据的终态筛选更容易审计;匹配输入的基础模型对照比跨API排行榜更有说服力。
反方 · 哪些结论还不够
模糊片段排除、单人标签、开发期查看测试集及教师与对照重叠都限制外推。终态准确不说明中途安全,未测下游策略学习收益。
综合判断
适合先作离线数据分流和人工复核排序;跨本体使用前需要重新校准,不应直接当机器人安全停止器。
我会先做的验证
未执行的验证方案:新实验室独立采集完整成功、失败及截断视频,保留模糊类,双人盲标;固定十帧协议对比基础模型,并测阈值迁移、错误放行率及人工复核量。