RoboRSI:机器人失败之后,应当修改技能树的哪一层?
自上而下归因与发布门槛组织技能积累;在线改进成绩必须与冻结迁移区分
RoboRSI将任务拆成有输入输出与后置条件的技能层级,让规划、执行、诊断和发布分别承担责任。执行失败时找到最早不满足后置条件的节点,仅修改所属分支,经过测试和历史回放才释放给下一轮;稳定动作序列再合并为参数化代码技能。论文支持技能复用和部分迁移收益,但多数主表是在评测任务上在线积累技能,不能当作冻结策略泛化成绩。
图解主要方法
如何把一次机器人失败归因到可维护的技能分支,并验证修复能够被后续任务复用?
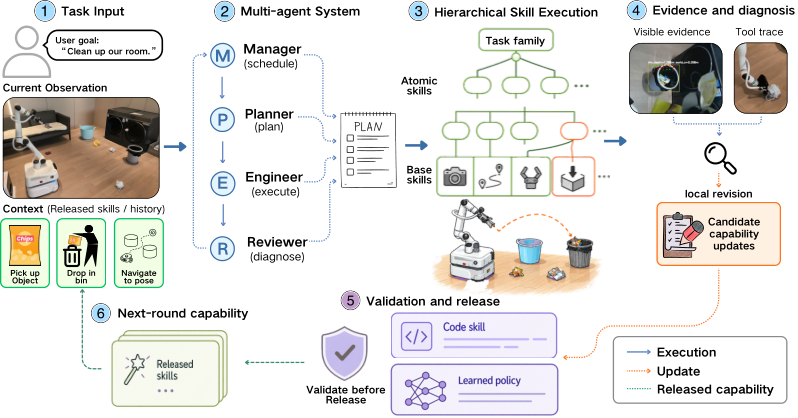
- 1
把目标组织成有契约的技能图
任务族分解为可观察完成条件的原子任务,原子技能调用感知/控制基础技能;多处可共享同一节点。Manager管理目标、版本和发布,Planner生成计划,Engineer执行,Reviewer根据图像与工具轨迹独立检查结果。
- 2
沿返回顺序定位最早失败节点
被调用节点先于调用者检查后置条件,重试每次单列;从最早不满足条件的节点限定修改分支。接口若必须改变,先扩大到受影响调用者;不仅看这次实际走过路径,也看所有可能调用依赖。
- 3
隔离候选,验证后再对后续运行发布
仿真候选先经基础技能功能测试、原子任务至少两个声明种子成功和Manager审查;真实机器人主要回放最近四个合格记录。失败补丁不发布且不得原样重交;调用返回成功不等于任务成功,最后动作之后要有新观察核对后置条件。
- 4
将稳定序列压成参数化代码技能
至少三次成功、工具序列最长公共子序列至少60%、公共骨架至少三步才提出复合技能;运行时重新感知所有参数,不保存旧场景坐标。复合调用失败可回到逐步推理,执行轨迹也可训练ACT后作为技能接入。
实验与证据
全文及附录A–D、图2、代码仓库、Apache许可证与评估文档已读;未运行机器人或模型API。
来源证据主表LIBERO84/150=56.0%、PRO297/600=49.5%、RoboTwin37/154=24.0%;强基线50.7/38.5/21.3%。 表1–3 ↗
我的解读前三项在线更新,RoboTwin基线150次而本方法报告在线前154次。覆盖率是任务至少成功一次,不能替代每次运行成功率。
来源证据冻结Plus354/840=42.1%;README另列398/840 adaptive Pass@2及261/840旧固定版本。 表1;README与评估文档 ↗
我的解读论文主表和仓库摘要不是同一协议或版本,不能混用;复现当前公开冻结版本不会自动重现在线累计成绩。
来源证据代码合并600对提高7.5个百分点,成本另取118任务样本:中位token/调用/墙钟下降29.4/27.2/17.0%。 4.5.3;附录A ↗
我的解读成本样本与成功率样本不同;附录执行成本小计排除另测规划审查,构建、诊断与发布成本应另计,不能视作系统总成本同比下降。
来源证据实机104开发轮累计24小时,两场景演示5+4对象均放入目标;图4只选十轮、最多画每轮前四对象。 4.1;附录B/D.5 ↗
我的解读十轮为事后选择,任务清单、场景变化且人重置;不是104轮固定策略成功率。53类修订触发中4项明确需要人工知识。
来源证据TSR同一失败修3文件50行,两开发种子均成功;flat两个候选各只1/2,未发布。 表4–5 ↗
我的解读这是小样本机制案例而非大规模层级归因消融。多角色36/50与单角色9/50也是全程累计覆盖,不是独立episode概率。
来源证据ACT用10个bell、7个alarm演示,同架构1万步;相对动作bell4/10、alarm训练6/7及留出2/3,绝对动作均零。 4.5.5;附录C.3 ↗
我的解读动作表示可能改善小样本学习,但只有三个留出alarm布局,不能推广泛任务迁移或策略自我学习闭环。
开放情况与使用许可
nssmd/RoboRSI仓库有roborsi实现、scripts、tests、Docker及CLI/Web入口,Apache-2.0许可证已核对。公开复现脚本运行当前冻结版本,不重演论文在线累计轨迹;README部分数字属于旧的adaptive口径。
LICENSE代码Apache-2.0,论文与图2 CC BY 4.0。外部模型服务、仿真基准与第三方组件有独立条件,仓库开源不等于全部实验环境或模型权重可自由复现。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
LIBERO-Plus明确冻结LIBERO来源技能,354/840=42.1%,比OpenETA306/840=36.4%高5.7个百分点,是区别于在线改进的迁移证据。
代码合并的600匹配episode从129到174成功,差7.5个百分点,95%CI[3.7,11.5];86对仅Code-on成功、41对仅Code-off成功。
反方 · 哪些结论还不够
LIBERO、LIBERO-PRO和RoboTwin是在评估流上更新技能,而基线固定;优势含额外开发、诊断和校验能力,不能写成同预算冻结策略全面领先。
TSR局部性推导要求图捕捉全部依赖、无未追踪共享状态改动,仅界定影响范围,并不保证受影响任务不会退化。
实机回归使用最近四个合格运行的离线回放,没有重新物理执行全部旧任务;104轮变化任务没有冻结统一分母。
综合判断
有用的贡献是把失败证据、责任边界与技能发布连接起来。最扎实证据来自匹配代码合并实验和冻结迁移;完全自主、稳定持续改进的结论仍超出实机开发记录。
我会先做的验证
建议实验(尚未执行):按总模型调用、验证和机器人时间匹配在线自改进基线;在未见任务上冻结评估,多轮交换任务顺序,记录回归率,并以真实物理复跑验证离线回放通过的补丁。