Encoded but Not in Control:机器人记住了新指令,手却仍伸向旧目标
固定场景的目标替换,比原任务成功率更直接检验语言是否控制动作
研究在固定场景中把合法抓取目标换成另一件可见物体,发现四种VLA/世界动作策略仍主要选择原目标。与此同时,指令变化会影响内部动作预测,线性探针也能读出新目标。语言敏感、信息可解码、真正按新意图行动因此是三种不同能力。
图解主要方法
同一场景中换一个可执行指令,机器人是否真的改选目标?
- 1
先固定世界,再改变一个合法目标
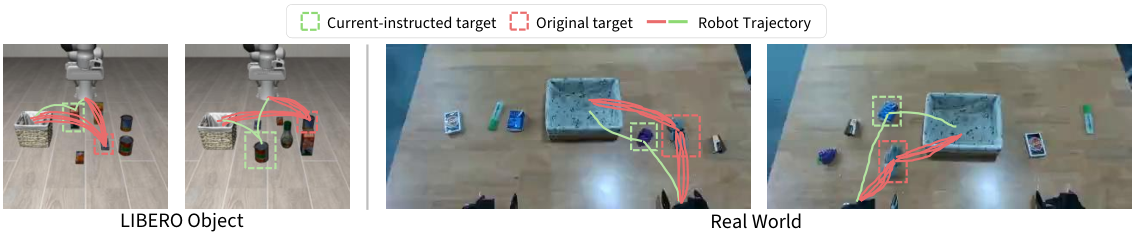
图1绿框表示当前指令目标,红框表示原目标。LIBERO-Object保留场景初态、机器人状态、操作方式和目的地,只把目标换成同场可见可达物体;这测试语义是否能重新选择行为。随机名词与随机句子另作敏感性诊断,不能当作同类可执行任务。
- 2
把接近目标与真正完成分别统计
Tend记录明确接近或操作尝试,Success要求完成任务,并同时统计新目标和旧目标。随机文本实验仍按原任务谓词判成功,因此成绩下降只表示输入影响了行为;只有合法替换后完成新目标,才能直接支持遵循当前意图。
- 3
用配对动作重放和探针检查语言是否丢失
每模型选一条原指令成功轨迹,固定观测、缓存和起始噪声,重放不同指令而不执行反事实动作。把冻结动作读出施于各层状态,计算归一化动作坐标MSE;另对指令token平均表示训练岭回归,分别预测新目标和场景,区分“有信息”和“按信息行动”。
- 4
以注意力与共享分解定位,但保留因果边界
注意力分析汇总经过输出投影的加权value向量,再按来源归一化。UMAP展示每个检查点内部聚类;共享半NMF用12个共同基底分解微调前后表示,比较场景与目标各自解释的方差。这些都是表征诊断,不是已证明的控制通路或修复算法。
实验与证据
完整阅读正文和附录A–H,核对图1与首发页,检索本研究专属代码;论文链接的基础模型仓库不当作本研究评测代码。未独立执行机器人测试。
来源证据四策略π0.5、GR00T N1.7、FastWAM、LingBot-VA均测仿真,真机只测前两者;各模型保留原生观察和动作接口。 第3节、附录A ↗
我的解读不能把四模型仿真证据扩大成四模型真机结论。模型间原生实现不同,最稳健的比较是同模型固定条件下换指令,而不是跨模型数值排名。
来源证据表1四模型新目标成功依次11.5/0.5/0/1.3%,原目标69.5/90.9/95.0/84.4%。 表1、第4.1节 ↗
我的解读正文原目标范围上限有95.3%的写法,而表1为95.0%;此处采用表1,避免不加辨别复述。核心差距很大,但样本数和误差区间仍应完整披露。
来源证据RoboTwin 50任务,每任务100rollout;同模型各指令条件保持种子、配置和时限。表征分析LIBERO为10场景×6目标=60,真机6×6=36。 附录A.5、C、D ↗
我的解读这些60/36是表征条件数,不是闭环行为试验分母。所读附录未清楚列出目标替换各单元试验数,不能从百分比反推并当成已确认样本量。
来源证据岭回归正则在训练集5折选取10⁻³到10,报告留出集准确率;指令词token平均池化后做逐维z-score。 附录D ↗
我的解读小数据高维读出可显示可访问性;论文未明确留出比例、是否留整场景及标准化统计量仅来自训练集,独立重现应补齐这些信息。
来源证据动作lens每模型仅一条成功LIBERO-Object轨迹,不执行反事实动作;π0.5为10去噪步×18层,GR00T为4×32,另两模型10×30。 附录E、表7 ↗
我的解读MSE在模型各自归一化动作坐标上计算,不是物理距离;后续去噪状态已随指令分叉,因此不应解读为单层孤立因果效应或跨模型统一尺度。
来源证据π0.5的指令贡献份额LIBERO为25.6–27.9%、RoboTwin约1.7%、真机9.7%;共享半NMF拟合12个成分,加性场景/目标回归不含交互。 第6节、附录G ↗
我的解读注意力份额受归一化、token分组及上下文混合影响,不等于因果重要性。半NMF的共享解释量可为负,且普通R²来自已观察条件;应避免把图上移动解释为真实控制能力损失量。
开放情况与使用许可
2026-10-11核对全文、arXiv首发页及精确标题检索,未确认作者专门发布的评测代码、干预轨迹或分析权重。附录列OpenPI、Isaac-GR00T、FastWAM、LingBot-VA、XPolicyLab等基础实现;这些公开仓库不等于本研究已开源。
LICENSE论文arXiv非独占托管许可;本研究专属代码与数据的许可尚未确认。基础模型各自许可不能代替本研究产物许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
LIBERO-Object换成新目标后,四模型仍有86.5–98.3%的试验接近或尝试操作原目标,新目标任务成功仅0–11.5%。
真实场景两模型新目标成功为5.8%和3.3%,原目标为74.2%和90.8%;说明所测失败不只存在于仿真。
反方 · 哪些结论还不够
随机名词可能连目的地也替换,随机句子可能根本不可执行;它们只诊断语言依赖,不能与合法目标替换合并解释。
动作lens复用终层读出到中间层,未校准且只重放一个成功轨迹,差异大不代表更接近正确动作。
近满分探针不证明目标被策略因果使用;微调后场景聚类增强也不能单凭相关图证明失败来自场景捷径。
综合判断
有力之处是行为干预:任务成功率不能代替当前意图控制。内部分析提供合理的定位线索,但缺少干预验证和充分复现细节,尚不能宣称找到了唯一故障机制或修复方案。
我会先做的验证
建议实验,未执行:在新场景、未见指令模板和严格留场景划分下训练探针,训练集独立拟合标准化参数;做目标方向激活替换与对照随机方向干预,并在配对多种子闭环中检查是否真正增加新目标成功,而非只改变注意力或动作距离。