机器人元推理:什么时候该继续算,什么时候必须行动?
在世界不停变化时学习规划计算预算
这项工作让策略选择一次动作持续多久,并利用这段时间继续规划,从而把计算延迟纳入控制问题。导航与吊载飞行仿真显示明显收益,但 Push-T 中最好的固定预算与自适应方法相当,真实导航展示也缺少量化试验规模。
图解主要方法
在世界不停变化时学习规划计算预算
- 1
将计算与执行放在同一时间轴
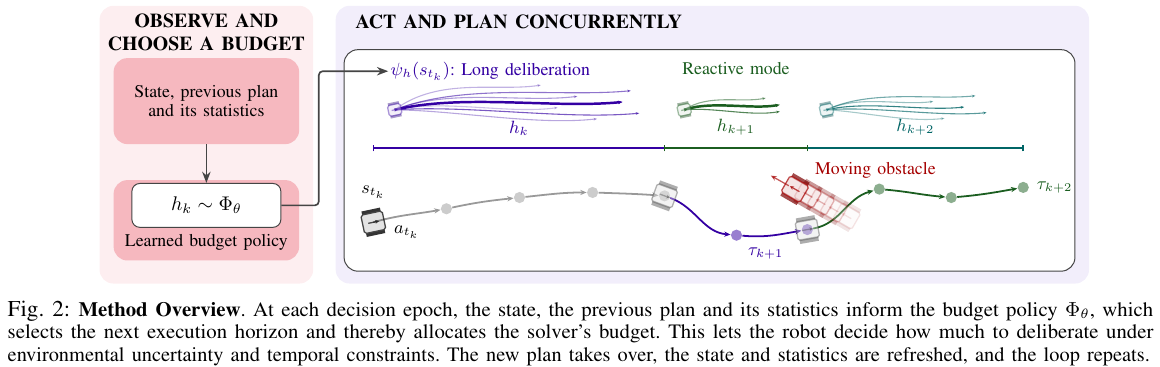
图2中机器人先选执行时长 h,执行现有计划的同时让规划器获得相应计算时间。到下一决策点才更新动作,环境不会为更多推理暂停;底层 MPPI/CEM 求解器保持固定,学习的是预算而非一套新的动作库。
- 2
让预算策略读取规划诊断
输入包含物理状态、旧计划、前次时长及规划统计,如有效样本量、最早不可行位置和模型误差。统计反映求解过程是否集中或不稳定,但低有效样本量并不必然意味着计划质量差,需要结合任务解释。
- 3
用半马尔可夫目标计入耗时
PPO 的回报与优势计算按实际 h 使用时间折扣,鼓励在安全时多计算、在变化快时及时响应。论文的漂移界依赖 Lipschitz 与模型条件,是分析工具,不能替代实际碰撞约束。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据三个场景各100回合,自适应成功率97%、100%、99%,固定 h=5 为73%、63%、92%。去除规划统计的一项对比从98%降至86%,仅统计而无状态为74%。 导航仿真与信息消融 ↗
我的解读统计与物理状态互补;场景合计300回合不意味着每项消融都重复了同一规模,报告应保持各自实验口径。
来源证据吊载飞行20回合中成功80%,测试的固定预算条件均失败;Push-T 使用16个匹配试验、600步,自适应与最佳固定策略位置误差均约0.65±0.48厘米,自适应实际上常选 h=8。 跨任务结果 ↗
我的解读飞行显示收益可能很大,Push-T则说明有些任务不需要变化预算;不能把三类任务都写成全面超越固定策略。
来源证据实现采用 A100 40GB、JAX/MJX,导航、飞行、推块控制时间步分别为0.1/0.02/0.04秒。RoboMaster 迁移展示主要是定性结果,部分性能图只统计成功轨迹。 计算条件与真实展示 ↗
我的解读硬件速度和控制周期共同决定有效预算;成功轨迹筛选可能隐藏失败代价,真实演示不是已量化的可靠性证明。
开放情况与使用许可
论文 CC BY 4.0;匿名仓库 README 声称提供仿真、训练、测试和部分检查点,明确不含 ROS 部署及实验档案。后续文件和许可请求返回403,未核实完整实现及许可,不据 README 标为开源。
LICENSECC BY 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把计算资源视为闭环控制变量,能够直接回答机器人推理“算得更久是否值得”,而不是仅比较离线规划最优值。
反方 · 哪些结论还不够
理论边界依赖模型与估计条件,现实计算抖动和通信延迟仍可能改变策略。实机证据有限,部分任务最佳常数预算已足够。
综合判断
适合规划时间确实影响反应速度的系统;需要在真实计算预算和失败成本下证明收益,而非假设自适应总优于常数。
我会先做的验证
未执行的验证方案:注入可测的计算和通信抖动,用相同实际算力比较预算策略与事先调优的固定策略,报告所有回合的碰撞、超时及动作平滑性,并检验陌生扰动。