RoboTok:按手的运动检索视频,而不是只匹配画面
回顾补收:从人体轨迹到仿真灵巧操作奖励
RoboTok 将人的手部轨迹压成可检索表示,再把相似动作变为机器人训练的引导。本文解读 09-02 的 v1;当前项目页另含后续展示,不能将不同版本的指标和真机演示直接拼入 v1 实验。
图解主要方法
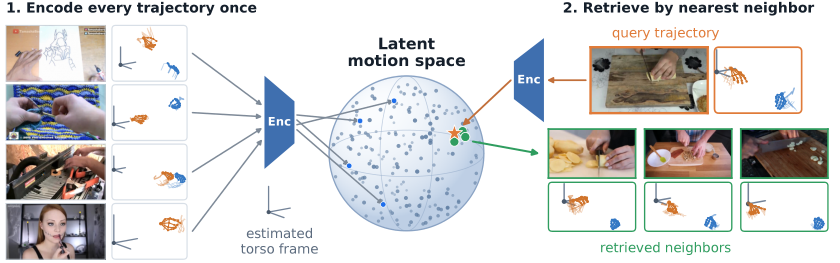
图 3 如何从一次编码的手部轨迹获得可迁移的动作邻居?
- 1
抽取相对躯干的手部轨迹
从约十万段 4–8 秒、手可见且相机近静止的视频,结合 WiLoR、MoGe2 与 HaWoR 估计公制手部运动;缺失躯干时由手腕等估计参考系。去除绝对相机位置有助于运动匹配,但姿态估计错误仍会传播。
- 2
以 DTW 构造检索监督
对 21 关节轨迹做按长度归一化的动态时间规整,离线生成动作相近与相远样本。它提供的是几何运动相似性,不是物体功能或任务意图的真值;两段相似手势可能用于不同任务。
- 3
用学习到的向量替代在线 DTW
交叉注意力池化将变长轨迹映射为固定嵌入,训练批次按锚点、近邻与边界负例组织。数据库预编码后用余弦相似度检索,在线无需逐段对齐;离线姿态抽取及邻居计算仍有成本。
- 4
将人手邻居转成机器人状态引导
检索轨迹经重定向映射到灵巧手状态,以加权近邻距离构造势函数 Φ。PPO 奖励既含势差项,也含持续的 βΦ 项;后者意味着不能直接套用纯势差奖励不改变最优策略的保证。
- 5
用更难设置辨别引导是否有效
VTDexManip 仿真提供本体状态、指尖力及历史,困难任务加入自由三维腕运动并去掉部分手工奖励。检索结果只是训练塑形,不是从视频直接复制出可安全执行的真机策略。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【检索】十万视频片段、约一万留出片段,mAP@20 为 0.3531,STRAP 为 0.0071;AssemblyHands 传感器轨迹上 mAP@5 为 0.2614 对 0.133。 表 2、发布说明 ↗
我的解读我的解读:几何监督契合几何检索指标。README 提醒拆分按片段而非源视频,存在同源片段泄漏风险。
来源证据【指标定义】Recall@20 为 0.996。 检索指标定义 ↗
我的解读我的解读:这里衡量前二十中是否命中至少一个相关项,不能翻译为找回了 99.6% 的全部相关视频。
来源证据【困难仿真】每对象八个策略种子、各百次尝试,已见瓶子成功率 77.3±3.5%,对照 59.5%;水龙头 44.8±4.1%,对照 6.8%。 困难任务表 ↗
我的解读我的解读:奖励引导对部分困难任务作用明显,但这仍是指定仿真环境。
来源证据【反例】原设置未见物体的 handover 为 34.8%,低于随机检索 42.1% 和 HAND 39.3%。 泛化结果 ↗
我的解读我的解读:动作相似并不保证跨物体功能迁移,不能只展示提升最大的任务。
开放情况与使用许可
已打开 RoboTok-Code 的实际检索模型与训练实现,代码 MIT;模型仓库含 best_model.pt 与评估关键点文件。权重及关键点采用 FAIR Noncommercial Research License v1,MANO/SMPL-H 另有条款。不能把源码 MIT 扩大为全部数据及模型可商用。
LICENSE检索代码 MIT;权重与评估数据限非商业研究,人体模型另行许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
运动表示将检索目标从背景、外观转向动作几何,并通过仿真控制验证部分用途。
反方 · 哪些结论还不够
姿态误差、按片段划分及 DTW 代理目标限制证据;奖励还有非纯势差项,真机可执行性不能由 v1 仿真结果推出。
综合判断
适合人类操作视频库的运动搜索和训练提示;需要独立视频划分及物体功能条件才能更可信地用于机器人数据选择。
我会先做的验证
未执行的验证方案:按源视频和拍摄者彻底划分,以相同背景、不同动作以及同动作、不同物体建立难例;对比纯势差与持续势奖励,并测真实机器人碰撞率。