RoboValue:机器人价值分数升高,真的代表任务在进展吗?
用反事实指令、倒放、重复动作和恢复失败,拆开看似优秀的价值评分
35项仿真与真实操作任务、2792条测试轨迹,将机器人价值模型拆成任务理解、时间进度、失败恢复与价值一致性。结果表明成功判断和正向进度可以很强,却不理解改写指令、重复次数或恢复是否奏效;不能用单个总分替代在线控制可靠性。
图解主要方法
用反事实指令、倒放、重复动作和恢复失败,拆开看似优秀的价值评分
- 1
围绕同一任务制造诊断对照
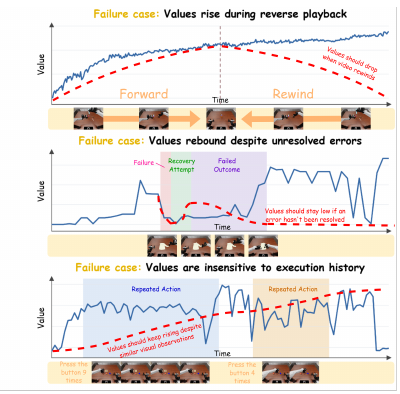
15仿真、20真实任务各提供100条专家训练示范,总计3500。测试包含成功、错误延续、有效及无效恢复、重复视觉状态和多种合法顺序;机器人形态与环境变化分别测试。图2上中下依次揭示倒放仍加分、恢复未成功却反弹、重复动作不记次数。
- 2
统一接口但保留原生语义
适配器提供高值代表更接近目标的标量、成对比较和可选子任务文本。RynnValue取剩余时间负值,RoboMeter使用进度头而非原生成功头,RoboReward保留五档离散值。零样本无参考适配;单样本只用一条训练示范作参考或LoRA,不能解释为完全相同输入。
- 3
拆开目标、顺序与记忆
TGA-CF保持视频不变,分别改对象、动作、摆放和约束,原指令增益须严格超过四种改写,平分也失败。Cycle-VOC将前进和倒放连起来保留历史,Memory-VOC考察相似画面但不同完成次数。单看与时间相关的VOC无法证明理解状态。
- 4
单独审查失败与恢复
FPL以5Hz采样、最大下降段定位错误,按轨迹长度归一化时间误差;TRR对同一初始错误的延续、成功恢复、失败恢复逐阶段检查趋势,全部阶段符合才算该分支通过。稳定性VS与跨合法顺序的子任务贡献CSVC再揭示抖动和不一致。
- 5
审计排行榜权重
任务内汇总后按任务平均,仿真与真实等权。排行榜部分指标按ID/跨形态/跨环境的1/2、1/4、1/4权重组合;缺失指标归零。RoboReward未测VS与CSVC因此受零分影响,排名不是纯模型能力的唯一排序。
实验与证据
已阅读89页PDF正文及附录A–I、任务卡和分任务结果表,核对实验条件与原图;未独立复现。
来源证据TOPReward-8B正向VOC94.29、Memory-VOC95.51,但Cycle-VOC只有13.50;RoboMeter-4B的VOC86.05、Cycle-VOC89.43,Memory-VOC仅2.36。 主表 / 域内总体诊断 ↗
我的解读高正向相关可能没有跟随状态倒退;时间戳捷径属于待验证解释,论文未用消融证明其唯一原因。
来源证据Robo-Dopamine2.0-8B Preview单示范VOC93.05、Cycle-VOC93.74,但反事实指令TGA-CF仅1.23;RynnValue-4B对应反事实56.01。 主表 / 指令敏感性 ↗
我的解读参考示范可能压过语言约束,但不同适配器与价值定义也影响结果,不能等同于机器人真实成功率。
来源证据模型整体失败定位误差约34%,均匀随机时间点约32%;TRR对失败恢复要求尝试阶段上升、失败结局再下降。 失败与恢复 / 指标定义 ↗
我的解读定位任务仍薄弱。恢复尝试应否先升高本身是该基准的价值定义,不代表所有风险敏感价值函数都应遵循。
来源证据4个模型、固定任务子集、11组单参数扫描,在仿真126/132、真实126/130对模型排序保持;临近分数仍会交换。 附录G / 参数敏感性 ↗
我的解读结论对测试范围较稳,但不是全部任务、所有模型、任意阈值的保证。VS绝对值随采样密度改变,比较必须同设置。
来源证据失败轨迹人工控制主要错误,恢复分支尽量匹配;SIA经DeepSeek-V4-Pro给正确子任务标签概率并作几何平均。倒放可能非物理可执行。 采集与评价边界 ↗
我的解读数据适合诊断,不代表自然策略失误分布;SIA不是普通分类准确率,也没有证明在线闭环奖励会改善控制。
开放情况与使用许可
已核对GitHub适配器与评测代码、MIT许可证;HF存在仿真/真实的单样本和全样本训练文件。私有测试集不公开下载,团队通过模型推理服务评测。HF元数据未列数据许可证,不能把代码MIT自动扩展到视频数据或称完整数据集开源。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
机器人学习依赖奖励与进度信号;把“完成得像不像”“做了几次”“是否遵守指令”和“是否真正修复错误”分开,直接暴露会误导策略优化的反馈缺陷。
反方 · 哪些结论还不够
公开测试集仍由团队保留;模型适配、缺失指标记零及人工设计的恢复趋势影响比较。离线视频评价不等于在线安全、真实纠错收益或跨任务通用性。
综合判断
适合作为价值模型诊断协议,尤其应关注正向高分与反事实/恢复低分之间的落差;选型应按目标场景分项验证。
我会先做的验证
未执行的验证方案:加入时间戳打乱、无动作等待、相同状态不同历史及自然策略失败;人工复核SIA和失败边界,再固定策略做在线奖励消融,测量真实成功率、误奖励与接管次数。