RPMem:将跨会话记忆压进可迁移的低秩适配器
固定容量的在线写入,不代表无成本更换骨干
RPMem 用冻结编码器与学习到的编译器把会话写成固定形状记忆,再由任务训练的逐坐标门控累积,解码为当前骨干的 LoRA。它避免每次查询重读历史,但更换骨干仍需要训练专用解码器;可迁移性与零训练迁移是不同承诺。
图解主要方法
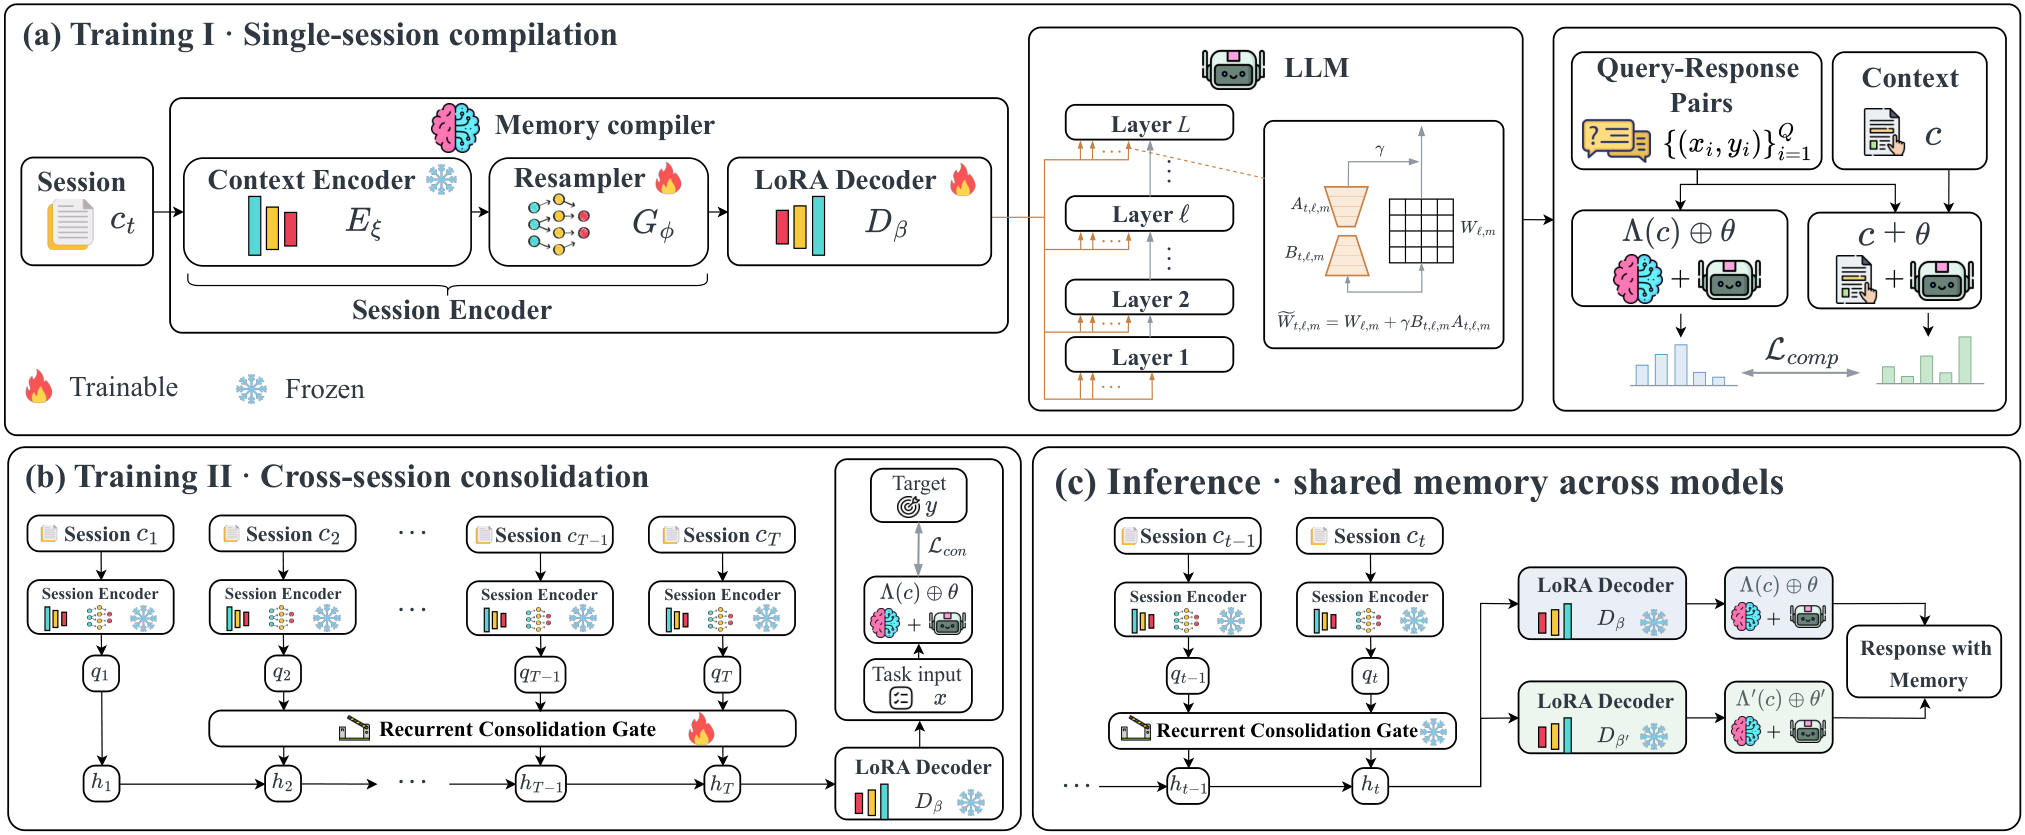
图 1 的编译、巩固和部署分别更新哪些参数?
- 1
单会话编译:匹配读历史时的回答分布
ModernBERT-base 冻结,Perceiver 将不定长会话压为 36×1×8×512 的记忆。原模型读历史产生教师分布,适配后的模型只看问题及相同回答前缀;保留教师 top-32 token 与剩余总概率做前向 KL,避免只学硬答案或遗漏尾部概率。
- 2
门控巩固:逐坐标决定保留与写入
首条直接初始化 h;之后 z=sigmoid([旧记忆;新记忆]W+b),h=z·旧+(1−z)·新。共享门控有 524800 参数,仅以任务训练侧答案交叉熵学习,问题不直接输入门控。部署后参数冻结,记忆值通过前向计算更新。
- 3
解码低秩参数供查询使用
每层 down_proj 接收生成的 rank-8 因子,另有共享 rank-8 偏置块,实际拼接宽度 16。生成的 A、B 调整冻结骨干,历史不用占查询 token;代价是每用户参数状态与共享编译器常驻,记忆也不像文本记录那样容易检查或逐条删除。
- 4
更换骨干:先训练新解码器
保留编码器和潜在记忆空间,将新骨干的层数、宽度交给目标解码器适配。附录每个目标仍用 664128 会话训练一轮、10377 更新;配对表还为各编译器单独拟合门控,因此表中迁移收益主要证明编码器复用,不等于任意线上状态原样切换已充分验证。
- 5
理解固定容量与成本范围
64 会话热写入包含新会话编码、门控及 LoRA 生成;所有模型已驻留。查询耗时是选择题前向,不是开放式长回答总延迟。累积内存固定不保证无限长历史无损,超出实测会话数仍需检查容量饱和。
实验与证据
以下为作者报告;已阅读 v2 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【表 1】Qwen3-8B 非思考模式,PERMA 十个模拟用户留一评估,Core 85.52%;Metis-9B 80.20%,Full Context 72.54%。 §3、附录 D/G ↗
我的解读我的解读:RPMem 接受本基准任务监督,Metis 使用原发布权重,公平性不能仅按规模判断。
来源证据【其他基准】PersonaMem-v2 的 5000 题 Overall 为 40.22%;PrefEval 300-turn 为 74.81%,10-turn 为 69.81%,低于 LightMem 81.30%。 表 1 ↗
我的解读我的解读:优势依赖历史长度和任务;不能把固定容量直接解释为所有记忆工作均占优。
来源证据【热部署】64 会话时写入 0.043 秒、36.562 MiB;rank 拼接对照每次重新编译全部历史。 表 3、附录 D.5 ↗
我的解读我的解读:约 22 倍写入差距包含对照重编译策略,不是所有增量缓存实现的必然劣势。
来源证据【迁移成本】目标解码器需约 6.74–38.42 小时,分别分配 8 或 32 GPU;原编译器约 338 GPU 小时。 附录 F ↗
我的解读我的解读:复用降低后续训练成本,但既不是免训练迁移,也不应把训练与在线毫秒级写入混在一起。
来源证据【通用能力】IFEval 从 81.70 降至 77.89。 表 4 ↗
我的解读我的解读:记忆适配有可测干扰,应保留无记忆基线和关闭适配器的路径。
开放情况与使用许可
论文提供 Quark-Medical/rpmem 地址,本次页面与 GitHub tree API 未成功取得可用实现(API 404);未核实权重与许可证,不能把论文中的 implementation available 当成已开放证明。
LICENSE代码、权重许可待核实;论文许可见图注。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把记忆编码和骨干解码分开,并以尾部概率蒸馏与逐坐标门控训练,使持久状态与模型更换之间有了明确接口。
反方 · 哪些结论还不够
任务监督、选择题基准、固定容量与目标解码器训练限制了无条件通用性;附录迁移评估重新拟合门控,需要独立实流切换实验。
综合判断
值得作为长期个性化的固定容量基线;部署前必须同时验证迁移连续性、遗忘请求、可审计性和通用能力损失。
我会先做的验证
未执行的验证方案:用从未训练过的用户流保持同一 h 和门控,仅切换预训练好的目标解码器;在切换前后插入冲突、删除和数百条干扰,再以开放问答和逐事实召回比较文本记忆。