RynnUnify:先决定是否想象未来,再把世界表征接到机器人
统一推理与视频生成,在哪些任务上真正帮助动作规划?
RynnUnify将8B推理器和8B视频生成器组成16B统一模型,用场景记忆支持长程视觉规划;另训练分支路由Agent选择直接回答或调用生成,再扩展成世界—动作模型。真实机器人结果有提升,但视觉规划分数、问答分数与机器人成功率必须分开解读。
图解主要方法
统一推理与视频生成,在哪些任务上真正帮助动作规划?
- 1
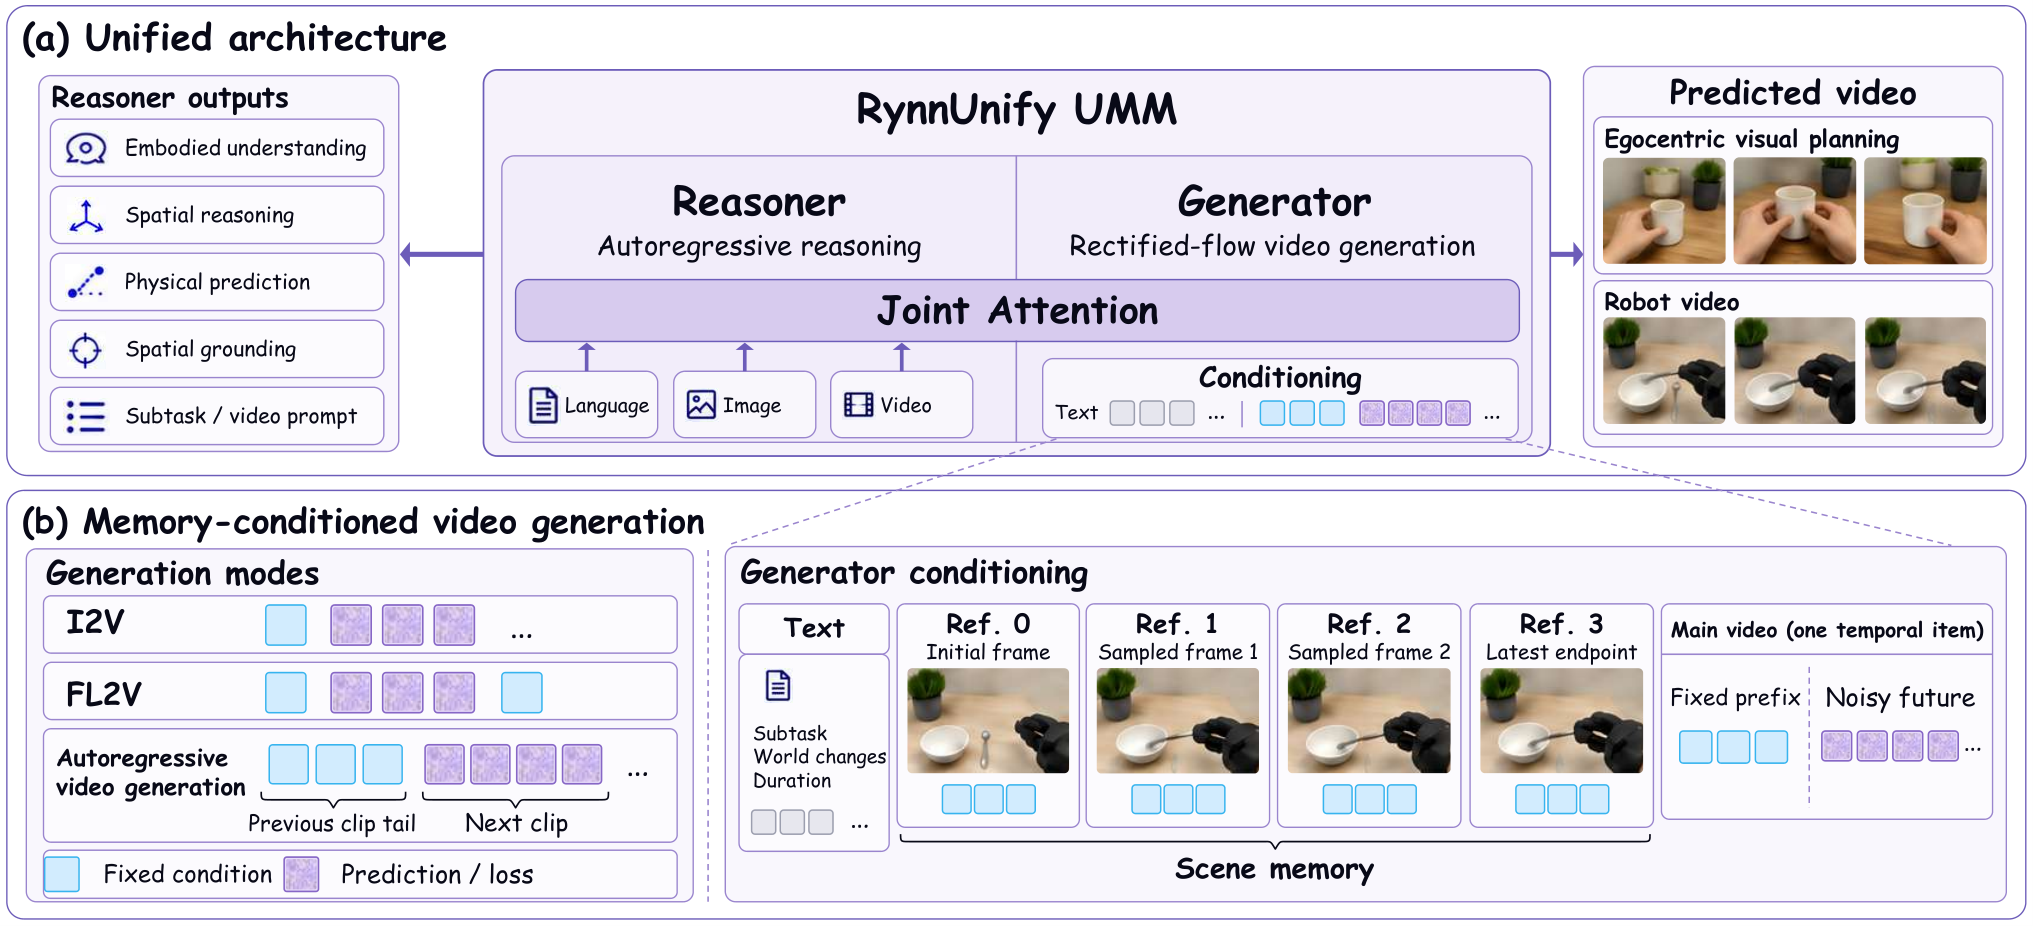
1 · 图2:共享注意力,保留不同生成机制
自回归Reasoner产出子任务、描述与时长,rectified-flow Generator利用联合注意力读取推理表征生成视频。二者分别8B;额外用于分支训练的8B Agent不能混称为16B模型内部多出来的一块。
- 2
2 · 用记忆和前缀连接视频片段
场景记忆保留初始帧、两张历史帧和最近帧,并以13帧时间前缀维持运动衔接。生成器训练注入条件噪声,并使用离线缓存的预测起点与历史;这是固定缓存训练,不是每轮即时刷新自身rollout的完整在线self-forcing。
- 3
3 · BCPO分别学会回答与选择分支
每道可路由题采样四条直接回答、四条生成辅助轨迹,分支内比较奖励改进回答,分支间均值指导路由。只更新Agent、冻结生成器。生成视频可能引入几何误差,因此“需要时才想象”比所有问题强制生成更合理。
- 4
4 · WAM从中间表征预测动作
先做一次视频去噪并再提取36层特征,18块动作头每块读取两层,预测48步12维动作,执行前16步;姿态辅助只用于训练。论文在1600条原子任务与177条复合任务数据上构建相应训练,动作执行证据不能用视频好看来替代。
实验与证据
已阅读完整PDF正文,以及训练与评估相关附录C、D、E,核对实验条件与原图;未独立复现。
来源证据200个第一视角任务,整体分数=0.5规划+0.4实现+0.1视觉质量。Cosmos3为45.05,RynnUnify54.80;组合系统Terra+MiniMax为65.71。视觉质量79.69→77.53。 表4:Rynn-VP ↗
我的解读优于所测统一模型不等于超过所有组合方案,也不是54.8%的机器人成功率。
来源证据Rynn-GEU均分44→50,但位置38.5→36.0、距离52.9→51.8、尺寸57.0→56.5。 生成增强问答 ↗
我的解读区域与轨迹收益不能遮住精细几何退步;生成内容仍需受原始观测约束。
来源证据Astribot三任务各20次,全任务成功率55%、35%、50%,平均46.7%;π0.5平均25%,GR1.7平均26.7。RoboCasa选定20任务共200回合为51.5%。 机器人实验 ↗
我的解读真实实验规模有限;分阶段完成率与整任务成功率不同,模拟比较还包含引用的已发表基线结果。
开放情况与使用许可
官方仓库含BCPO、VisualPlan实现,Apache-2.0;HF上Base、Agentic-Reasoner与WAM-RoboCasa均有实际safetensors分片,模型卡标Apache-2.0。第三方基础模型与组件条款仍须分别遵守,未声称全部真实机器人部署代码已公开。HTML在数据节截断,本次以完整PDF读取后续方法、实验及相关附录。
LICENSECC BY 4.0(论文及原图)
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
模型、路由和动作头形成一条可检查的链路,并给出真实执行结果,比只展示未来视频更接近机器人使用条件。
反方 · 哪些结论还不够
视频质量与几何判断仍可能退步;长期规划使用机器评审和有限人工核对,不是真实环境的闭环成功。真实任务仅三类,也没有证明广泛安全性和长期鲁棒性。
综合判断
是值得跟踪的统一具身架构;优先验证“生成何时有害”与世界表征对动作的净收益,而非把所有分数归纳成通用机器人能力。
我会先做的验证
未执行的验证方案:在相同初始状态重复直接策略、强制生成和BCPO路由三组,分成功率、接触错误、位置误差、推理时延统计;对同一WAM动作头移除世界特征并控制训练数据,测其实际贡献。