RynnVLA-Latent:先从视频学潜动作,再对齐机器人
三万小时异构视频如何转成带三维约束的策略预训练信号
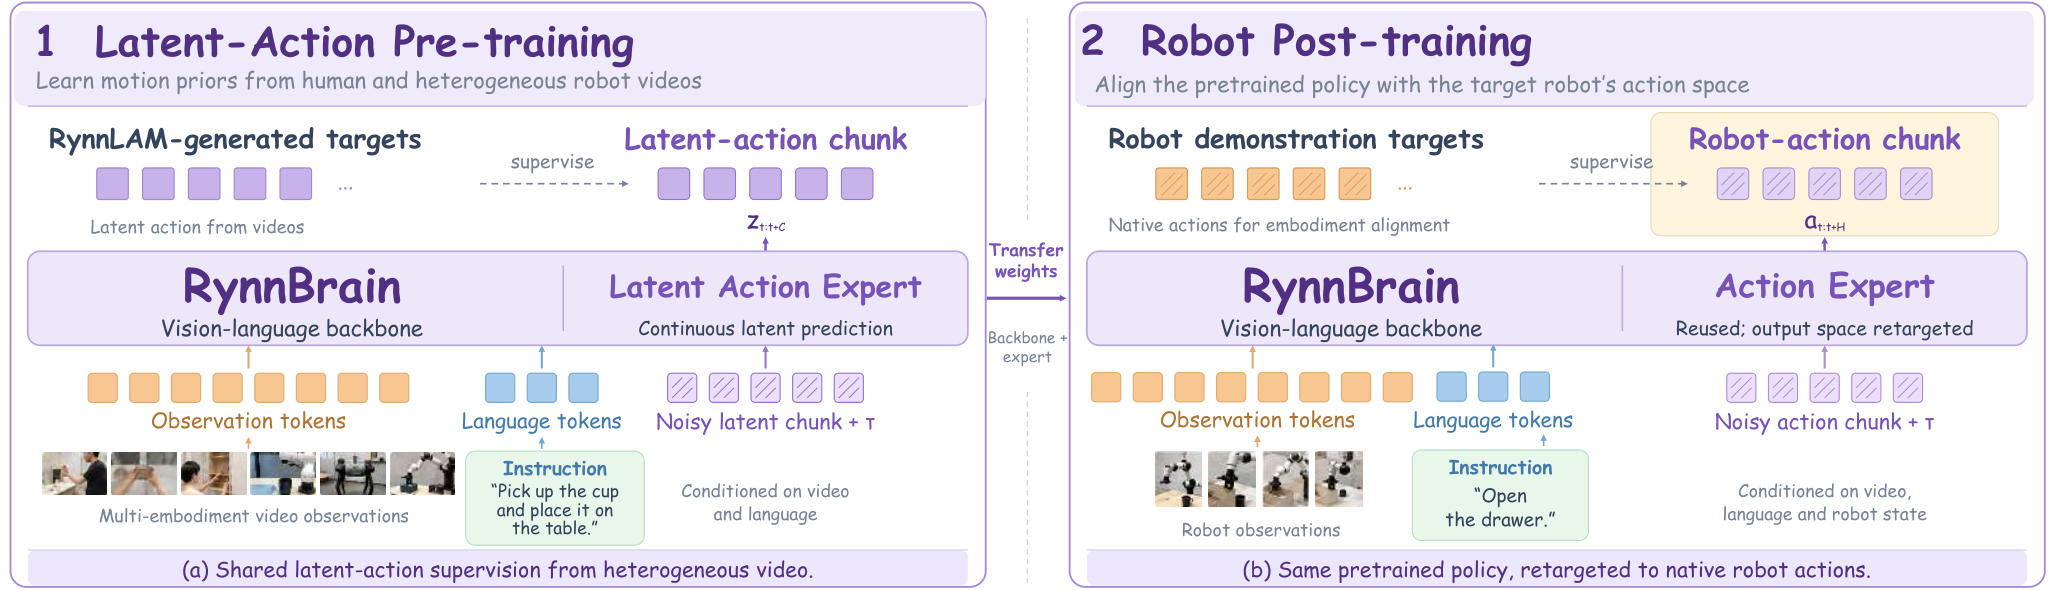
人类和不同机器人的视频没有统一控制接口。RynnVLA-Latent先用三维视觉教师学习连续潜动作,再让VLA预测潜动作片段,最后用本体示范对齐真实控制。公开的第一阶段权重输出潜动作,不是下载即用的机器人策略。
图解主要方法
三万小时异构视频如何转成带三维约束的策略预训练信号
- 1
图4左上:用RynnLAM将视频变成潜动作
对相隔4帧的视觉变化编码,借助DA3特征、相机补偿的深度与光流监督学习运动表示。完整描述符为608维:512维运动token、64维动作和32维相机表示。相机分支显式存在,所以不能将整个描述符称为相机不变;伪三维监督也不等于真实控制标签。
- 2
图4左下:统一异构观察条件
汇集25来源、约30,118小时视频,形成约7.455亿潜动作描述符。VLA用语言与多视角图像预测6个目标组成的潜动作块,视角槽和掩码处理相机数量差异。预训练不需要各机器人的动作或本体状态字段。
- 3
图4中:用流匹配学习连续目标
RynnBrain视觉语言骨干与较窄的动作专家耦合,从噪声恢复潜动作;图中latent-action expert承载动作建模。所谓4B按骨干命名,模型卡给出的整体参数实际约5.042B;不能用4B称呼隐去专家开销。
- 4
图4右:再把潜动作目标换成控制目标
第二阶段引入机器人示范、本体状态及动作投影,保留预训练策略与专家,改为预测本体原生动作。这个步骤仍消耗有动作标注的数据。官方Stage-1检查点没有闭环控制所需schema,基准适配器也明确拒绝直接用它跑控制。
实验与证据
已阅读全文及附录A–F,核对实验条件与原图;未独立复现。
来源证据4B策略LIBERO为98.8%,LIBERO-Plus为84.7%;后者含10,030个扰动测试,未针对Plus额外适配;对照π0.5为84.4%。 表中仿真结果与评测设置 ↗
我的解读标准任务已接近饱和,0.3点差距不能证明稳健优势;个别相机和机器人状态扰动仍较弱。
来源证据清洁和随机设置各为88.7%、88.4%,平均88.6%;训练使用每任务50清洁、500随机示范,覆盖50任务。 表6:RoboTwin数字按表格保留 ↗
我的解读正文其他位置出现88.3等不一致表述,本稿采用表6与当前官方README一致的88.6,不拼接不同协议结果。
来源证据六个真实任务各35次测试、共3,850条示范;4B成功率从40.0%到85.71%不等。1,000小时受控预训练下Plus为84.2,LAPA为81.3,直接动作对齐为83.5/83.6。 真实实验与受控数据比较 ↗
我的解读视频潜动作有增益,但与直接对齐差距较小;小规模真实任务不能支撑普适可靠性或安全性结论。
来源证据相对重建MSE完整方法0.38,无三维光流0.50,无运动残差0.57;不同潜分量单独使用都更弱。 RynnLAM消融 ↗
我的解读支持三维辅助与分量组合有用,不证明各分量形成唯一、因果可辨识的动作语义。
开放情况与使用许可
已核对官方仓库的rynnlam、rynnvla、训练脚本和Apache-2.0许可;Hugging Face 4B模型有实际safetensors及Apache-2.0模型卡。公开的是Stage-1潜动作初始化,非论文各基准的即用Stage-2控制策略;原始大规模训练数据不随仓库完整提供。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:价值在于把没有原生控制量的异构视频接入策略训练,同时保留第二阶段明确的机器人适配接口,比直接声称视频等同机器人动作更可检验。
反方 · 哪些结论还不够
三维教师和视频源带来估计偏差;预训练规模、骨干和数据混合共同变化。大量公开权重尚不能直接复现闭环成绩,真实任务数量有限,原文有指标表述差异。
综合判断
可作为潜动作预训练研究起点;已有本体示范与验证设施的团队更适合尝试,不能视为零样本通用控制器。
我会先做的验证
未执行的验证方案:固定机器人示范量、骨干和训练步数,比较无预训练、直接动作预训练及潜动作预训练;按新相机、新物体、新本体分层报告成功率与碰撞,至少多种种子,并核对Stage-2权重来源。