ScaleNav:先从无动作视频学局部导航,再对齐机器人动作
视频预训练能否替代为互联网视频硬造伪动作?
ScaleNav先让视频模型学习第一视角运动与环境变化,再用少量模拟动作数据对齐动作头。目标是起始画面中可见物体的语言局部导航,并不是开放环境的长程探索。
图解主要方法
视频预训练能否替代为互联网视频硬造伪动作?
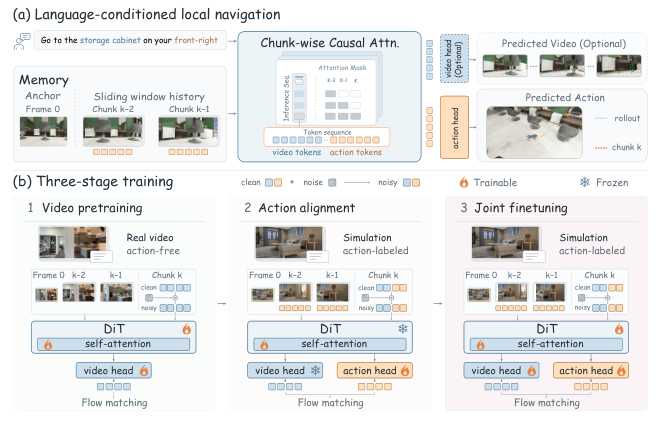
- 1
图2b第一阶段:先学导航视频
从互联网第一视角视频筛出约18.2K片段,训练Wan2.2-TI2V-5B的导航先验,逐步从双向注意力过渡到块因果结构;此阶段不要求视频附带动作标签。
- 2
图2b后两阶段:接入动作并联合调整
使用650模拟场景的2,600回合,先训练动作相关模块及自注意力完成对齐,再联合微调DiT;持续回放视频数据缓解遗忘,VAE与文本编码器保持冻结。
- 3
图2a:首帧锚点加最近真实观测
每轮保留初始视图与最近两个观测块,联合预测视频和9步动作。动作是4Hz的平面位移与转角;接回真实观测而非持续相信生成帧,以降低闭环漂移。
- 4
执行时考虑整块延迟
采样使用4步Euler;部署Go2时远程4090推理,在块间等待。停止由连续小动作触发,需要把网络与执行等待纳入控制安全预算。
实验与证据
已阅读正文与方法、实验相关附录,核对实验条件与原图;未独立复现。
来源证据单视角OVON 524回合、36场景成功率86.5%;HabitatGS-LN 157任务、45场景94.9%。目标在初始图中可见,1.25米内即成功。 Table 1、评测协议 ↗
我的解读结果不能直接与原始三视角OVON或精确接触目标的操作成功率相比。
来源证据去视频预训练时HabitatGS-LN为90.4%,伪动作方案73.9%;真实Go2三室内场景共60次为83.3%,去预训练65.0%。 Table 2、3 ↗
我的解读支持无动作视频先验,但真实样本仍少,不覆盖复杂动态人群与室外导航。
来源证据报告76毫秒/动作是9步块摊销,约684毫秒/块,另有网络和动作执行时间。 附录效率测量 ↗
我的解读不是每76毫秒重新观测纠错一次;闭环频率需要单独报告。
开放情况与使用许可
已核对实际代码目录与README:代码Apache-2.0,权重标CC BY-NC 4.0,标注与发布视频CC BY-NC-SA 4.0;基础Wan及场景数据另有条款,不能称整套可无条件商用。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把互联网视频的可扩展性与动作标注的稀缺性分开处理,消融支持视频预训练而非伪动作构造。
反方 · 哪些结论还不够
任务短程且初始可见,成功半径较宽;真实实验规模和安全覆盖不足。
综合判断
适合室内局部导航研究,不能作为通用自主导航已经解决的证据。
我会先做的验证
未执行的验证方案:在同一Go2上改变网络时延、障碍物速度与目标可见性,报告碰撞、人工接管、位置误差以及块级响应。