Seek:让相关性反馈改变下一轮检索
伪段落生成、检索、评分反复协作,输出仍是文档排序
一次召回遗漏的文档,单纯重排序无法找回。Seek 用已检索文档的相关性判断生成下一轮伪段落,重新搜索整个语料库,最终合并评分与检索分数;它研究的是检索排名,不是直接生成问答答案。
图解主要方法
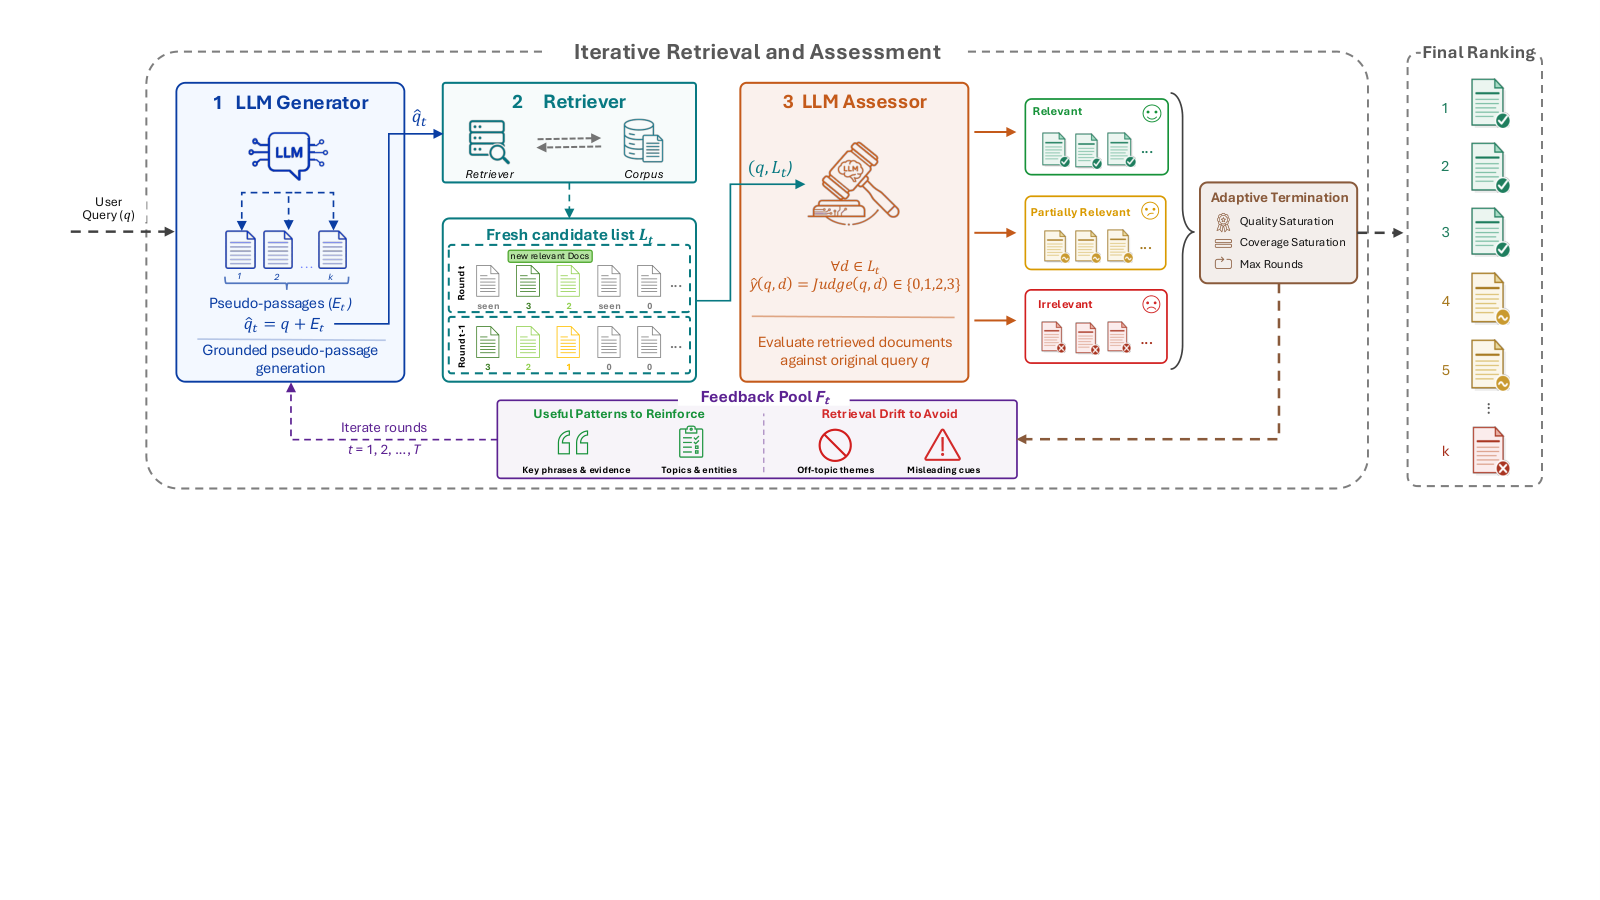
图 1 中评估器如何影响下一轮搜索,反馈错误又会怎样持续?
- 1
先生成可用于搜索的伪段落
图左生成器围绕原查询每轮生成五个伪段落,用于扩展查询并交给 BM25 或密集检索器。伪段落是搜索假设,不是已验证知识;循环中保留原查询以减少对偏离主题文本的追随。
- 2
只评估新出现的候选
图中每轮取前十候选,对此前未评过的文档按原查询给出 0–3 级相关性。生成器和评估器是同一个基础模型的不同角色,不能视为独立裁判。旧判断被缓存,所以初次误判可能长期影响后续搜索。
- 3
用分级反馈继续搜索或停止
图下反馈池把相关、部分相关和无关文档提供给下一轮生成器;默认最多五轮,前十全部最高相关或连续两轮候选集合不变也会停止。自评分饱和不代表真实召回已经完整,还可能是共同偏差造成的过早收敛。
- 4
按评分分桶形成最终排名
图右先排所有已评文档,按等级和跨轮最高检索分数排序,再放未评候选。即使等级为零也属于已评组;跨扩展查询的分数可比性、零分文档位置,都需要结合实际任务校准。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【BRIGHT 范围】仅评七个 StackExchange 子域;BM25 平均 nDCG@10 为 17.0,Qwen2.5 版 Seek 为 30.9,GPT-4.1 版为 37.4。 主表 1 与检索器消融表 2 ↗
我的解读我的解读:这是特定推理检索子集的排序收益,不能写成整个 BRIGHT 或回答准确率;不同基础模型的成本也不同。
来源证据【并非所有任务领先】TREC DL19/20 中 Qwen2.5 版为 71.6/65.1,部分强重排基线更高。ReasonIR 在 BRIGHT 子集从 24.8 到 32.3。 TREC 和 ReasonIR 实验 ↗
我的解读我的解读:迭代扩召回和更强初始检索都可能有帮助,但强基线下收益更小,不能只取相对提升最大的 BM25。
来源证据【预算与复现边界】最多五次全库检索与生成/评分,对照重排常固定为一次候选集;图 3 正文和图注的 Qwen 版本表述不一致。 评估设置与图 3 ↗
我的解读我的解读:缺少充分等 token、等延迟对照,不能把全部收益归因于反馈机制;该图的逐轮数字不作为跨配置统一结论。
开放情况与使用许可
官方仓库已存在 runner、生成器、评估器、融合和评测脚本及提示;代码文件可读,未确认独立 LICENSE 或通用商用授权。
LICENSE论文原图为 arXiv 非独占分发许可;仓库代码的再分发和商用许可未确认。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
反馈能改变候选集合,直接处理一次召回的覆盖上限;已有循环与评分代码便于进一步审计。
反方 · 哪些结论还不够
同模型生成与评分可能自我强化偏差,缓存误判难以恢复;完整成本与停止准则可靠性仍缺证据。
综合判断
适合高价值、召回不足的检索任务;落地前应和等预算多查询检索、重排序一起比较,而不是只对比原始 BM25。
我会先做的验证
未执行的验证方案:固定基础模型与总 token,比较无反馈多查询、Seek、反馈随机置换和允许重评旧文档四组;报告 Recall@100、nDCG、调用成本、查询漂移及提前停止漏检率。