Self-Adaptive VLA:从失败轨迹推断硬件偏差
补偿常量偏移需要多次尝试,80%恢复比例不是单次成功率
机器人关节偏差会让原本可靠的策略突然失效。这项工作用有意注入的硬件偏移收集失败上下文,并把原专家示范预补偿为正确目标;部署时把过去试验压缩成上下文token,调整下一次动作,而不现场更新模型梯度。
图解主要方法
图2如何利用失败做诊断,却仍从专家目标学习动作?
- 1
注入已知偏移并生成正确训练目标
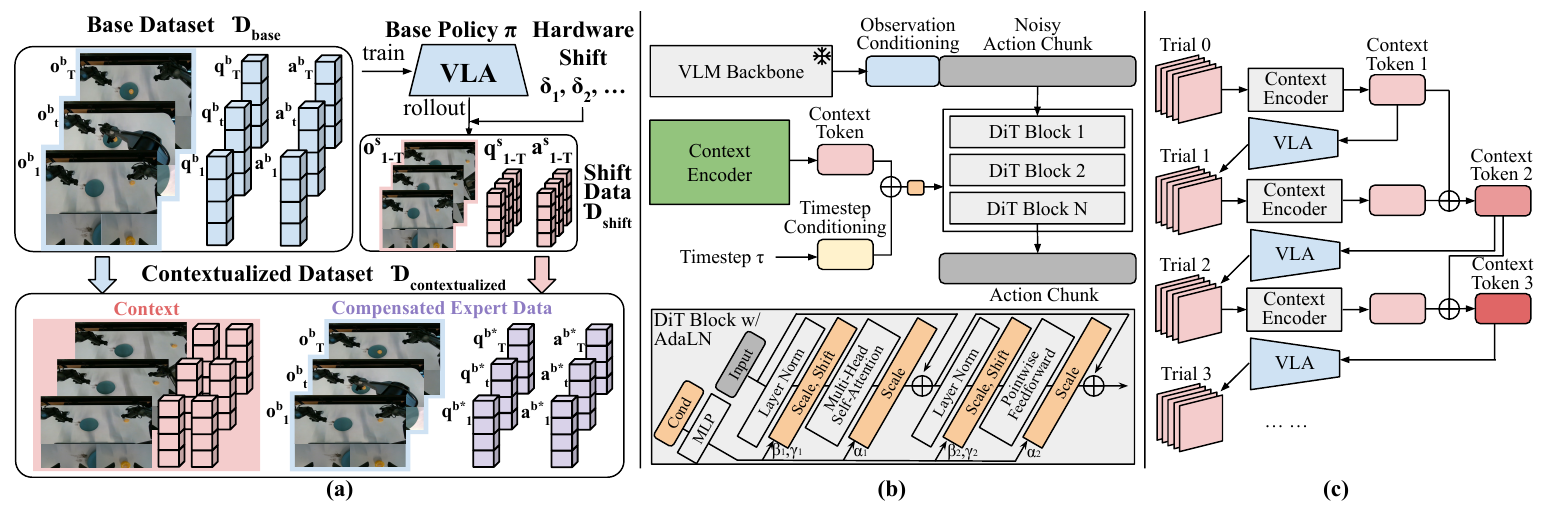
图2a分别模拟执行偏差和关节编码器偏移。前者执行a+δ;后者还让读出的关节状态产生偏移,不能只靠本体感觉识别。失败rollout只提供诊断上下文,监督动作来自原专家示范的a−δ补偿,避免把错误行为学成目标。
- 2
把多模态历史压成上下文token
图2b用约15秒轨迹,融合三路RGB、30Hz本体状态与动作。视觉下采样经DINOv3、时间编码和注意力压为单个token,再加到DiT时间条件进入AdaLN;基础VLM冻结,适应训练仍有离线成本。
- 3
跨试验累积剩余偏差线索
图2c在一次试验后计算token,下次试验中固定使用;多次token直接相加,尝试逐步补偿先前未暴露的偏移。这是跨试验适应,不是同一次接触过程不断更新记忆或在线梯度学习。
- 4
把重置与失败预算纳入部署
评测每个episode容许最多六次尝试,每次重置场景,任一次成功即计episode成功。新工位实验也允许额外尝试,因此需要把重置人力、损坏风险和第一次失败一起考虑,不能把无闭环额外编码成本写成零适应成本。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【四任务条件】每任务20个episode,未知常量硬件偏移、最多六次尝试。原策略正常88.8%;偏移后7.5%/5.0%,上下文集成恢复到72.5%/75.0%。 主表与评价协议 ↗
我的解读我的解读:“恢复80%/84%”是相对正常策略性能的比例,且是多尝试episode口径,不是单次成功率。
来源证据【累积上下文】单上下文为45.0%/46.3%,多试验集成更高;新工位两任务基线70%/10%改善到90%/50%。 消融与工位迁移实验 ↗
我的解读我的解读:上下文累积有用,但工位和偏移类型有限,不能外推任意磨损、松动或实时变化。
来源证据【机制诊断】上下文PCA与已知偏移呈结构关系,视觉和本体模态各有贡献。 上下文分析与附录 ↗
我的解读我的解读:可视化支持编码偏差,却不是语义解耦或准确标定的因果证明;测试未覆盖所有相机和动力学变化。
开放情况与使用许可
作者项目页、全文和可用附录已核实;项目页未提供可核实的专属训练代码或权重下载。
LICENSE实现与权重许可未确认;论文原图许可见图注。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把失败轨迹作为硬件诊断、专家轨迹作为补偿目标,提出了无需每次人工重标定的具体适应路径。
反方 · 哪些结论还不够
主要针对常量偏差,需多次失败和场景重置;动态故障、损坏容忍和长期恢复可靠性仍未证明。
综合判断
适合可安全重试的精密操作研究;应用时必须分别报告首次成功与含重试成功,并设置失败停止条件。
我会先做的验证
未执行的验证方案:在未见工位随机注入常量与时变偏移,固定总尝试预算,比较人工重标定、单上下文与累积上下文;报告首试成功、达到成功所需次数、恢复耗时及失败接触力。