SERA:改进机器人的执行规则,而非每次重训策略
开发阶段的规则演化,如何与测试时固定执行边界分开?
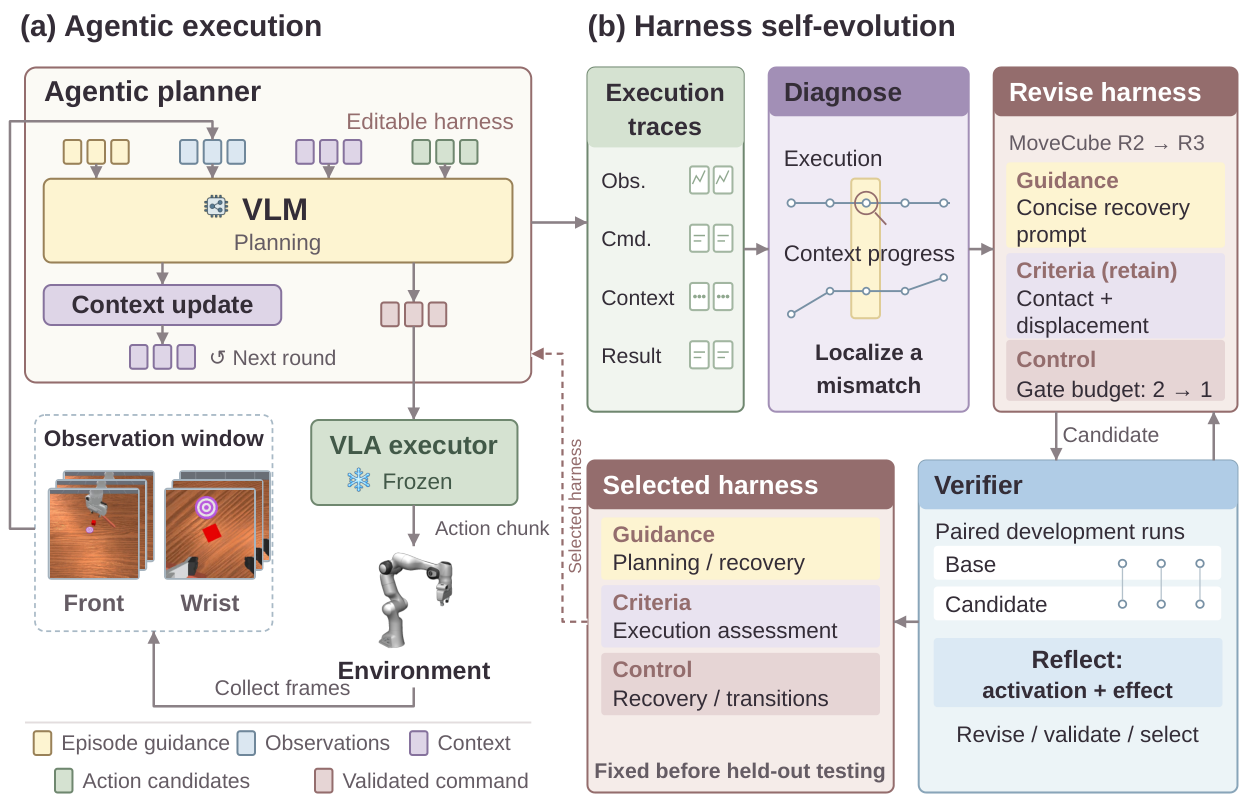
SERA在冻结VLA执行器外放置VLM规划器、任务上下文和可编辑规则,通过开发回放定位首个失败并修订规则。论文测试的是开发完成后固定的harness,不是机器人在测试中无限在线自我改写。
图解主要方法
开发阶段的规则演化,如何与测试时固定执行边界分开?
- 1
把历史变成有界上下文
图2左侧VLM读取观察窗口、前一步命令和最多1600字符上下文,并结合候选动作目录作决策。目录top5来自转移与频率的融合排序,并非语义检索器;上下文记录任务进展而非保存无限视频。
- 2
诊断执行失败后修改规则
右侧开发流程把观察、命令与结果对齐,找第一处计划和真实执行不符,修订规划提示、成功判据及已注册控制规则。开发可参考专家或内部轨迹,但部署触发条件必须来自运行时可观察量。
- 3
验证候选后冻结测试版本
候选在成对开发回合比较后选入最终规则。格式校验只保证命令可解析,VLM对动作成功的判断也不是独立物理验证器;最终版本在留出测试前固定,避免把测试反馈反复用于修改。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据平均44.38%升至51.38%,即800回合中411成功。官方MemER42.38%与本地复现45.375%存在差异。 RoboMME:16任务、每任务50回合 ↗
我的解读应以同协议本地结果判断增益,不混用官方和重跑数字制造更大提升。
来源证据预算不足时,部分候选允许以一次额外获胜且未回退的结果保留,并非全部经过新鲜独立验证。 附录:验证预算与保留规则 ↗
我的解读规则选择证据有强弱差别;不能把所有变化都称作稳定、独立验证的改进。
来源证据Reference为69.5%,Imitation为30%;ButtonUnmaskSwap仍0/50。高层使用gpt-5.6-sol high。 任务分布与成本 ↗
我的解读平均提升掩盖失败任务;规划延迟与真实机器人量化收益没有充分给出。
开放情况与使用许可
本期核对论文正文和附录,未获得可核实的官方实现或权重入口;arXiv非独占托管许可不等同开源许可。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
将执行问题定位到规划、记忆或成功判据,提供了冻结策略上可审计的改进位置。
反方 · 哪些结论还不够
规则可能适配开发任务;验证预算不足、VLM自评及未报告延迟限制部署结论。
综合判断
支持离线规则迭代的价值,不支持无监督持续自我进化的宣传。
我会先做的验证
未执行的验证方案:预注册规则选择预算,使用独立场景和固定种子集验证;记录每次规则变化、失败恢复、规划时延与真实接管。