Self-Play Pretraining:程序自博弈能学到多少通用结构
零自然数据梯度的概念验证;不等于没有先验或不需要世界知识
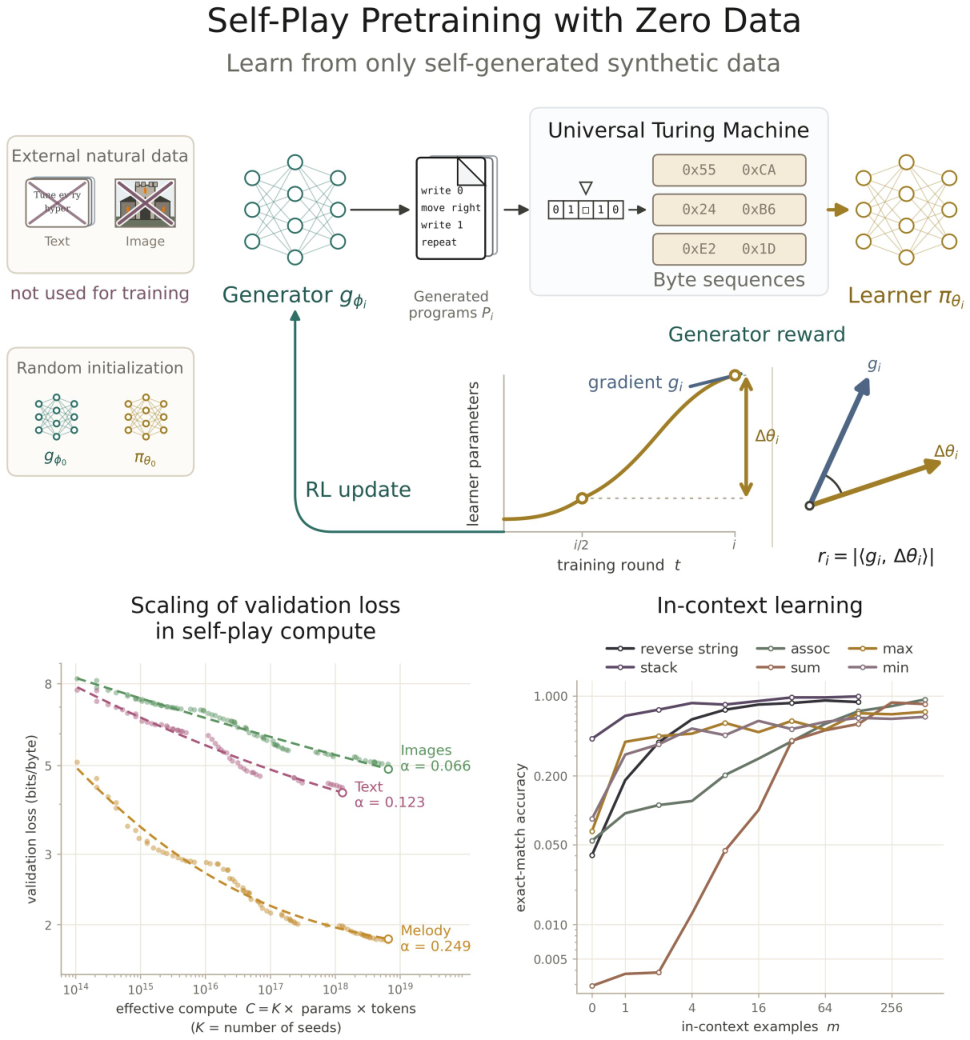
两个随机初始化的字节模型互相塑造训练课程:生成器写程序,解释器产出字节,学习器预测字节,学习反馈再更新生成器。作者观察到自然数据预测损失下降和上下文规则学习,但规模仍小于 25M,且自然验证集参与了调参。
图解主要方法
图 1 的奖励怎样让程序比随机字节更值得学习,又有哪些自然数据依赖?
- 1
把程序执行作为数据源
图上方的生成器和学习器都从随机权重开始,词表为 256 字节、上下文 4096。生成器输出 Brainfuck 风格程序,由解释器在随机输入带上执行,形成学习器的下一字节训练数据。实际解释器有内存和运行时边界、宏指令与循环规则,因此不是完全没有人为归纳偏置。
- 2
用训练方向构造奖励
图中央比较当前样本损失梯度与学习器此前一段参数位移,并加入 AdamW 预条件,取内积绝对值作为奖励。它鼓励与学习动态有关的结构,不是直接奖励样本难度,也不能等同于保证正向学习进展;绝对值会丢失方向符号。
- 3
让强化学习、变异与重放维持课程
生成器通过带 KL 约束的策略更新和奖励加权学习改进程序,程序库按结构维持多样性;变异与重放提供其他候选。变异样本没有已知提议概率,不能照搬普通策略梯度修正。学习器始终用交叉熵学习执行输出,而非自然语料。
- 4
把迁移检验与世界事实分开
图下方分别画自然序列的 bits/byte 和不更新权重的上下文任务。能预测统计结构,不意味着认识图像、理解语音或证明定理。DCLM 与 DNA 验证损失仍被用来选择超参数;关于具体世界的事实也无法仅靠通用程序搜索恢复。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【尺度与基线】小于 25M 参数、4K 上下文;计算前沿在模型规模、检查点和集成数量间选择。自博弈优于固定程序先验,PCFG 在文本与代码上仍更强。 正文结果、计算前沿与数据附录 ↗
我的解读我的解读:支持自适应课程有价值;跨论文幂律指数不是相同预算下击败自然预训练的证据。
来源证据【消融并非处处一致】1M 模型四种子集成的一组 DCLM 结果中,默认绝对奖励 BPB 5.34,带符号奖励为 5.06。 奖励消融表 5 ↗
我的解读我的解读:不能把机制概括成“取绝对值一定更好”;奖励、模态和模型尺度可能相互影响。
来源证据【预热成本】24.4M 配置四种子实验中,达到某些自然数据损失所需的自然训练 token 更少,但未计入先前自博弈计算。 自然数据 warm-start 实验及附录 ↗
我的解读我的解读:说明初始化可能有帮助,还不足以证明总算力节省。分类、语音识别或代码执行能力也未由 BPB 自动得到验证。
开放情况与使用许可
已核实作者 Hugging Face 存在 learner 检查点与配置;配套 self_play_pretraining 仓库已有评分、评估与分析实现;生成器权重、优化器状态和训练代码不在该发布范围内。
LICENSE模型卡标注 Apache-2.0,配套评估仓库未核实独立 LICENSE;论文原图为 arXiv 非独占分发许可,仅引用必要图解,不把权重许可扩展到图片。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把数据课程本身变成可学习对象,并用固定程序先验作对照,为研究通用序列结构提供了明确实验路径。
反方 · 哪些结论还不够
自然验证集调参、解释器设计、后验计算前沿和小模型范围都限制“零数据”的含义;自然事实知识仍然缺席。
综合判断
适合研究预训练前的结构学习与合成课程,尚不能替代自然语料预训练或视为成熟的大模型训练配方。
我会先做的验证
未执行的验证方案:冻结解释器和调参集,在未参与选择的模态上比较随机程序、PCFG、自博弈和等总 FLOPs 自然预训练;计入生成、解释、奖励与学习全部成本,并同时测 BPB、规则任务和实际下游质量。