把三个科研想法一起奖励,能否避免重复出题?
集合内多样性明显改善,但自动影响力分数不等于科学发现。
论文把科研创意生成从单条回答改成三个结构化想法组成的集合,用质量乘以与前面想法的距离训练 Qwen3-8B。最强版本提高自动创意效用,却降低对输入文献的依赖;小规模人工与执行检查只支持其作为候选方向生成器。
图解主要方法
集合内多样性明显改善,但自动影响力分数不等于科学发现。
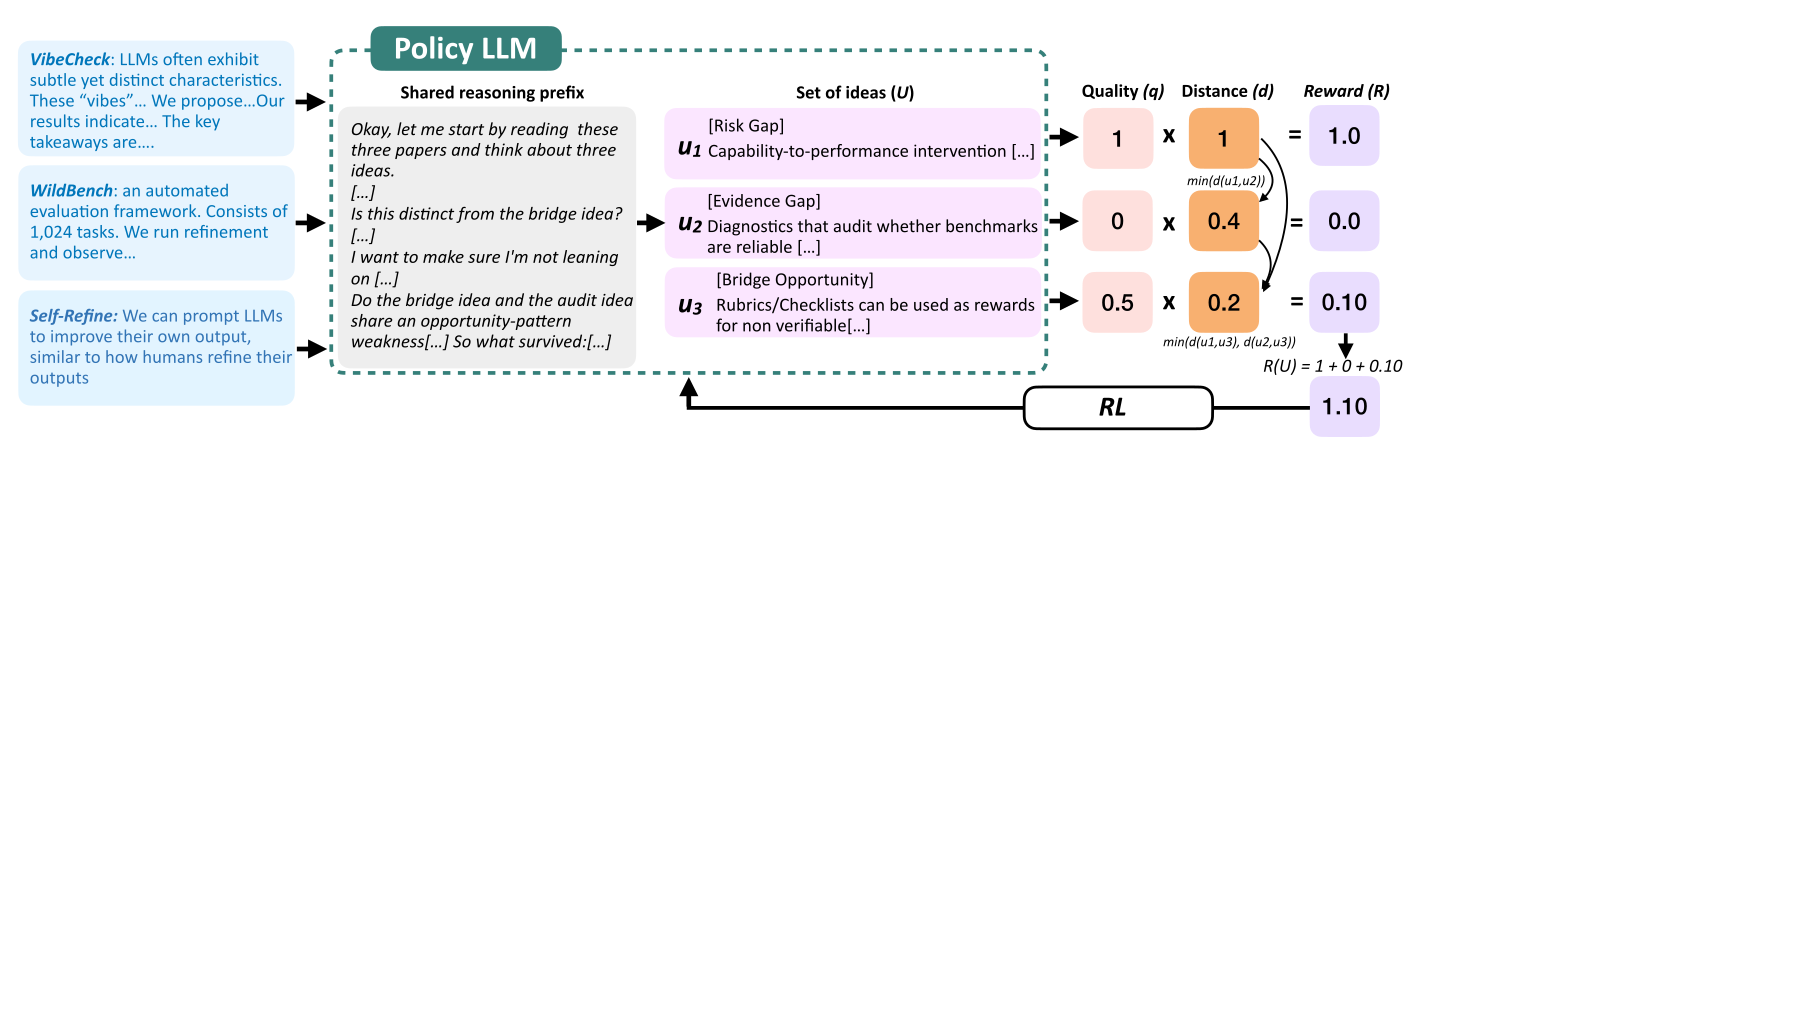
- 1
先让来源成为结构化输入
从目标论文引用中筛出动机、缺口、基础或直接扩展的文献,输入其摘要卡片;目标论文的核心想法只用于奖励比较,不给策略看。7172 条教师样本进行 SFT,思考版本使用事后构造的探索轨迹,不能视作教师真实内部推理。
- 2
按集合内边际贡献计分
图1中每个想法包含问题、主张、方法和来源说明。质量由其与目标想法的两次换序比较产生;距离是前三个字段的语义差异。第一条距离设为1,后续取离既有想法的最小距离,再把质量乘距离求和,所以仅换措辞不能稳定增加奖励。
- 3
把格式、长度与评测分开
GRPO 每提示4个完整集合,600步;格式不合格得零,合格有0.05奖励,并对被评分字段施加长度惩罚。训练按生成顺序、无折扣;评测 CU 使用贪心重排和0.9耐心折扣。训练和评测裁判不同,但仍属于模型判断。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据无思考 CU 0.64,对照 Claude 0.38;来源依赖评分0.61对0.98,思考版 CU 0.51、依赖0.81。 表1、11:1740个测试实例 ↗
我的解读这是效用与来源依赖之间的取舍;附录的来源裁判只看声明的 inspiration,并未逐句核查源论文。
来源证据4名专家、60实例,有前景想法2.17对2.20;132个执行想法、每个90分钟30美元CPU预算,success@3约33%对27%。 表4–5与附录F:小规模验证 ↗
我的解读执行者自己给 supports/refutes,部分结论强于证据;无独立复现,不能据小样本宣布超越。
来源证据DARLING无任务SFT、K=1和8个rollout,与主方法不只差奖励位置;方法类别熵0.65低于Claude0.77、人类0.87。 附录B与表17:对照与分布 ↗
我的解读集合内多样并不保证整个人群的研究方向多样;2026目标论文也不足以证明所有闭源模型无训练污染。
开放情况与使用许可
2026-10-23核对官方仓库:仅README,明确 code/data/models coming soon;无实际实现或模型文件,不能标为已开源。
LICENSE论文 CC BY-NC-SA 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把冗余的高分想法折价,是研究助手生成备选方向时可检验的训练目标。
反方 · 哪些结论还不够
质量是预测影响力而非实测科学贡献;来源依赖下降,训练只覆盖英文NLP,人工与执行样本很小。
综合判断
值得研究集合奖励,不应以 CU 排名替代科学正确性、来源核查或真实研究产出。
我会先做的验证
未执行的验证方案:固定文献与总token预算,盲评不同模型各三个方向;独立团队预注册并复现实验,额外报告错误引用、集合内与跨题目重复率。