TWIG:把模型权重写成共享离散决策树
同一套树表示能否同时说明存储压缩、定制电路成本和离散优化?
TWIG把每个权重表示为一条共享决策路径:符号、二次幂缩放、零门与查表选择由子树共同继承。论文给出统一表示和早期实验,其中BF16无损压缩可减少带宽,但加法器估算、量化精度和GPU吞吐属于不同证据,不能合并为普遍硬件加速。
图解主要方法
同一套树表示能否同时说明存储压缩、定制电路成本和离散优化?
- 1
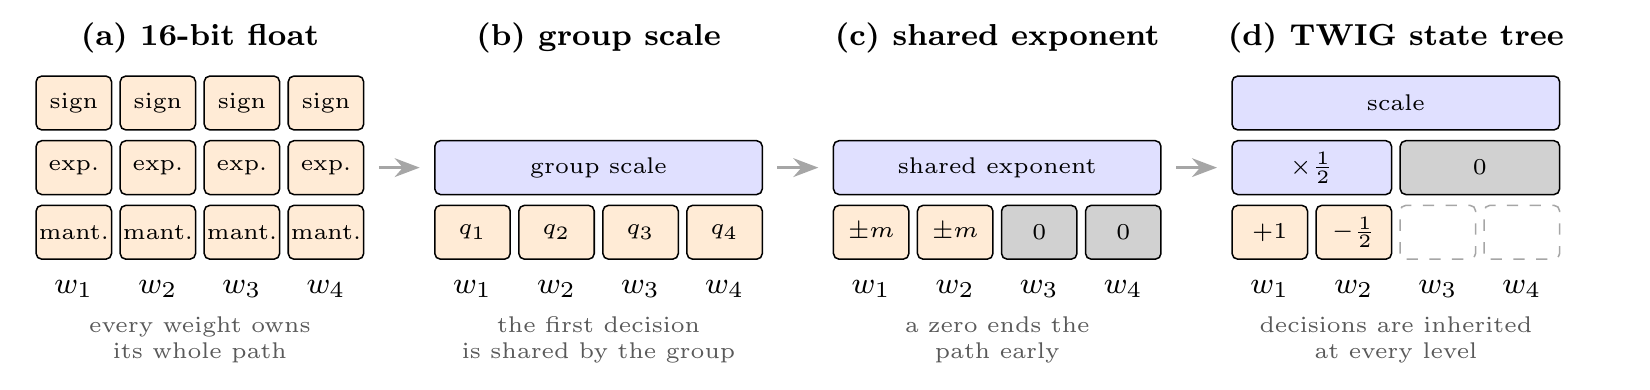
1 · 读图1:共享的是路径前缀
普通浮点每个权重单独存符号、指数和尾数;分组量化共享一个scale,块浮点共享指数,TWIG允许多个层级共享选择。叶节点沿根到叶路径相乘得到权重,零门可直接剪掉子树;低秩分解还涉及树的组合,不能把所有网络都理解为一个浅树。
- 2
2 · 无损格式先压共享指数
论文的BF16方案对64个值保存8位组指数,每值4位指数偏移及8位符号/尾数,罕见偏移走escape。名义12.125 bit/value,含escape约12.133;还原原始BF16位与有损的3.25位量化实验是两回事。
- 3
3 · 统一搜索仍要选代价函数
剪枝、量化和低秩选项进入菜单,用校准曲率估计损失,再在给定大小预算下做Pareto动态规划和重估。共享决策减少储存位数,并不自动减少执行加法;固定权重电路用移位连线和加法器估算,GPU则需专门解码内核。
- 4
4 · 离散优化不是量子优势证明
树上离散选择可转成高阶Boltzmann或QUBO形式,论文展示的是选定模型和层的经典优化实验。Qwen2.5-1.5B修复中的连续scale优化仍优于所示Ising式修复,因此统一数学表示不等于已有最优求解器。
实验与证据
已阅读正文与方法、实验相关附录,核对实验条件与原图;未独立复现。
来源证据小batch 1–8的格式贡献约1.03–1.27倍;与CuBLAS的总差异还包含内核实现因素;batch≥32可能慢至约15%。 BF16存储与A100实验 ↗
我的解读带宽受限时才有优势,不能把端到端或自定义内核收益全部归给格式。
来源证据五个选定矩阵、3/4位精度、相同层误差下,典型矩阵加法数少9–15%,强离群值矩阵少20–55%。 固定电路实验 ↗
我的解读这是加法器代理指标,未测整芯片面积、功耗,激活和注意力乘法也仍存在。
来源证据Qwen2.5-1.5B在2.44bpw下GSM从13.95到21.83;贪心修复20.3,连续scale优化27.5。 离散修复实验 ↗
我的解读方向有价值,但不支持离散求解已超过所有连续方案。
开放情况与使用许可
实际打开StateTree-Representation仓库,含statetree实现、tests与examples,LICENSE为Apache-2.0;README明确目前不支持MoE。仓库扩展数据与论文结果分别归因,未在本机运行CUDA复现。
LICENSECC BY 4.0(论文及原图)
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
将格式、共享与运算成本放入同一表示,有助于比较压缩方法;无损路径还能避免把速度收益建立在精度损失上。
反方 · 哪些结论还不够
量化菜单等部分细节仍依赖后续工作;小规模矩阵实验不是整模型硬件验收。官网仓库现有实现侧重无损BF16权重和KV缓存,不等于论文所有理论分支均已复现。
综合判断
优先评估可运行的无损实现,把定制芯片和量子优化视为尚需验证的延伸。
我会先做的验证
未执行的验证方案:在同一GPU、内核基线和模型上测batch1/8/32、短长上下文的峰值显存及完整响应延迟,逐位核对解码BF16,并单列权重压缩、KV压缩和内核优化贡献。