SJC:压缩智能体记忆时,先问这条信息来自哪里
来源裁判能否阻止智能体将自己的推测写成长期记忆?
Source-Judged Compaction在既有摘要器后增加条目级来源检查:有环境输出或旧摘要支撑则原样保留,否则整条删除。它验证的是来源,不是事实真伪;旧摘要中的错误仍可能被继承。
图解主要方法
来源裁判能否阻止智能体将自己的推测写成长期记忆?
- 1
生成候选摘要,固定用户任务
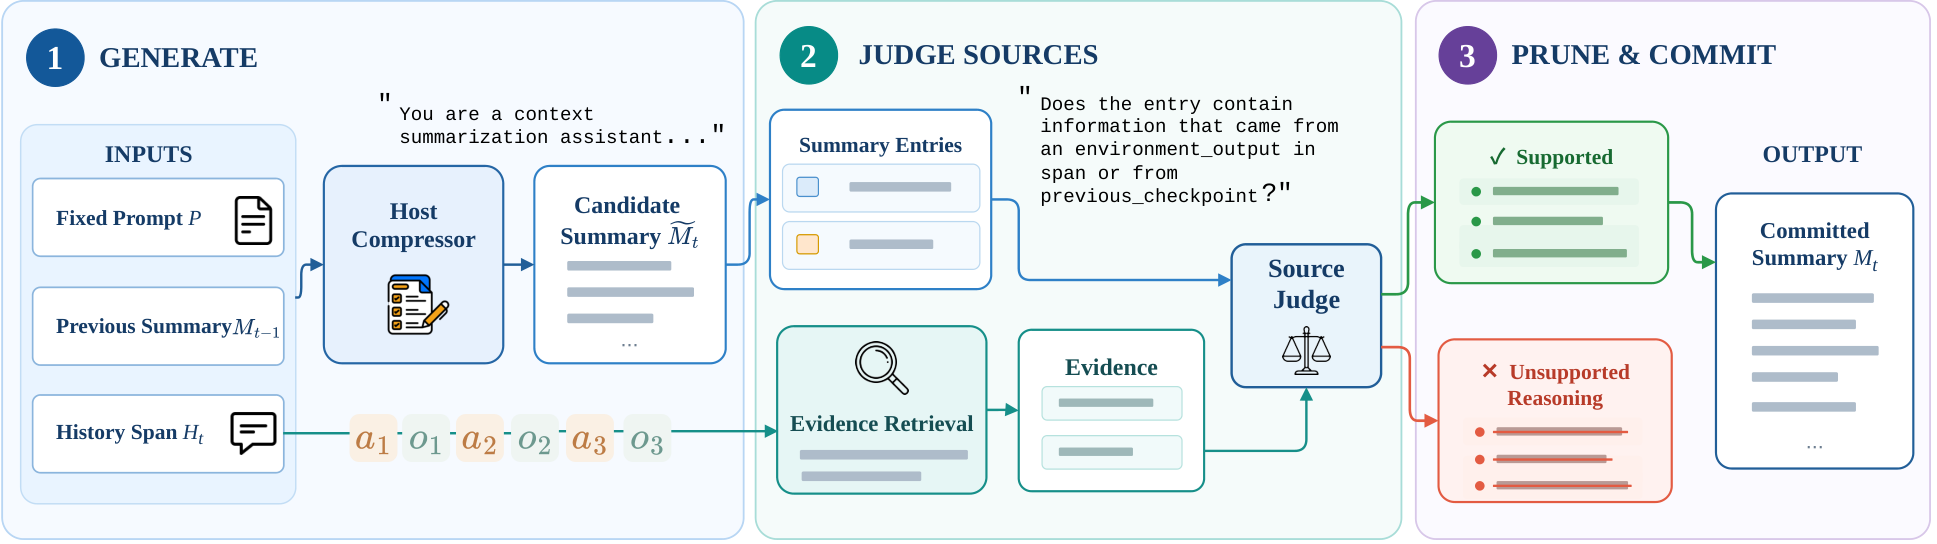
图1左侧保留固定用户提示P,将历史交互和上一版摘要交给宿主压缩器。用户任务原文单独保留,不把用户提示或智能体自身分析默认当作环境证据;多轮用户新消息如何纳入证据不在主要评测内。
- 2
逐条检索来源片段
按摘要结构拆条目,BM25检索最相关的3个约300字符片段,再扩展证据上下文至约2000字符。来源池主要是工具/环境输出和上次摘要;检索缺失本身会让正确条目失去支撑。
- 3
裁判打分,保留或整条删除
Jev 1.13判断条目是否含有来自证据的信息,以yes概率0.5为阈值。保留条目不重写;裁判响应不可用时回退为保留。通常批量一次判定,4709次请求中10次因32k长度拆批,不能宣称始终一次调用。
- 4
将删减摘要交回原智能体
主智能体与摘要器无需训练;下一轮继续用压缩后的状态。此结构减少未经支持的推理持续传播,但对旧摘要错误及有来源的错误陈述没有纠正保证。
实验与证据
已阅读正文与附录A–G,核对实验条件与原图;未独立复现。
来源证据168个AppWorld测试任务、95个OfficeBench任务,两种智能体模型各3次运行;强制摘要预算分别4096与2048,最多50步。Pass3表示三次都成功,而不是三次任一次成功的pass@3。 正文实验与附录:AppWorld、OfficeBench ↗
我的解读这是短上下文预算下的可靠性测试;不能将Pass3误读为采样择优指标或推广为任意长上下文总胜率。
来源证据两模型AppWorld Pass3分别提高8.9和7.1个百分点,OfficeBench提高5.3和2.1个百分点;但OfficeBench的MiniMax平均任务成功率由84.2降至83.2。摘要token减少约14%–27%。 结果表:可靠性与负向结果 ↗
我的解读可靠性部分指标改善,不代表每模型每数据集平均成功率都提升。裁判成本另计,不能将主智能体token减少写成总成本必降。
来源证据来源判别AUROC为0.905,但来源得分预测正确性的AUROC为0.444;阈值0.5时支持条目精确率96.9%、召回率64.2%。 来源判别和正确性分析 ↗
我的解读来源与真实性是两个变量;高精确率过滤会删去部分有用内容,真实环境证据也可能过时或错误。
开放情况与使用许可
官方GuanghuiMin/sjc仓库可访问,含sjc/gate.py、evidence.py、评测脚本;仓库API未给许可证且根目录未发现LICENSE,不能据公开代码认定已授予开源再利用许可。论文为arXiv非独占托管。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把“工具观测”和“智能体自行推断”分开,是可插入现有代理框架的记忆卫生措施;消融与来源正确性分离比单报成功率更有解释力。
反方 · 哪些结论还不够
基于两套工具环境和有限模型,裁判与检索均可能误判;旧摘要被当作来源会固化早期错误,混合事实和推测的整条删除也可能损失事实。
综合判断
可作为来源过滤层试验,不应宣传为事实核验器或永久正确记忆。应同时展示删除率、误删有用证据和平均成功率的反例。
我会先做的验证
未执行的验证方案:在多轮真实任务中对比原摘要、随机同预算删除与来源过滤;人工盲审正确但被删的条目,注入旧摘要错误并统计传播率,单列裁判成本、延迟和任务成功。