SPAR:学会在局部信息足够时忽略远端干扰
选择性一致性训练,而非一律压低长上下文影响
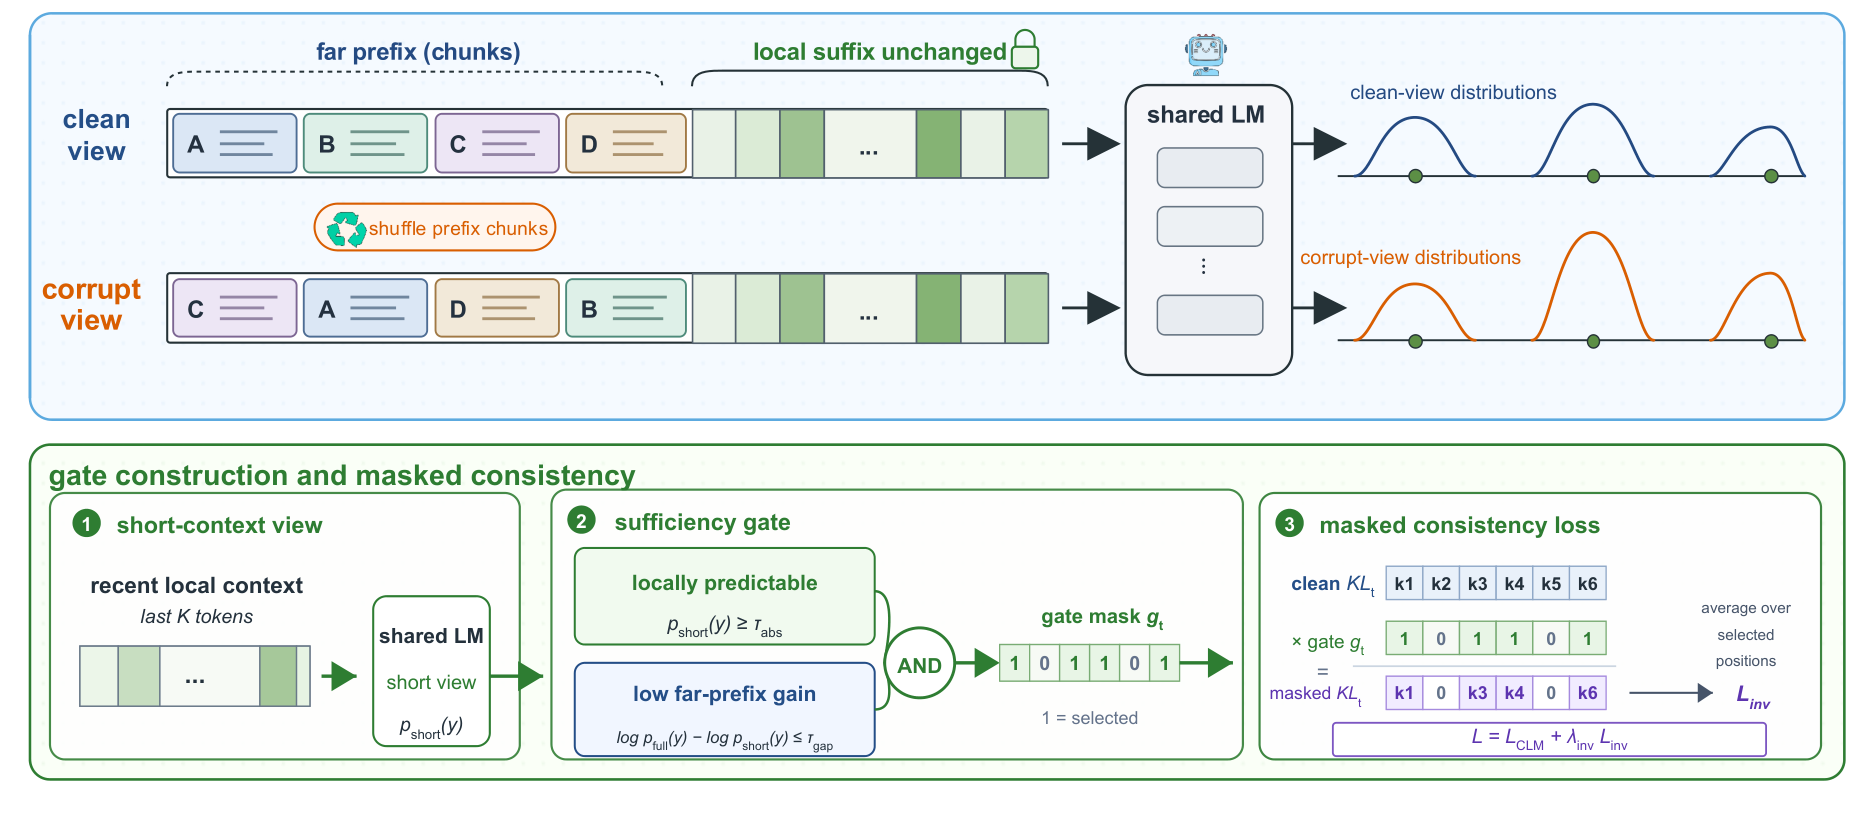
远端上下文有时提供答案,有时只是噪声。SPAR 保持近端后缀不变、打乱远端前缀,只在局部足以预测且完整上下文收益很小的位置约束预测一致性;推理时仍是普通语言模型,不额外判断或删除上下文。
图解主要方法
图 1 中的门控怎样避免把有用的远端证据也抹掉?
- 1
构造只破坏远端的配对输入
图上半部的 clean/corrupt view 使用同一模型:按块打乱较远前缀,保留最近的局部后缀及监督目标。训练要比较同一位置在两种远端信息下的输出;这模拟特定乱序干扰,不覆盖所有恶意或事实矛盾输入。
- 2
用两个条件筛出局部充分的位置
图左下 short-context view 只看最近 K 个 token。门控要求正确目标词的局部概率高于绝对阈值,同时完整上下文相对短上下文的对数似然增益不超过另一阈值;一个条件保证局部能答,另一个避免误伤必须依赖远端的词。
- 3
只在通过门控的位置匹配分布
图右下将干净预测停止梯度后作为软目标,对受扰预测加 KL 一致性损失;实验使用 top-32 候选和温度 0.7。普通因果语言建模损失仍在全部位置生效,受扰视图不另加目标词交叉熵。门控利用训练标签,部署时不运行。
- 4
把门控机制与最终能力分开检查
作者用固定的普通交叉熵参考模型选定评估掩码,再测抗干扰性,避免 SPAR 通过改变自选样本而看似更稳。机制探针另标哪些位置确有远端依赖;实际长上下文收益仍由 RULER、HELMET 测量。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【五种模型、三随机种子】Qwen 0.5B 的 RULER 宏平均从 57.83 到 59.98,3B 从 79.13 到 79.46;Qwen/Llama 训练窗口 16K,GPT-2 为 32K,Qwen 另测 24K/32K 外推。 主结果表与上下文配置 ↗
我的解读我的解读:小模型受益更明显,不能把一个配置的增幅推广到所有规模或无限长上下文。
来源证据【门控消融】0.5B 选择性训练增益 2.15 个百分点,随机选择 0.98,无门控 0.48;256 个依赖探针上精确率 0.988、召回率 0.613。 门控消融与机制探针 ↗
我的解读我的解读:支持选择规则的作用,但高精确率以漏掉部分合适位置为代价;小探针集不是开放场景保证。
来源证据【固定评估掩码】干净输入 NLL 增加 0.0186,受扰输入降低 0.0634。 固定掩码诊断 ↗
我的解读我的解读:抗干扰并非无代价;论文的计算预算对齐还不足以从公开训练细节独立核算全部 FLOPs。
开放情况与使用许可
全文公开;未从论文核实到本研究的可用代码或权重。arXiv 引用元数据与 Submission history 均写首发 2026-08-22,但编号为 2609.27925;保留该日期异常说明,按回顾补收,不称今日新作。
LICENSE实现与权重许可未确认;论文 CC BY 4.0。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
用局部充分性限制正则化范围,给出了“哪些词应忽略远端”的可检查训练规则。
反方 · 哪些结论还不够
干净预测存在小幅退步,块乱序也不能代表所有真实干扰;训练数据与完整计算预算仍需补充。
综合判断
可作为长上下文预训练的局部正则化候选,适用性应同时看远端检索保留率和噪声鲁棒性。
我会先做的验证
未执行的验证方案:在同一训练语料、总 FLOPs 和种子下比较普通训练、随机门控及 SPAR,分别加入乱序、矛盾事实和真正必要的远端证据;报告干净损失、检索准确率与门控误伤率。