SpatialHarness:用同步虚拟视角补足精细操作的空间证据
冻结动作模型,代价转向CAD、位姿同步与交互回放
SpatialHarness保留原有摄像头和冻结的多模态动作模型,维护与真实机器人同步的仿真场景,从虚拟角度显示孔、插头和把手之间的关系。关键不是生成更漂亮的视图,而是按静止、持握和抓放转换分别纠正场景;若几何状态错误,额外视角也会误导决策。
图解主要方法
图2为何按交互状态采用不同纠错,而不是让仿真一直自由推演?
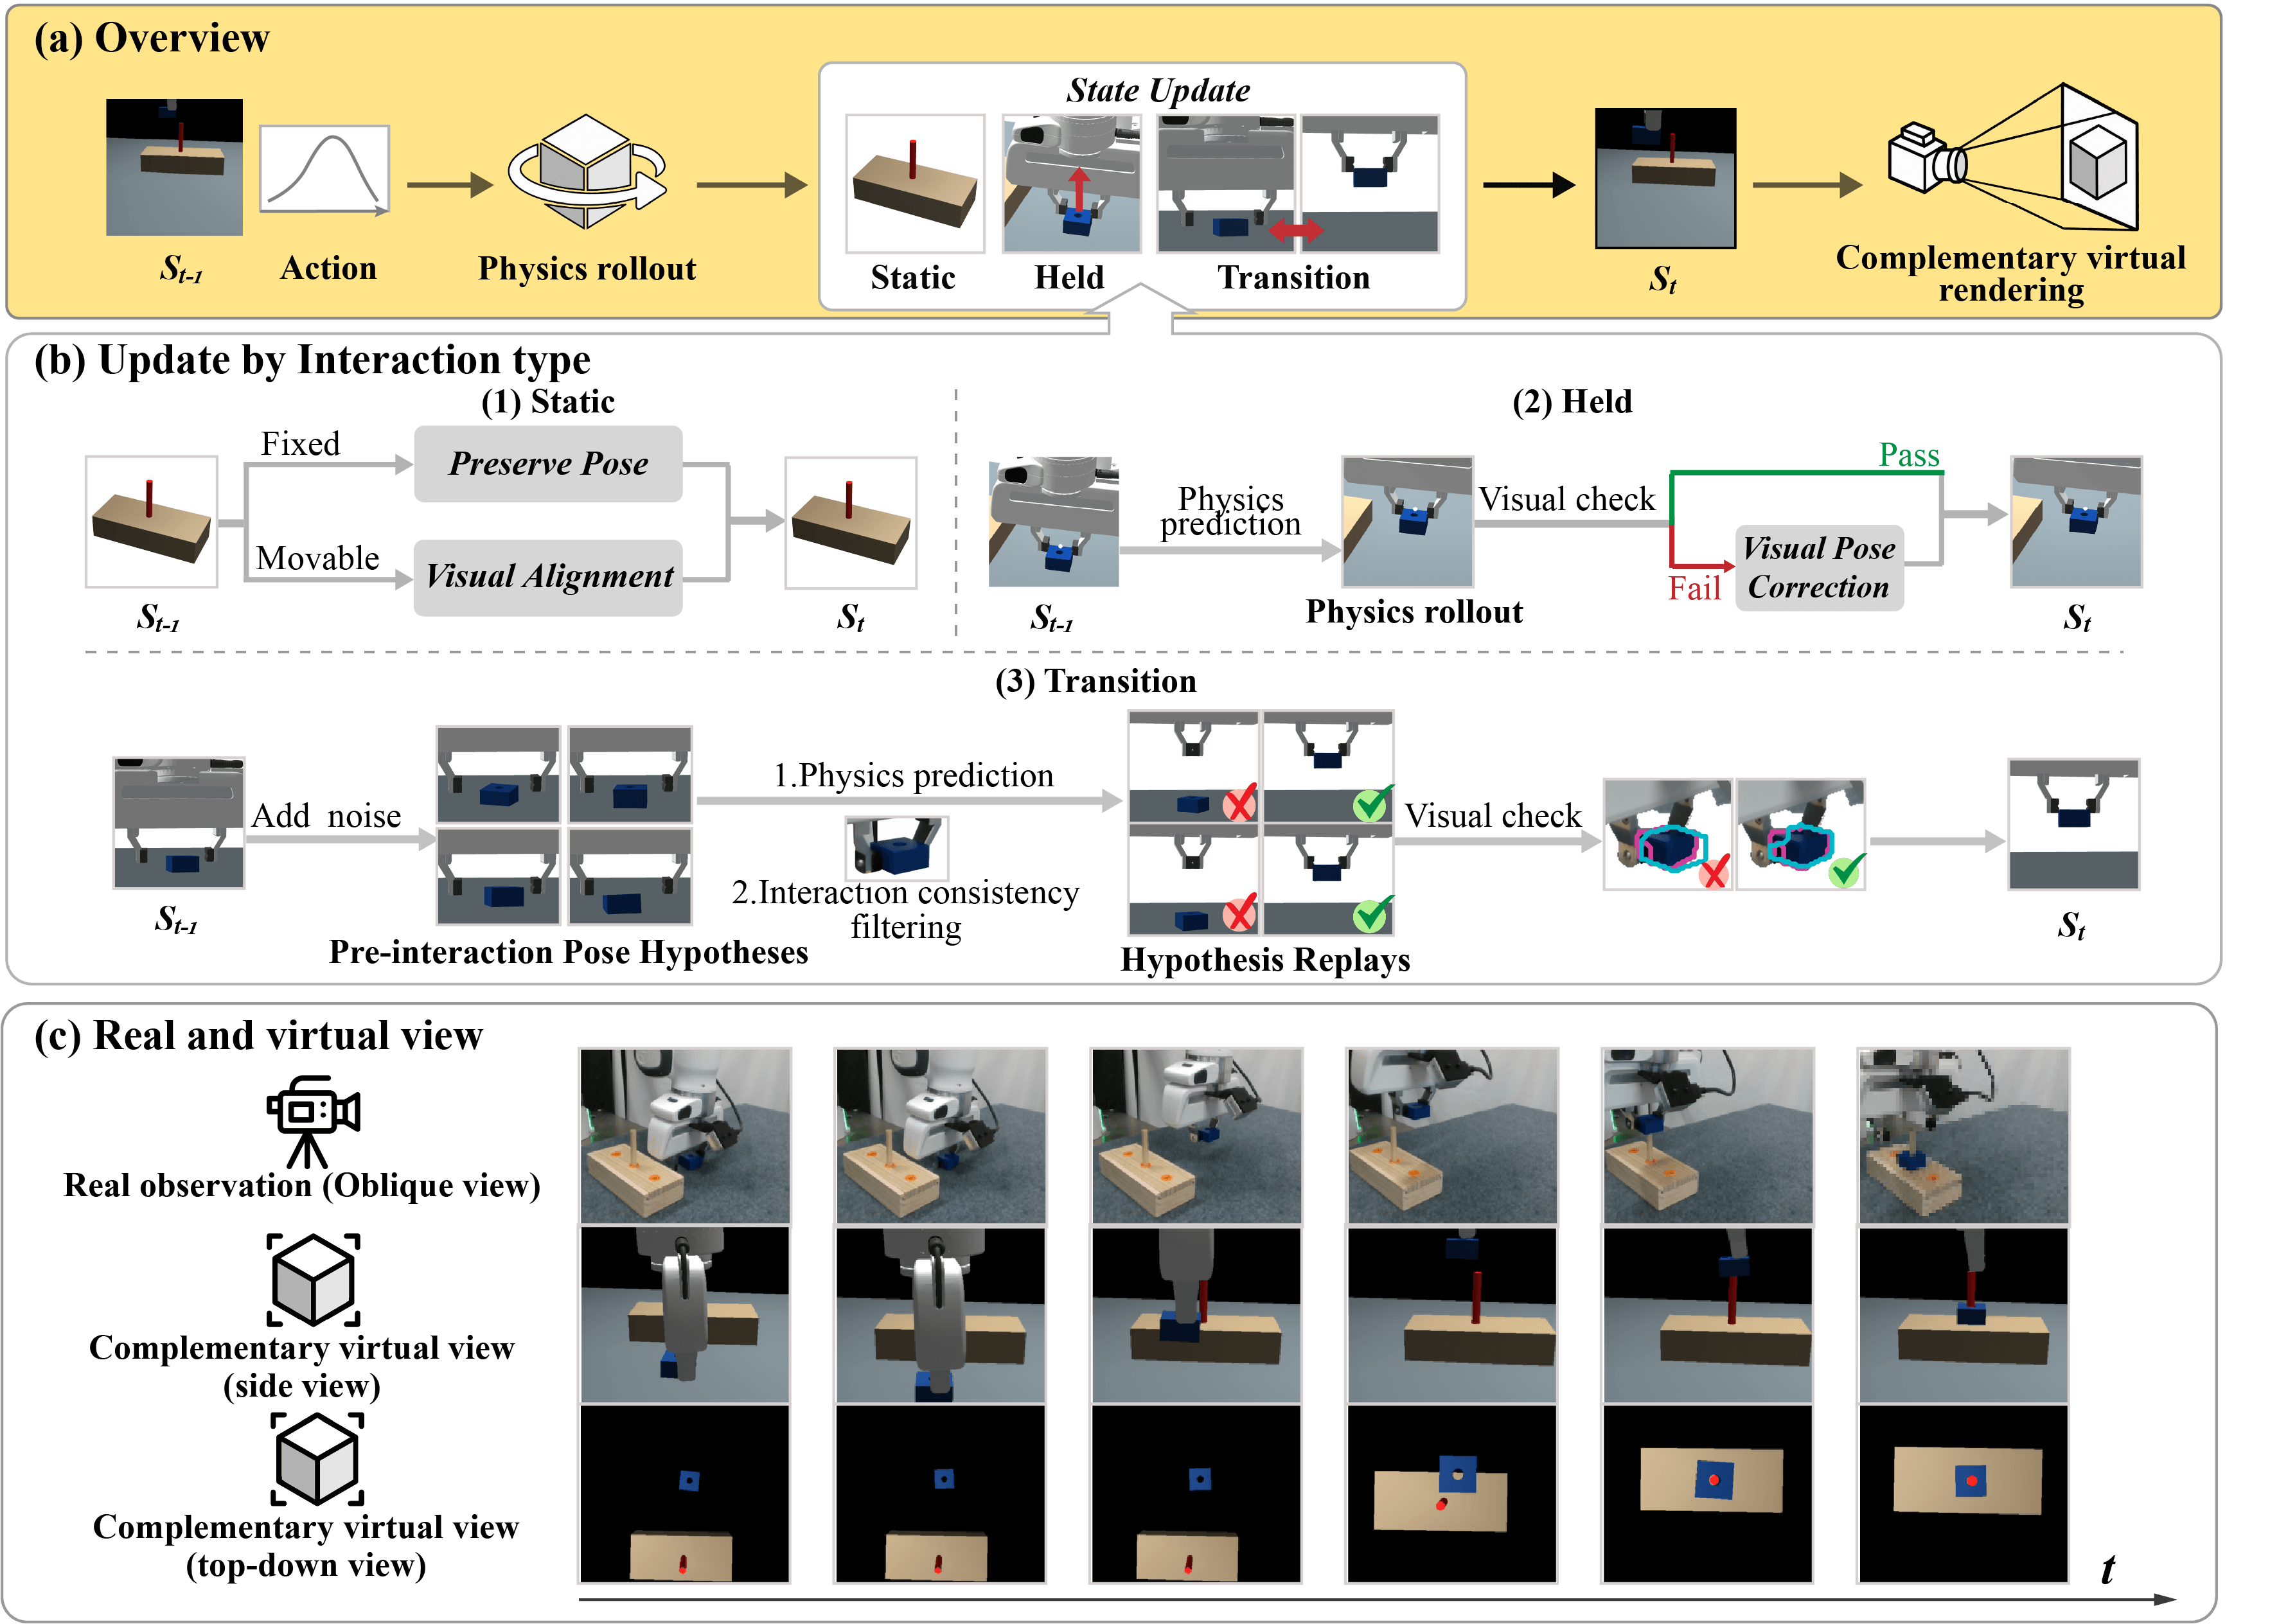
- 1
先建立可校验的场景,而不是凭空补画
初始CAD由多视角照片和基本几何尺寸标注构建。候选位姿从已标定真实相机渲染,与SAM 3轮廓和深度比较,再由模型生成空间约束程序做有限纠正或拒绝。模型没有微调不等于系统无需场景准备,尺寸标注也是额外先验。
- 2
区分静止与持握状态
图2(b)的Static分支对固定物体保留位姿,对可移动但静止物体做视觉校正。Held分支用实际测得的关节和夹爪运动推进物理仿真,再检查图像与夹爪几何;不通过时改用腕部相机估计。仿真是可被真实观测纠正的状态提议。
- 3
抓放转换时回到接触前重放
Transition分支在接触前保存完整状态,对物体位姿局部扰动构造假设,重放同一段实测机器人动作。先过滤抓住/放开结果与真实交互不符的分支,再用整段腕部轮廓匹配选最接近分支,接纳其完整动力学状态,避免只修改最终位置却留下错误速度或接触。
- 4
按任务选择视角并输入冻结策略
执行前模型根据任务要求选两个全局视角,或一个局部加一个全局视角,经渲染检查后固定相机。图2(c)的顶视与侧视揭示孔柱偏移;执行中更新场景而非持续移动虚拟相机。策略接收真实图、两张虚拟图、位姿及可靠性提示,输出位置/旋转增量和夹爪指令。
实验与证据
已阅读v1全文、实验和局限,检查图2、作者项目与仓库实际文件。作者报告真机测试;本站未独立运行机器人实验。
来源证据【设备与对照】Franka Research 3配两台RealSense RGB-D,一台腕部、一台固定;两组动作策略均为GPT-6 Astra low,视角预配置使用xhigh。每任务每组15次,4任务共120次;动作块长10/20/30。 第4.1节 ↗
我的解读我的解读:固定动作模型有助于说明系统上下文的价值,但更高推理预算用于前处理,并非所有模型计算相同。RGB-D、尺寸标注和资产准备必须计入实际部署条件。
来源证据【成功数】堆块7/15→15/15,插头4/15→10/15,孔柱放置0/15→15/15,开抽屉放块0/15→10/15;四任务均值18.33%→83.33%。 图4与任务定义 ↗
我的解读我的解读:均值上升65个百分点,不是65%的相对提升。Tower of Hanoi在这里测孔柱对齐放置,不能读成长序列完整汉诺塔规划;15/15也不是任意场景100%可靠。
来源证据【调用与延迟】作者称堆块、孔柱任务动作查询分别约少30%与21%,插头约少7%,抽屉相近;局限承认转换回放、过滤和轮廓匹配增加时间。 图6及第5节 ↗
我的解读我的解读:查询统计只覆盖动作决策,不含CAD生成、视角选择、约束程序及物理回放。需要总延迟与总费用才可判断整体效率,不能把查询减少直接宣传为更快。
开放情况与使用许可
作者网页代码链接标注Coming soon;实际GitHub根目录只有docs与README,未核实机器人控制或同步实现。结果链接指向Hugging Face,但本次工具未能打开,不声称结果文件或数据许可已验证。
LICENSE未核实算法代码、结果数据的开放许可。论文采用arXiv非独占托管许可;图2为必要评论引用,版权归作者。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
冻结同一个动作模型和固定物理相机仍有明显真机改善,说明运行时空间表示值得单独研究。
反方 · 哪些结论还不够
系统同时增加虚拟图、位姿、约束程序和计算,缺少充分分项消融;动作查询减少不等于总计算成本减少。
综合判断
有说服力的小规模工位验证,尚不能把成功提升单独归功于虚拟摄像头,也不是无需场景准备的通用控制。
我会先做的验证
未执行的验证方案:相同初始化与调用预算,分别只给位姿、只给虚拟图、加入同步与完整系统;注入CAD/相机误差,统计15次以上多物体试验的置信区间、碰撞、失败恢复及包括准备在内的总延迟。