Splat2Act:扫描部署房间,再为机器人生成抓取示范
楼宇级场景发现放置面,两阶段适配的收益取决于场景是否匹配
手机扫描提供3D高斯外观与碰撞网格,单图重建目标物体,几何规划器自动生成抓取示范。论文将适配真实部署环境作为主要目标,而不是证明机器人已能泛化到任意家庭。
图解主要方法
楼宇级场景发现放置面,两阶段适配的收益取决于场景是否匹配
- 1
把视觉外观与碰撞几何分开
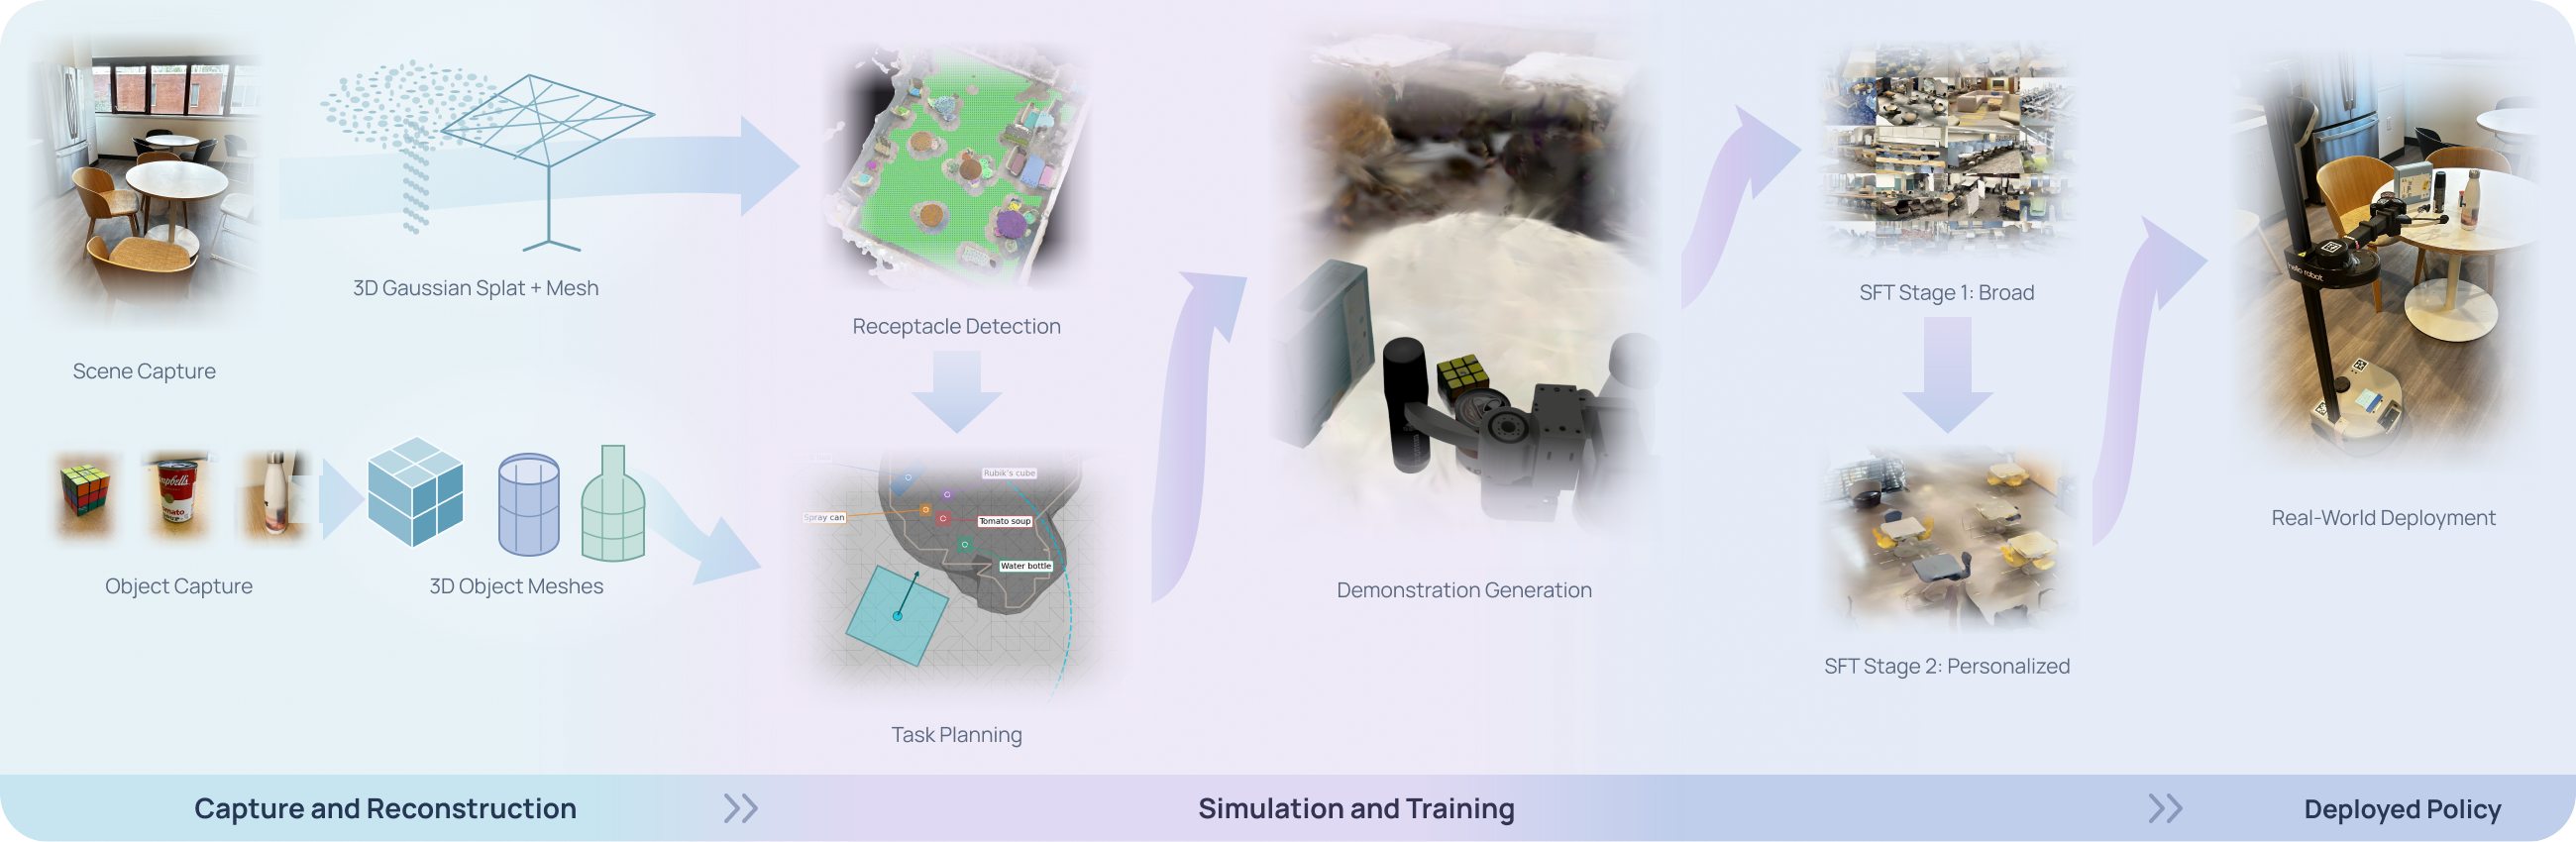
图2左侧从20–30分钟iPhone RGB-D扫描出发,用DN-Splatter正则化高斯,SuGaR提取网格。高斯负责观测渲染,网格负责碰撞与导航;用户另外提供物体照片和尺寸,SAM3D生成目标资产后按尺寸缩放。
- 2
从几何寻找可执行任务
估计地板,筛选向上且高度面积合适的面,以位置和法线HDBSCAN聚类。结合Habitat导航网格筛掉不可达放置点,站位必须能在0.70米水平臂展内覆盖至少6个放置样本,再检验沉降、抓取与执行可行性。
- 3
特权规划器生成成功轨迹
图2中段使用真实物体位姿、几何和机器人状态,变换反向接触抓取候选,离散搜索底盘平移和转向,再执行预抓取、下降、闭合与抬起;失败恢复快照换候选。Isaac Sim物理100Hz、控制与图像20Hz,64环境约每A40 GPU小时60条成功示范。
- 4
广泛适配后做场景个性化
图2右侧先以1024条多物体示范适配,再用约500条用户目标和部署场景示范微调π0.5。冻结SigLIP、更新语言主干与动作专家;部署时头部和腕部图像传到A40,输出10步动作块。这里的任务是放置面附近抓取,不是完整家庭长程导航。
实验与证据
已阅读全部正文六节;公开HTML未含额外附录,核对实验条件与原图;未独立复现。
来源证据101个校园室内场景、852个放置面、556个兼容资产;两个广泛生成活动共68021成功轨迹、273.46控制小时。 §IV、表II ↗
我的解读约1140万候选任务和45700小时只是全组合可行成功的外推,不是实际采集量。
来源证据各阶段单epoch、batch64、学习率5e-5到5e-6;轨迹条数相同但优化步数不同。Office同场景两阶段62.5%,直接个性化45.0%;Conference多场景两阶段51.4%,直接42.9%。 §V-A、图3、表IV ↗
我的解读+17.5个百分点来自Office,不是所有环境平均稳定增益。预训练基线0%也受到Stretch形态与动作空间未见过的影响。
来源证据两种策略各12个仿真episode、36次真实尝试。同场景策略仿真66.7%、真实63.9%,多场景策略50.0%、58.3%。 §V-E、图4 ↗
我的解读只两种策略和一个真实部署场景,不足以证明仿真能够普遍预测所有策略的真实表现。
来源证据陌生实验室黑桌与黄桌各18次/策略,同场景适配33.3%与22.2%,多场景22.2%与27.8%,排序反转。 §V-F、图6 ↗
我的解读两种策略均明显退化,不能据此断言多场景训练在所有新桌面获胜。
开放情况与使用许可
论文写明数据将在接收后公开;本轮全文没有提供可核实的官方实现或数据下载链接,不能标为已开源。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
将场景捕获、可达性过滤和自动示范连接起来,减少反复遥操作成本;实机结果说明场景匹配的仿真适配确实能转移到部分真实抓取。
反方 · 哪些结论还不够
仍需扫描、物体照片和尺寸,任务局限于抓取且依赖特权规划器;碰撞网格、摩擦与夹爪柔顺性存在仿真差异。小规模跨场景结果不足以支持普适泛化。
综合判断
适合作为部署场景专用数据生成方案,最值得借鉴的是自动发现放置面与可行性筛选。不要将建筑级扫描规模等同于建筑级自主任务能力。
我会先做的验证
未执行的验证方案:增加独立真实房间、相同优化步数对照和多随机种子;分别统计人工扫描时间、生成失败率、训练GPU小时与每目标成功率;测试尺寸偏差和摩擦变化下的退化。