StairVLA:缓存半成品动作,让小模型用新画面接着修正
把流匹配的中间轨迹作为层级接口;节省推理不能无限延长旧计划
StairVLA让高层VLA低频产生长时域的部分去噪动作,小型refiner再按最新图像修正短片段。两层通过动作生成过程的中间状态衔接,减少重复运行昂贵视觉语言骨干;论文同时显示,缓存计划过长、相机分布改变和复杂多物体排序仍会削弱表现。
图解主要方法
怎样复用昂贵的任务规划,又让动作持续响应新的视觉观测?
- 1
高层只做前段去噪,缓存长轨迹
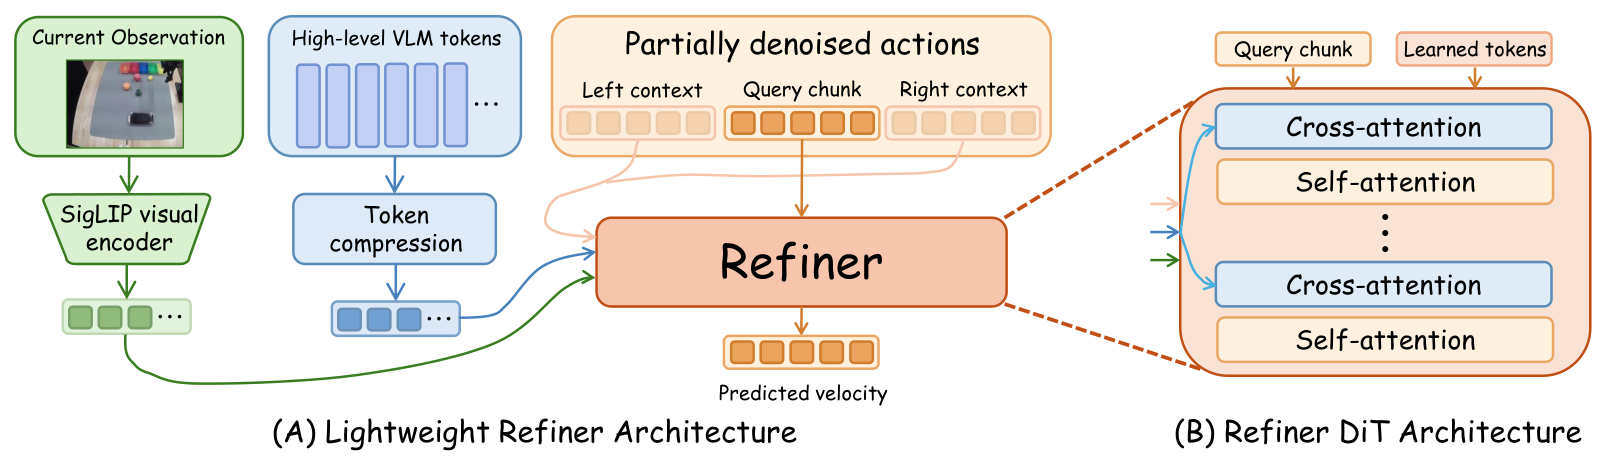
高层VLA保持原流匹配目标,把高斯噪声逐步变为动作,但在α小于1时停止。默认GR00T-style预测32动作,π-style为20动作;这些部分去噪动作连同高层语言视觉隐藏特征缓存,减少重复编码任务意图。
- 2
小refiner读取最新图像与邻接动作
图3左侧用可训练SigLIP-B/16处理主相机和腕相机,把高层隐藏状态压缩为8个768维token。当前5动作片段之外,再取前后各5个缓存动作作时间上下文;图3右侧16层DiT交错自注意力与交叉注意力完成修正。语言信息仍可经压缩特征进入,不能称完全无语言控制。
- 3
按预测误差重建训练路径
高层输出C未必落在理想噪声—真值直线上,所以refiner从C到真实动作重新插值,目标速度为(a_gt−C)/(1−α)。高层冻结而保持前向生成;仿真训练α=0.8、推理α=0.97,这是研究选取的不同设置,并非原模型无训练即插即用。
- 4
多频率执行,但旧计划不会被逐步改写
默认每个refiner输出5动作,4次修正后刷新高层,相当于20个环境步;修正后的动作不回写高层缓存。平均计算为T_ref+T_high/M。真机改为每块8动作、复用3块,并同步等待推理;延长M能摊薄费用,也延长高层对状态或意图变化的反应间隔。
实验与证据
阅读v2正文及附录A–C全部内容,核对原图3、官方项目页、实际代码树及许可;未运行训练或机器人复测。
来源证据LIBERO四套任务联合训练,每任务50rollout;高层30k步后refiner另30k步,batch128,8张A6000训练,A100测推理。 第4.1–4.2节、附录A ↗
我的解读两阶段训练预算与基线并非天然相等。主表只报成功点估计,缺少独立训练种子区间,1.3个百分点不能自动读作统计显著。
来源证据GR00T基线115.0ms/8动作;方法44.2ms/5动作,包含高层摊销和refiner,不含环境执行。 表1、附录表4 ↗
我的解读按动作数算115/8÷(44.2/5)≈1.63,而不是2.60;两者反馈频率也不同,因此即使算术归一化仍不是严格匹配的端到端比较。
来源证据去掉refiner92.4%,有refiner无动作上下文97.2%,完整97.8%;长高层H48/64复用40–60动作时约85–87%。 表3、附录B.3 ↗
我的解读局部修正很重要,但不能持续弥补陈旧高层计划;预测更远不一定允许等比例更久不刷新。事件触发刷新只是作者提出的后续方向。
来源证据LIBERO-Plus零样本70.4%,微调83.7%;相机43.7→95.5,但机器人扰动54.5→48.4。 表2 ↗
我的解读微调并非每类都改善。论文表中Libra-VLA零样本79.5更高,不能把“竞争力”改写为全面领先或跨相机开箱即用。
来源证据Fruit25有1186条有效示范,PushBlock100条;真机2B骨干、A4000,分别8Hz/20Hz,动作均经同样的位移旋转和关节速度限制。 附录C.1–C.4 ↗
我的解读每块8动作代表1秒/0.4秒开环执行,3块高层复用代表3秒/1.2秒,不含等待推理。固定相机与光照、人工近似摆位及小样本限制泛化结论。
来源证据Fruit25总138/170,但四水果排序仅2/10,且成功定义为至少三种分对;推块6/10。平滑性用约50Hz反馈统计所有成功和失败Fruit25轨迹。 附录表6–7及C.6 ↗
我的解读总成功率掩盖困难长任务;“排序成功”并不要求四种全对。平滑度中位数改善不等于碰撞风险或安全验证。
开放情况与使用许可
2026-10-11核对官方提交c128495cf8c9882734d2d8e21ed7db3435d96920,含HierarchicalVLA.py、Hierarchical_ActionHead.py及配置。README的LIBERO/Plus权重、PiperX权重与Fruit25/PushBlock数据仍为TODO,π-base第二阶段配置也待发布;不称完整复现包。
LICENSE论文和所引图3为CC BY 4.0。代码标称MIT,但所核对LICENSE另插入上游提交保留及rebase文字,不能直接视作未经修改的标准MIT;部分动作头保留NVIDIA条款。模型与数据许可需随实际发布另核对。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
LIBERO的GR00T-style实例平均成功率96.5→97.8%,π-style为97.8→98.3%;增加长时域但没有refiner仅92.4%,支持局部修正组件的作用。
真机Fruit25为138/170,GR00T和π基线分别130/170、129/170;推块6/10,对照为3/10和2/10,方向一致但样本仍小。
反方 · 哪些结论还不够
115.0→44.2毫秒按各自原生动作块计:基线8动作、方法5动作。按动作数粗略摊销约14.38→8.84毫秒,约1.63倍,仅是算术归一化而非同设置重测。
LIBERO-Plus零样本平均70.4%,低于表中Libra-VLA79.5%;相机扰动43.7%,目标分布微调后95.5%,泛化与适配不能混同。
注意力诊断只有16个样本并把轨迹加密到100步,原生推理为4步;GR00T的原始图像token注意力反而下降,不能说所有骨干都以同一机制转向视觉。
综合判断
值得借鉴的是部分去噪动作作为可复用接口,并用最新观测修正。当前证据支持有限缓存范围内的效率折中,尚不支持无限长规划复用、普遍零样本鲁棒性或所有实时控制条件下的加速承诺。
我会先做的验证
建议实验,未执行:在相同动作块大小、训练预算和控制频率下比较总时延与成功率;随机交错配对真机布局,增加接触扰动和中途改指令,比较固定刷新与事件触发刷新,报告最坏响应延迟及多训练种子区间。