SuperNav:让通用多模态模型通过工具指挥导航
视觉指点、技能说明和执行反馈形成闭环;强几何后端与评测成功条件决定结果边界
SuperNav让预训练多模态模型解释任务、在四向图像上选择目的点,并调用几何或学习控制器执行移动,再依据反馈搜索、复查与恢复。无需导航专项微调高层模型,单物体150任务成功率78%,多物体仅34%;结果体现完整系统能力,不能脱离几何资源、强模型和宽松到达规则解读为任意任务都可完成。
图解主要方法
通用多模态模型能否借助导航工具和可读取技能,在陌生环境持续搜索、复查并恢复失败?
- 1
让模型维护任务与证据
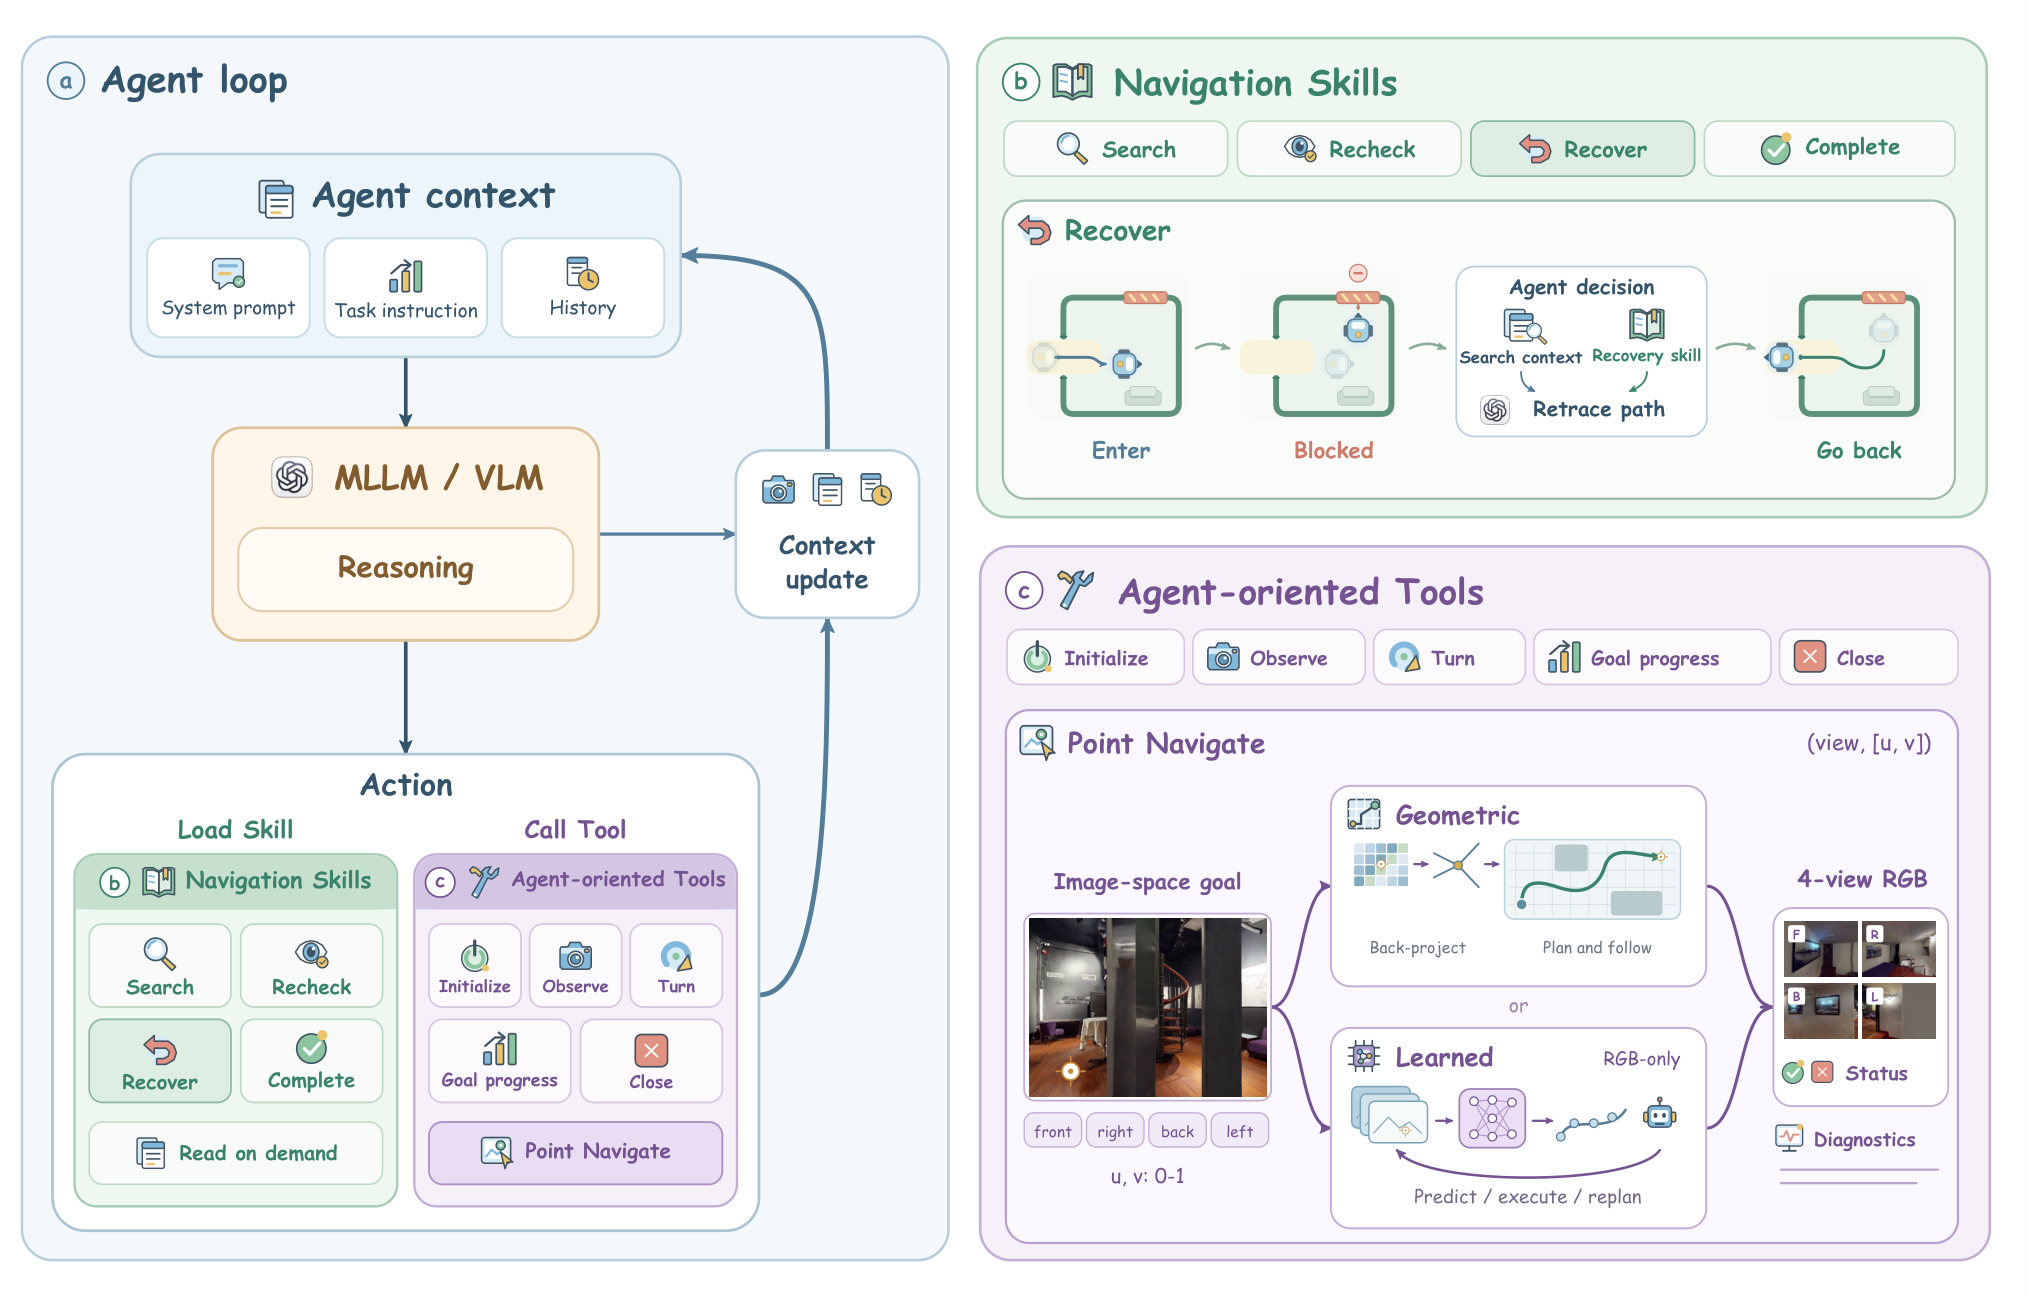
高层读取请求、四向RGB和历史,决定观察、移动、记录目标或结束。旧图被新观测替代后仅移除媒体载荷,文字历史、路径和目标状态保留,必要时可重新读取旧图;不是把整个历史压成一张图。
- 2
用图像点连接语义与移动
模型给出前右后左视角和归一化坐标u、v,工具移动后返回四视角、状态和诊断。几何后端通过深度标定反投影、导航网格寻找可达接近点;真实Go2用LiDAR累积代价图和里程计,不是同一套仿真真值。
- 3
替换为受训练的局部执行器
学习后端把目标点画在固定参考图上,DINOv2编码当前图、目标图和最多12幅带时间间隔编码的历史;Transformer融合后,流匹配头预测8个二维位移增量和停止概率。其视觉骨干与控制器经45000次更新训练,所以无导航微调仅指高层MLLM。
- 4
短段执行、重规划和恢复
控制器4步Euler采样16条轨迹,按方向一致和直线程度选一条,通常执行前3个增量再观测;碰撞与进度监控在工具内部处理。高层可阅读搜索、复查、恢复和入口技能,但这些文本不是强制执行状态机。
- 5
将停止声明与外部验收分开
高层报告完成或受阻,工具关闭会话;这只确认会话结束。目标达成由离线轨迹与目标位置规则另算,不把模型说成功或调用成功当作任务真实成功。
实验与证据
完整正文和附录A–C、成功定义、基线输入、学习控制训练及停止规则已读;图2视觉核验;作者项目页、README、PRL许可、模型卡与检查点文件清单核对。未运行导航。
来源证据150单物体任务:几何后端SR78%、SPL0.4127;学习后端68%、0.2059;最佳基线SR34%。 表1;B4 ↗
我的解读后端比较同时改变控制器和几何资源,不能将10个百分点完全归为网络或规划算法差异。
来源证据150有序多目标任务,两后端SR均34%,几何SPL0.1388、学习0.0862。 表1 ↗
我的解读多目标仍约三分之二失败,体现效率差距而非普遍完成长程任务。
来源证据200需求任务,几何59.5%、学习45%;成功是按序进入未复用物体的2米水平包围盒区域并STOP。 B2 ↗
我的解读不含视线、高度或活动操作检验;原DemandAgent采用不同功能依赖和1.5米条件,不能直接比较分数。
来源证据六、七、八阶段分别仅3、2、1任务,所有方法均未完成六阶段以上。 表4 ↗
我的解读小样本末段不能给出稳定泛化统计,短任务占比较大影响总体成功率。
来源证据120 OVON回合,几何在0.25米68.33%、1米73.33%;学习65%、70.83%。 表2;B6 ↗
我的解读本文不另要求Habitat STOP,两条指定不可达回合贡献成功1;必须保留计分口径。
来源证据移除技能0.25米SR35%;仅前视52.5%;两者同时去掉31.67%;完整68.33%。 表3;B6 ↗
我的解读导航技能和观测接口都贡献,但技能版本也随前视接口调整,并非只删一段文字的严格因子实验。
来源证据完整平均11.17工具调用、0.41次转向、16.44米;前视30.28、17.56、23.60米。 表6 ↗
我的解读四向观察减少为看侧后方而转身的动作,是接口机制的直接证据,调用统计不包括读技能shell操作。
来源证据替换GPT-5.6 Terra high为GPT-6 Astra medium,1米SR73.33到79.17。 表3 ↗
我的解读模型和推理设置一起改变,证明配置可替换,不隔离纯模型规模或推理预算贡献。
来源证据单回合3600秒、工具300秒;Go2几何控制10Hz,地图分辨率0.05米。 A1、A4 ↗
我的解读底层10Hz不代表高层实时,论文承认模型延迟变动大,未给可直接承诺的端到端反应时间。
来源证据学习执行器batch256、45000更新,DINO学习率1e-5、策略1e-4,45K步监督模仿仿真轨迹。 C1–C3 ↗
我的解读数据生成用深度检查可见性,推理控制不做深度反投影;训练与推理的传感器要求不能混写。
开放情况与使用许可
官方仓库提供运行时、导航工具、技能、实验配置及评测工具;模型卡列出249157807字节的局部执行器检查点。InteriorGS单/多目标任务、需求驱动任务清单和Unitree Go2驱动未发布;AI2-THOR公开配置评分为withheld,SR/SPL为空。
LICENSE代码与局部执行器权重使用PRL v1.0:学术、教育、评估或个人用途免费免注册,组织项目使用须先注册;不是无条件MIT。DINOv2等第三方保留原条款。论文图2为arXiv非独占托管许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
同120个OVON回合、固定几何执行器,移除导航技能时0.25米成功率68.33%降35%,支持程序性指导对最终接近目标有作用。
使用同一视觉点接口替换学习执行器仍保留较高成功率,表明高层工作流与底层运动可一定程度解耦。
反方 · 哪些结论还不够
基线保持不同相机视野和自身历史机制,本文用强多模态模型、四视角与特权几何,整体优势不能单独归于技能文本。
需求评测用2米水平包围盒,不检测可见性、高度或实际活动完成;同一位置甚至可连续完成多个阶段。
OVON与部分外部方法在样本、STOP要求、动作预算上不同,两条不可达回合直接记成功,不能视为统一排行榜。
综合判断
证据支持通过视觉点接口和执行反馈组织通用导航智能体,但不足以兑现标题的任意任务与任意场景。最可靠结论来自共享任务和后端的内部消融,真机可靠性与长期自主运行仍待量化。
我会先做的验证
建议实验(尚未执行):固定决策模型、输入视野、动作与时间预算,对比相同几何信息下的技能和接口;记录所有重试、闭环定位误差、成本和延迟,在独立场景重复真机试验,并把到达、看见、正确识别和完成活动作为四个独立指标。