SWE-Proof:通过证明检查,为什么仍可能修错代码
规格、程序映射、隐藏测试与审计是四条不同的信任边界
SWE-Proof 为真实仓库修复任务构建形式化规格与参考实现,并分别检验补丁、证明和语义对应。它最有价值的发现是“证明了错误抽象”仍会失败;当前预印本部分正文与附录数字不一致,本篇侧重可核对的方法及案例,不据此给模型排确定名次。
图解主要方法
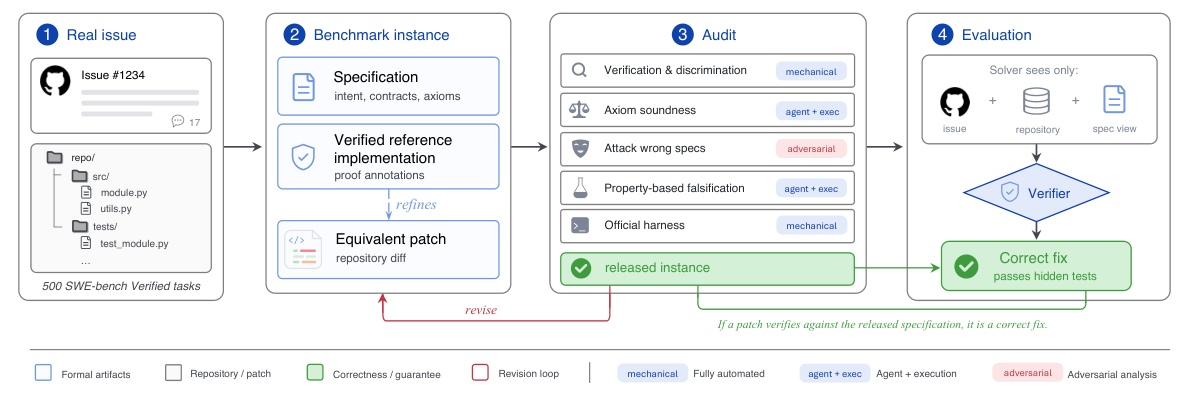
图 2 的 Benchproofer 门控,能把哪些结论交给机器,哪些仍依赖审计?
- 1
用正确补丁构造评测,但不能把它当作求解输入
构造阶段读取 issue、参考补丁和测试,写出新行为的规格,并用公理概括未改变的被调函数。求解阶段再按不同设置给出 issue、定位或规格;这些设置提供的信息不同,必须分开比较。
- 2
通过三种形式后端建立可检查对象
Nagini 在 Python 合约上检查;Velvet 使用命令式 Lean 表示;纯 Lean 用内核检查证明。EARS 结构化英语是非形式对照。对后两种后端,把真实 Python 转成模型本身就是信任边界,验证模型不能自动覆盖整个仓库。
- 3
图 2 中的机械门控先排除空证明
参考实现必须通过,修复前的实现必须失败;加入反例、变异测试和防逃逸检查。未改变函数的公理要探测,模型与真实程序要做差分运行。十万级生成输入能够查出不一致,但有限测试不是程序等价性的完整证明。
- 4
再审计规格是否真正表达任务
独立模型审计公理、可接受输入、可靠性、区分能力和忠实性。模型投票是经过测量的审计方法,仍不是形式证明;参考行为不充分的 issue 还会出现信息冲突:给出精确规格可能透露公开问题中没有的答案。相关实例需要单独标注或剔除分析。
- 5
用附录 I 的失败案例理解抽象损失
Django 的日期组件会产生 ValueError 或 OverflowError。一个候选规格把两者合成“回退”,因此候选补丁与证明一致、证明也通过;隐藏测试却要求溢出返回精确的 0-0-0,而另一错误保留原输入。丢掉返回字符串的抽象无法辨别两种补丁,继续加证明步骤也补不回来。
- 6
比较收益时先控制定位与规格提示量
主实验覆盖 500 个 SWE-bench Verified issue,扩展到 SWE-bench Pro 的 242 个可用 Python 实例。已提供规格常能帮助旧基准,但 Pro 上没有一致收益;自写规格也不自动提升修复成功率,不能把“形式验证工具可运行”变成“真实修复可靠”的同义词。
实验与证据
以下为作者报告;已阅读 v1 全文及附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【主表 2,500 题单次】Nagini 给定规格时,Opus-4.8/GPT-5.5 测试解决率为 96.2%/94.4%;普通基线 85.0%/81.2%。 主表 2、附录 A.4 ↗
我的解读规格提供额外定位和行为信息;提升不全来自证明。部分实例有非披露约束放宽,给定规格设置应看作受助上界。
来源证据【一致性核对】主表 2 的定位基线为 88.2%/87.0%,附录表 32 标为首轮的定位结果却是 91.4%/85.4%;附录 F.3 的基线审计说明与其他审计表亦不一致。 表 2、表 32、附录 F.3 ↗
我的解读当前版本不能把所有表视为同一轮无缝互证。保留表号及口径,等待作者澄清,不用冲突数字生成确定排行榜。
来源证据【主表审计口径】基线测试率与审计通过率之差为 26.8/47.8 个百分点,分母是全部 500 题。 主表 2 与审计统计 ↗
我的解读不能写成“通过测试的补丁中 26.8%/47.8% 有误”;条件比例需要另除以测试通过率,且审计本身不是绝对真值。
来源证据【Pro 扩展】242 题上给定形式规格约 55.8–59.9%/38.0–39.3%,定位基线 61.2%/51.7%。 附录 G.1 ↗
我的解读帮助在更难仓库任务上并不普遍。给定规格还可能增加理解成本或引入模型映射问题。
来源证据【完整失败记录】附录 I.2 的形式模型首次验证通过,真实补丁未解决任务;I.3 独立运行的三个评委均指出遗漏返回文本。 附录 I.2–I.4 ↗
我的解读这是具体的抽象缺口,不是模型作弊,也不是验证器错误;它支持把规格审查与补丁测试作为独立交付。
开放情况与使用许可
附录 J 声明拟发布的自有管线和规格采用 MIT;本次未核实可下载正式仓库。MIT 声明不覆盖上游 issue、参考补丁、容器或模型 API,不能视为全部制品已开源。
LICENSE论文 arXiv 非独占分发;自有制品声明 MIT,实际发行待核实;引用的仓库内容各遵循原项目许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
将形式证明、真实测试和规格忠实性分开记录,能防止把一个绿色证明标记解释成所有行为已正确。
反方 · 哪些结论还不够
规格仍是部分模型,公理和 Python 转换存在信任边界;预印本数字冲突及被辅助的信息量限制了排名解释。
综合判断
方法与失败案例值得深入研究;当前最稳妥的应用是增加可审计证据,而非撤掉测试或宣称仓库修复已获得无条件保证。
我会先做的验证
未执行的验证方案:固定同一批 issue 和定位信息,剔除披露放宽实例,独立人工检查规格与真实补丁映射;保留验证通过但测试失败的反例,并对正文与附录每个冲突单元逐一复算。