TacitVLA:让动作不再等待当前推理文本
推理监督、历史记忆与当次文本输入,哪一部分真正帮助机器人行动?
TacitVLA保留推理文本的训练监督,却屏蔽动作专家对当次推理token的注意力。无需历史记忆时直接省去文本生成;需要记忆时在执行动作期间生成下一次调用要读的记录。四组受控实验支持这种拆分,但收益依赖训练标注和执行窗口,不等于完全无需推理或记忆。
图解主要方法
推理监督、历史记忆与当次文本输入,哪一部分真正帮助机器人行动?
- 1
固定训练序列,拆开两个作用通道
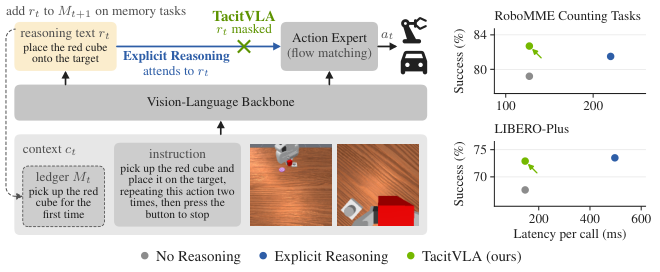
视觉语言骨干预测推理文本及离散动作辅助目标,动作专家以flow matching学习连续动作。显式推理与TacitVLA使用相同数据、提示和优化器,关键差异是动作位置能否注意当前推理文本;训练监督仍会更新动作所依赖的骨干表征。
- 2
以注意力掩码切断当次依赖
动作专家能读观察、此前记忆和自身动作块,但不能读当次生成的推理文本,也不能偷看离散动作目标。图1左侧的虚线只把文字送入下一次调用的记忆,而不是当前动作。
- 3
按任务决定省略或延后生成
LIBERO和驾驶不保留推理记忆,部署可不生成文本;RoboMME计数与RMBench要保留子任务记录,先算动作,再用共享前缀缓存生成文字。若生成超过动作执行窗口,下次调用仍须等待超出部分。
- 4
区分意图记账与执行结果
RoboMME每16步动作后才写入本轮子任务,去除相邻重复并按回合重置。记录描述尝试做的动作,不携带结果;失败抓取也可能留下记录。因此正确的文字计数不保证物理按钮按压次数正确。
实验与证据
已阅读正文1–7及附录A–D,含图4–8成功与失败轨迹,核对实验条件与原图;未独立复现。
来源证据全16任务训练时RoboMME总成功率46.5/45.8/48.1(无推理/显式/Tacit);RMBench四任务60.4/77.0/77.5;LIBERO-Plus 67.6/73.5/72.9。 表3–5:三次评估种子 ↗
我的解读17.1是RMBench相对无推理的百分点差,且无推理同时没有ledger,不能单独归因文本监督。LIBERO-Plus略低于显式版本;“匹配”不是所有单元都更好。
来源证据LIBERO每次147ms对495ms,约3.4倍延迟比;RoboMME动作127ms、文字93ms,文字可落入800ms执行窗。驾驶127ms对269ms,但控制步为100ms。 附录C / 表15:单H100 80GB、bf16计时 ↗
我的解读文字生成不阻塞动作并非整体零延迟。驾驶仍未满足100ms周期,不能将加速结果写成已经实现该控制频率的实时系统。
来源证据Tacit场景分52.5,显式52.3,无推理46.4;Tacit责任碰撞6.7%、驶离道路10.0%,显式分别5.5%、9.0%。 表6:驾驶公开441场景、每场景三次 ↗
我的解读综合分接近不意味着安全相关子指标同样好;训练使用380万专有驾驶事件,不能把公开评测集等同开放训练数据。
来源证据相机扰动下Tacit42.2而显式51.5;Press Button最终ledger正确率两者均99.7%,动作成功率却约74%。附录原图展示计数正确但确认按压或物体放置失败。 附录B–D:分轴结果与失败图 ↗
我的解读说明总均值掩盖视觉扰动差异,文字记忆正确仍需可靠执行。论文项目页说最大占窗12%,附录实测最长180/800ms约23%,以附录口径为准。
开放情况与使用许可
论文CC BY 4.0;作者项目页明确Code soon,未发现实现或检查点下载。驾驶训练语料为专有,不标为完整开源。
LICENSECC BY 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
通过相同序列下的注意力控制,较清楚地区分推理监督带来的表征收益与在线生成成本;对需要历史记账的策略也给出可实施调度。
反方 · 哪些结论还不够
只覆盖所测架构与基准;推理标注质量、训练ledger与生成ledger分布差仍影响结果。记忆任务无推理对照同时失去ledger;RoboMME权重按三档取优,未代表任意训练配方。未有实机验证或普遍实时性保证。
综合判断
值得用于VLA延迟优化,但应同时审计子任务记忆、逐扰动性能与控制周期,不能把“无需等待当前文字”宣传为“不需要推理”。
我会先做的验证
未执行的验证方案:在等参数、同训练与同执行窗口下增加仅ledger、仅推理监督对照;缩短动作块并拉长文本,测超窗比例、尾延迟、错误记账传播和真实接触任务成功率。