TacPAC:预测接触之后,随触觉修正尚未执行的动作
复用触觉—动作缓存,让快速修正不必重跑整个世界动作模型
慢速世界动作模型可以预估未来接触,却来不及为每次触觉变化重生成整段动作。TacPAC 先联合预测视觉、触觉和动作,再缓存触觉—动作表示,用轻量专家将当前触觉与预期接触比较,只修正仍未执行的动作后缀。
图解主要方法
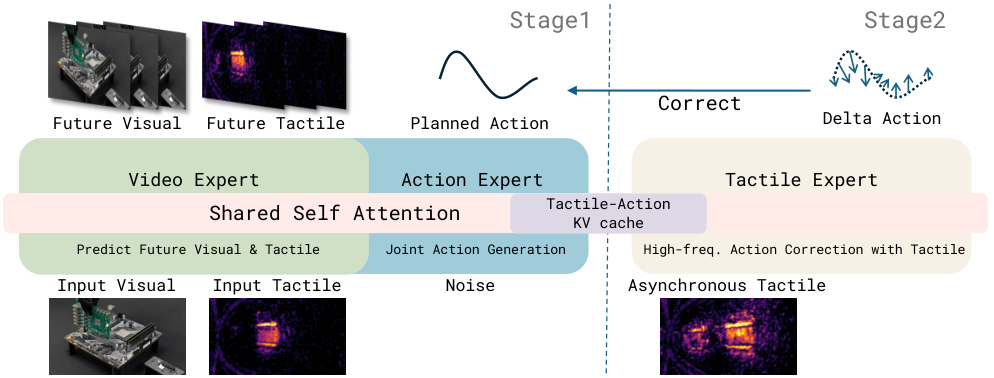
图 2 的触觉专家为何既需要当前触觉,也需要计划留下的缓存?
- 1
先联合生成接触预期与动作计划
图左视频专家预测未来视觉和触觉,动作专家通过 Mixture-of-Transformers 注意力据此生成动作块。视频侧不读取动作侧,信息流并非完全对称;实验每块 48 步、30Hz,约 1.6 秒。它提供的是当前计划的接触预期,不是新触觉到来后的重规划。
- 2
用一次干净前向保留可复用状态
基础模型完成 10 步 flow 采样后再进行 clean pass,缓存各层触觉及动作键值。图中的 KV cache 把“计划认为应发生什么”和动作表示一起保存,触觉专家便不必重新运行视频和动作专家。缓存建立时间也属于整个计划成本。
- 3
冻结基础模型,只训练残差修正器
第二阶段对每个计划抽取四个执行偏移,输入当前触觉、已执行前缀、时间偏移和缓存,监督动作修正量。修正针对原计划而非上一次修正递归累加;训练接触和前缀主要来自记录轨迹,实际执行后的状态偏移仍可能产生分布差距。
- 4
等计算完成后再提交未执行后缀
若触觉在偏移 m 到达,修正计算耗时 d 步,只将原计划加残差写入 i≥m+d 的位置。已经运行和计算期间正在运行的动作不能被回写;快专家提高反应速度,却不消除通信与物理执行延迟。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【真实机器人】Flexiv Rizon 4 与 InTacS1,五任务每方法每任务 20 次;平均成功率 64%,T-Rex 为 48%,视觉基础模型为 22%。插头/水果/薯片/瓶子/扩展卡分别为 80/65/90/40/45%。 真实机器人主表 ↗
我的解读我的解读:提升跨多种接触任务出现,但瓶子和扩展卡仍低于一半,不能据平均值称为可靠生产策略。
来源证据【组件消融】只有触觉预测 37%,只有反应修正 33%,去掉触觉缓存 47%,完整方案 64%。 组件消融表 ↗
我的解读我的解读:支持“预期接触+观测偏差”的组合价值,而不只是多加一个传感器;仍需在相同参数量与训练预算下验证替代融合方式。
来源证据【时延与训练】单次修正 30.4ms,生成基础计划 628.6ms,另有 62.6ms cache prefill;训练配置使用 8 张 H100、batch 64、10 epochs。 效率与诊断附录 ↗
我的解读我的解读:20.7 倍是修正相对完整生成的耗时比,不是整体流水线 20.7 倍提速。附录 296 条诊断轨迹不是总训练集大小。
开放情况与使用许可
09-04 首发,今日回顾。官方仓库包含模型、训练、预处理、部署和测试代码,核心触觉专家已抽查;README 明确数据和 checkpoint 仍在准备,不能称权重或数据已开放。
LICENSE仓库自称 MIT;LICENSE 在 MIT 文本中另附 rebase 与上游提交保留要求,GitHub 识别为 Other,使用时需核对完整条款。第三方模型和机器人驱动另行授权。论文图片不是开放许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
将预测当作解释新接触的参照,并严格限制残差可提交的时间范围,提供了慢规划和快反馈结合的具体接口。
反方 · 哪些结论还不够
修正器训练前缀与真实闭环状态可能不匹配,低成功任务、端到端延迟及跨物体泛化仍是瓶颈。
综合判断
适合有高频触觉且基础规划较慢的接触任务;部署评估应关注错过的修正窗口与最差任务,而非只看平均成功率。
我会先做的验证
未执行的验证方案:在保持基础模型不变时注入可控传感/网络延迟,比较反应专家、无缓存和完整缓存;记录触觉到执行的实际年龄、各任务失败类型、累积偏移与损坏率,并测试未见材质。