TAO:工具等待期间,怎样安排 GPU 才不浪费缓存
缓存亲和、工具就绪与 token 数为何要按优先级共同调度?
智能体调用工具时会暂时离开 GPU,但其 KV 缓存仍有价值。TAO 在工具返回边界重做会话准入与节点分配,用缓存信用、就绪预测和 token 数组成分层目标;收益依赖工作负载,并非每种延迟指标都改善。
图解主要方法
缓存亲和、工具就绪与 token 数为何要按优先级共同调度?
- 1
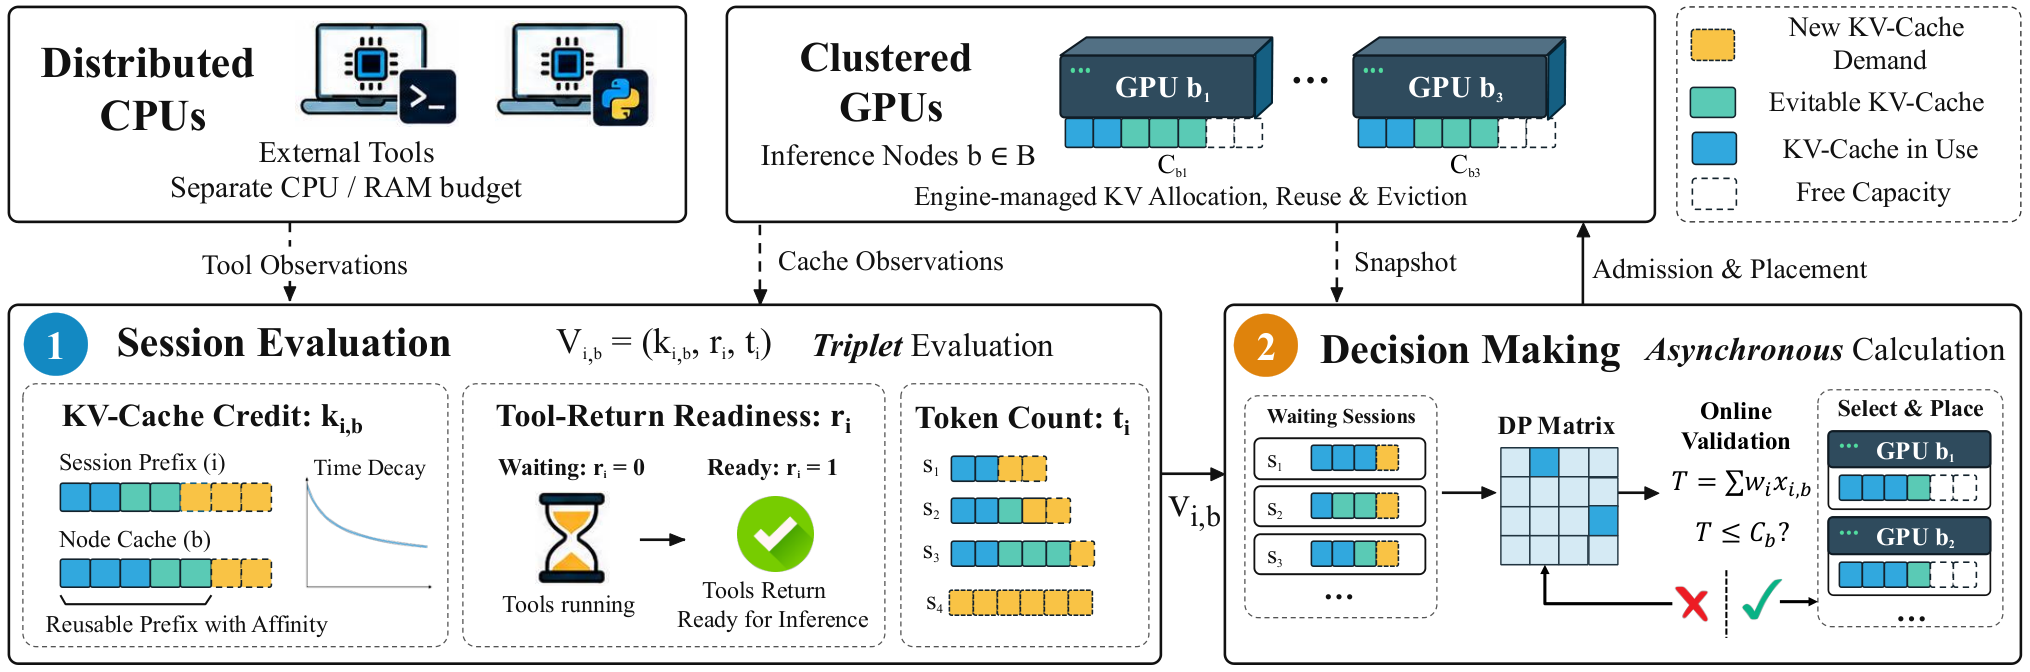
读图2:CPU 工具与 GPU 推理分开
图上方的工具在分布式 CPU 执行,推理集中于多组 GPU。调度器观察可复用前缀、节点容量与工具状态,决定哪些会话应恢复、放到哪组 GPU。它不直接替代引擎的 KV 淘汰机制。
- 2
先保缓存,再比较是否就绪
每个会话以三元组作词典序比较,而非三个分数随意加权。缓存信用随空闲时间按10秒半衰期衰减;工具已完成则覆盖预测,否则使用显式超时、sleep 信息或历史均值加裕量,冷启动默认5秒。历史裕量只是启发式,不是单次时长的校准置信区间。
- 3
快照上求解,执行前再核验
将需求向上取整、容量向下取整后用动态规划分配;求解异步进行,执行前重新检查容量与会话状态。所谓精确解限于冻结且量化后的组合问题,不等于真实系统全局最短完成时间。
实验与证据
已阅读全文正文与附录A时长估计,核对实验条件与原图;未独立复现。
来源证据DeepSeek V4 Flash 的 SWE-Lite、64并发配置中,平均延迟253.228降至185.410,TTFT .351降至.224,解码吞吐1561.307升至2021.523。主要平台为2组4张H100或4组2张H100。 正文表1—2:两种模型、12种负载配置 ↗
我的解读相对各指标最佳基线分别约改善26.8%、36.3%、29.5%;不同指标基线不同,不可拼成一次相同对照。
来源证据TerminalBench 的解码吞吐有约6%—9%回退;AutomationBench 128并发时 TTFT 为19.123,而 Dynamo 为3.166。35个分配快照中6个改善、29个持平。 负结果与调度消融 ↗
我的解读缓存优先可能牺牲某些请求的等待时间;快照收益不能代替尾延迟与公平性评测。
开放情况与使用许可
截至10月30日,已核对论文正文与附录A;论文未给出可核实的官方实现链接,不能称系统已开源。
LICENSECC BY 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把工具阶段纳入推理服务设计,比只统计模型 token 吞吐更接近真实长任务。论文提供跨负载结果和失败配置,值得服务端调度团队关注。
反方 · 哪些结论还不够
时间衰减与就绪窗口依赖部署分布;工具时长突变、长尾请求及跨模型公平性仍可能退化。部分表格与正文对“最高吞吐”的叙述不一致,本文以数值表为准;没有独立复现。
综合判断
是有条件的系统优化证据,尚不能推出所有智能体服务都应缓存优先。
我会先做的验证
未执行的验证方案:固定模型、GPU 与请求轨迹,比较中位数及P99完成时间、缓存命中、饥饿率,并加入长工具延迟与预测失准压力测试。