R2S:会完成任务的老师,为什么给拖延打高分?
把教师的接管经验蒸馏回逐 token 评分器,修复多轮智能体的短视监督。
R2S 发现教师自己能完成任务,却可能在逐 token 蒸馏时放过学生的无效搜索与拖延。它从学生失败轨迹中寻找分歧状态,让教师接管,再用成功续篇校准教师对原学生轨迹的评分。价值在于改善监督者,而非单纯换一个更大模型;“无奖励”仍依赖可观察的完成信息或评审。
图解主要方法
把教师的接管经验蒸馏回逐 token 评分器,修复多轮智能体的短视监督。
- 1
1 · 在真实学生状态上找分歧
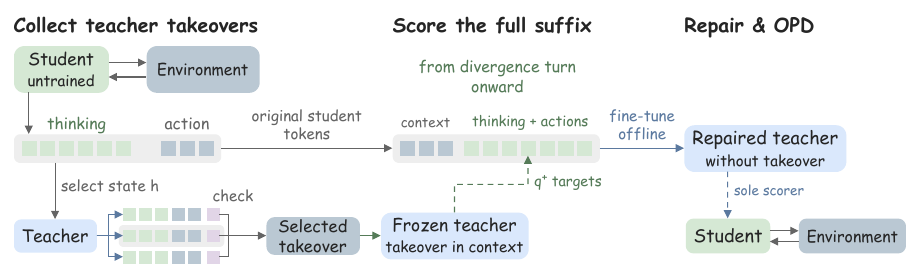
图2左侧先运行未训练学生,依据思考 token 的平均师生对数概率差选状态,每个目标最多3个、总计最多2400个。不是只挑成功专家轨迹:教师从这些偏离状态各接管8次,因此离线阶段最多增加19200次环境续跑。
- 2
2 · 用接管结果重评原轨迹
图2中部把通过共识或评审的最短接管续篇放进冻结教师上下文,让它为分歧回合之后的全部学生 assistant token 生成 top-16 归一化分布。监督对象仍是学生原来的思考与工具调用;教师接管文本不会替换学生动作。
- 3
3 · 让评分器脱离特权上下文
教师副本学习这些分布,但看不到接管续篇;修复后重新冻结,成为普通 on-policy distillation 的唯一评分器。学生在自己的多轮轨迹上继续学习,不需要在部署时检索教师未来。图2右侧的两次蒸馏分别修老师和教学生。
- 4
4 · 分清无标量奖励与无结果信息
ALFWorld、ScienceWorld 的选择会使用环境完成信号;WebShop 用模型评审购买结果并检查共识。方法没有把任务标量奖励直接放进学生损失,但并非完全没有任务结果监督,也要求环境状态能够恢复并接管。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据12个教师—学生—环境组合覆盖 Qwen 系列2B至30B;主表每格一次训练、最终检查点三次解码。9B→4B 时,ALFWorld 从普通 OPD 的65.8%到81.9%,WebShop34.6%到55.9%,ScienceWorld34.6%到47.8%。 表2与附录实验协议 ↗
我的解读多个环境同向提升支持评分修复,但解码方差不能替代独立训练种子的稳定性。
来源证据12个组合中11个教师接管表现高于学生;30B-A3B→8B 的 ALFWorld 接管42.2%低于学生45.5%。 表1及接管分析 ↗
我的解读“老师更强”不是所有状态都成立,应先测接管能力再决定修复数据来源。
来源证据WebShop 标签SFT对照46.7%,R2S55.9%;超回合失败比例下降。部分重复训练实验共享同一个修复教师。 消融与长程行为分析 ↗
我的解读结果提示评分分布不同于直接模仿答案;搜索词减少仍是描述性现象,不能单凭词频断言因果机制。
开放情况与使用许可
核查 r2s 固定标签的实现文件和 Apache-2.0 LICENSE;仓库说明 main 可能重构。HF 已列24个检查点,抽查 ALFWorld Qwen3.5-4B 学生模型卡及权重目录,模型卡为 Apache-2.0;第三方环境保留各自许可,未本机复现。
LICENSE论文与原图 CC BY 4.0;代码及所核模型卡 Apache-2.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把任务级成功经验转成局部评分,可以缓解智能体蒸馏中“每句合理、整段无进展”的问题;对有可重放环境的工具智能体值得复现。
反方 · 哪些结论还不够
只验证 Qwen 家族与三个可重放环境;额外接管及教师修复计算未与所有基线匹配总预算。主表大多单次训练,且所谓无奖励仍含完成判断,不能外推到无法检验结果的开放任务。
综合判断
证据支持先诊断教师评分,再做学生蒸馏;尚不足以证明任意强教师都能被同样修复。
我会先做的验证
未执行的验证方案:固定总环境调用和GPU预算,以普通OPD、成功轨迹SFT、R2S各跑3个独立种子;分别遮蔽完成信号与改变接管选择器,报告成功率、超时、每次成功成本。