Telescopic LM:把每个网络前缀都训练成可用出口
一次训练覆盖连续深度,但中间尺寸仍不如专门训练的模型
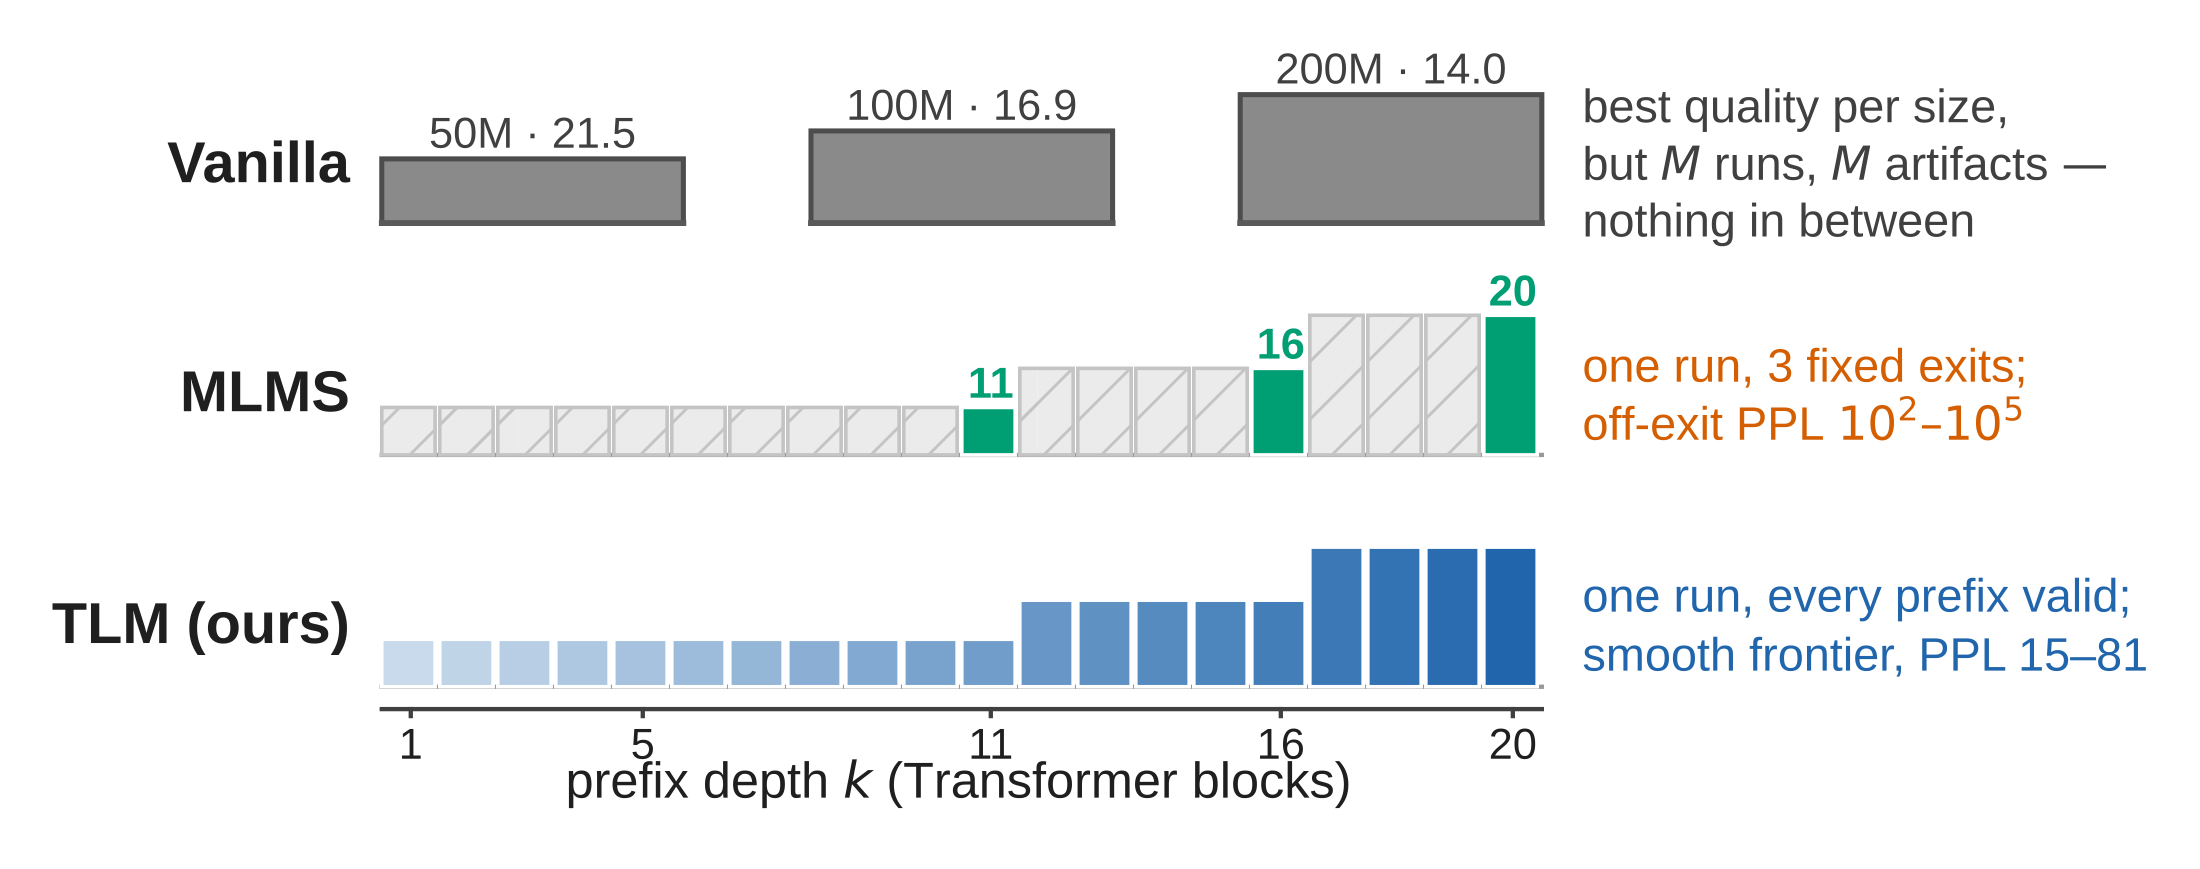
固定几个早退层的模型,在未训练的深度停止常会崩溃。TLM每个批次随机训练一个前缀,再锚定完整网络,使1至20层都能输出可用概率;其收益是预算覆盖更平滑,不是所有尺寸精度更高,也没有实现逐token任意切换深度。
图解主要方法
图1中的连续出口来自哪些训练约束,为何不能把覆盖面积直接等同模型准确率?
- 1
保持嵌套宽度结构不变
20层依次为11层宽320、5层宽576、4层宽960,沿用分阶段输出头。改变的是哪些深度获得监督,而非为每个预算重新训练独立网络;浅前缀天然缺少深层表达能力。
- 2
对同一批次做随机前缀监督
从1至20均匀抽k,以前k层预测完整语言建模目标。第j层只有在k≥j时收到这部分梯度;随机覆盖让非预设出口也学习输出,而不是推理时临时截断未经训练的层。
- 3
再用完整网络目标作锚
每批额外计算20层的交叉熵,和前缀损失共同更新共享参数。去掉全深锚会使完整模型困惑度显著恶化;浅层覆盖与全深质量存在取舍,不是免费的多模型压缩。
- 4
按完整预算曲线评估部署
推理为每次请求选定一个深度,论文未解决生成途中变更深度后的KV缓存一致性。AULB、LODA积分衡量多个预算点的覆盖,容易突出固定出口基线未训练的区间,应同时查看指定深度与独立模型的绝对困惑度。
实验与证据
以下为作者报告;已读v1完整正文,并检查arXiv源包。作者引用的独立补充PDF未公开取得,未声称读过附录;本站未执行研究实验。实验条件与编辑解读分别列出。
来源证据【训练条件】约200M参数、20B FineWeb-Edu token、序列2048、20层。TLM完整困惑度14.99,固定出口MLMS约14.98,独立200M模型13.98。 实验设置、表1 ↗
我的解读我的解读:保住的是共享网络原本的全深水平,不是达到独立训练上界。
来源证据【覆盖收益】均匀前缀困惑度约81至14.99,MLMS未训练出口可达10²–10⁵;AULB约3.28对5.73–5.90。 图1、图2及AULB定义 ↗
我的解读我的解读:曲线面积改善主要反映随时可停的覆盖能力,不能转述为语言准确率提升约四成。
来源证据【取舍与范围】固定出口50M困惑度21.89,而最佳TLM约24.38;无全深锚时完整模型22.32。主比较多为单种子,主TLM补两种子。 中间出口、去锚与复现说明 ↗
我的解读我的解读:中间点质量会付出代价;200M规模结果不足以保证大模型、长上下文和多任务效果。
开放情况与使用许可
已读公开正文;作者称另有独立补充PDF,已检查arXiv源包和公开链接,源包未含该补充PDF;因此未核实独立附录,本文只依据可取得的完整正文。论文承诺后续发布代码,尚未核实专属实现及权重。
LICENSE代码与权重许可未确认;论文仅arXiv非独占分发,必要原图引用见图注。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
用简单的前缀覆盖目标把离散计算预算变成连续选择,对端侧或动态负载服务有明确研究价值。
反方 · 哪些结论还不够
特定预算精度、双次前向训练成本和固定请求深度限制部署;大规模与跨种子验证有限。
综合判断
可作为弹性计算的训练方案,但应按真实请求分布评估质量—延迟曲线,而非只看积分面积。
我会先做的验证
未执行的验证方案:在相同训练FLOPs和多种子下比较固定出口、随机前缀及独立模型,按真实设备测各深度P95延迟与任务准确率;另测切换深度所需缓存重算,避免只用参数数估算速度。