Temporal Flow Policy:让机器人记忆按真实秒数演化
控制频率变化时,策略能否仍然知道已经等待多久?
Temporal Flow Policy 在扩散策略与π0.5动作头前增加轻量记忆:用真实时间间隔控制各通道的指数保留率,让长短时间信息以不同速度更新。实验把控制步数与物理时间分开干预,但不能把这种局部积分性质理解为任意采样频率下完全不变。
图解主要方法
控制频率变化时,策略能否仍然知道已经等待多久?
- 1
分开估计记忆内容与时间尺度
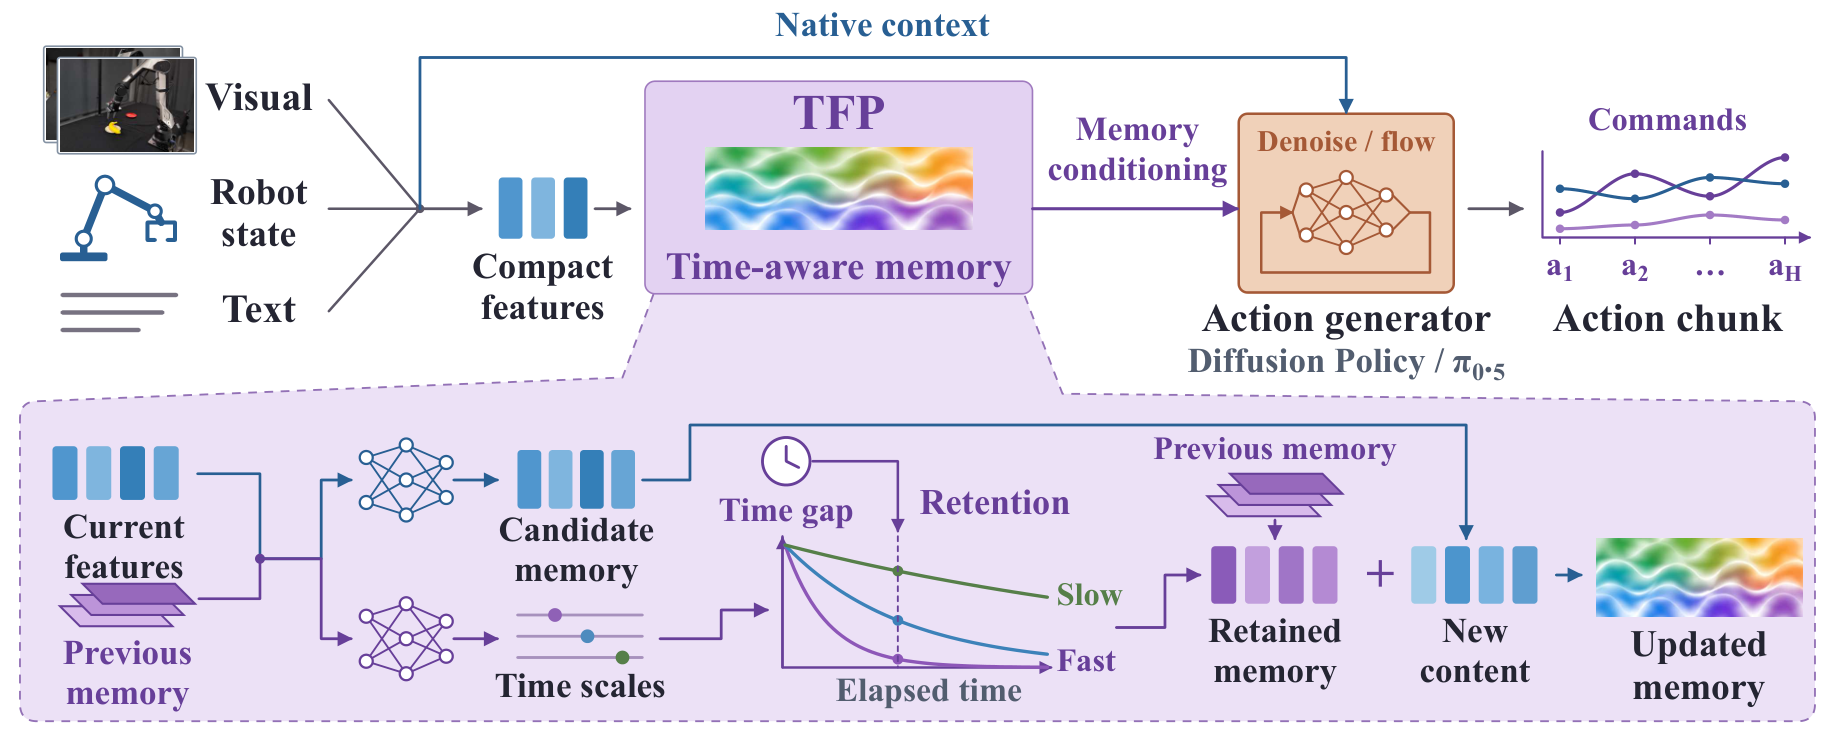
图2输入视觉、机器人状态和文本特征,与旧记忆一起预测候选内容及各通道正时间常数τ。时间间隔Δ直接进入后续积分,不作为预测τ的头部输入;每个episode重置状态,避免跨任务污染。
- 2
按真实时间更新记忆
保留率k=exp(−Δ/τ),新状态h=k·h旧+(1−k)·候选。短τ通道快速变化,长τ保留过去;零间隔不更新。固定系数时对应松弛微分方程精确解,但每次查询重新估计系数,因此全局行为不保证对频率严格不变。
- 3
一次更新供整个动作块使用
记忆投影加到Diffusion Policy的AdaLN或π0.5的AdaRMS条件,单次策略查询只更新一次,内部多步去噪/流求解共享该记忆。DP与π0.5分别使用128与256维状态,存储量不随历史长度线性增长。
- 4
用原生模仿学习学习计时
训练无需事件标签,固定0.1秒节奏,不做时间扰动增强;DP从头训练,π0.5冻结VLM、训练动作专家和记忆。部署测试5Hz、抖动和丢查询,查询间动作继续执行;训练成本最高设置仍需4张H200约80小时,不能因记忆小就称训练便宜。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据每种子每节奏各50次按键、50次通行、300次拦截;跨任务与节奏均值DP为77.5,对比S4D+Δ62.1;π0.5为73.3对66.8。 三种计时仿真、三种子、多种查询节奏 ↗
我的解读我的解读:显式Δ有帮助,但并非每列都赢;例如π0.5按键5Hz时S4D为98.7、TFP95.3。
来源证据把输入时间间隔缩小一半导致延迟,放大导致提前;按键和通行在相关时钟干预下成功率降为0。记忆重置也使三任务10Hz表现归零。 固定权重改变时钟的干预 ↗
我的解读我的解读:时钟干预比单纯线性探针更支持模型确实利用时间;通行探针0.0373秒误差仅适用于训练/测试所用名义10Hz分布。
来源证据五任务每项50演示、20评测,DP由17%到64%、π0.5由26%到76%;茶浸泡与分段加热使用人为缩短的3±0.5秒规则。LIBERO98.7±0.2对照96.9来自已发表OpenPI结果。 Galaxea A1实机与LIBERO边界 ↗
我的解读我的解读:实机对照是反应式策略,未含强时间记忆基线,也未证明实机变频鲁棒;短时加热任务不代表真实烹饪安全。
开放情况与使用许可
论文CC BY 4.0;未核实本方法独立官方代码与权重。引用的OpenPI是基础依赖,不能当作TFP实现已开放。
LICENSECC BY 4.0(论文与所引原图)
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:用采集时间戳而非控制步号驱动记忆,直接针对机器人实际部署中的等待、掉帧与节奏变化。
反方 · 哪些结论还不够
时间戳噪声与长等待后的指数饱和仍需验证;实机强基线不足,LIBERO外部基线不是完全等配置复跑。
综合判断
适合加入需要短中时程计时的动作策略,作为可验证的时间记忆模块,而非通用长任务记忆的替代品。
我会先做的验证
未执行的验证方案:在同一实机控制器上比较GRU+Δ、S4D+Δ和TFP,随机注入时钟偏差、掉帧与长等待,报告真实完成时刻偏差、任务成功及接管率。