Text-Centric Omni:先用文本增强推理,再以少量音视频恢复感知
训练便宜但能力有取舍;纯文本路线不能完全替代原生感知训练
研究发现单跳感知正确并不保证多跳音视频推理正确,用局部梯度投影分析两目标的部分可分性。文本SFT与GRPO能增强Omni模型推理,但会损伤感知;最终加入减少数据量的音视频GRPO恢复感知。最强文本数据来自视频脚本,另有完全由文本LLM合成的独立实验,不能混为一条无多模态数据路线。
图解主要方法
怎样降低音视频推理后训练成本,同时避免把推理提高误当感知没有损伤?
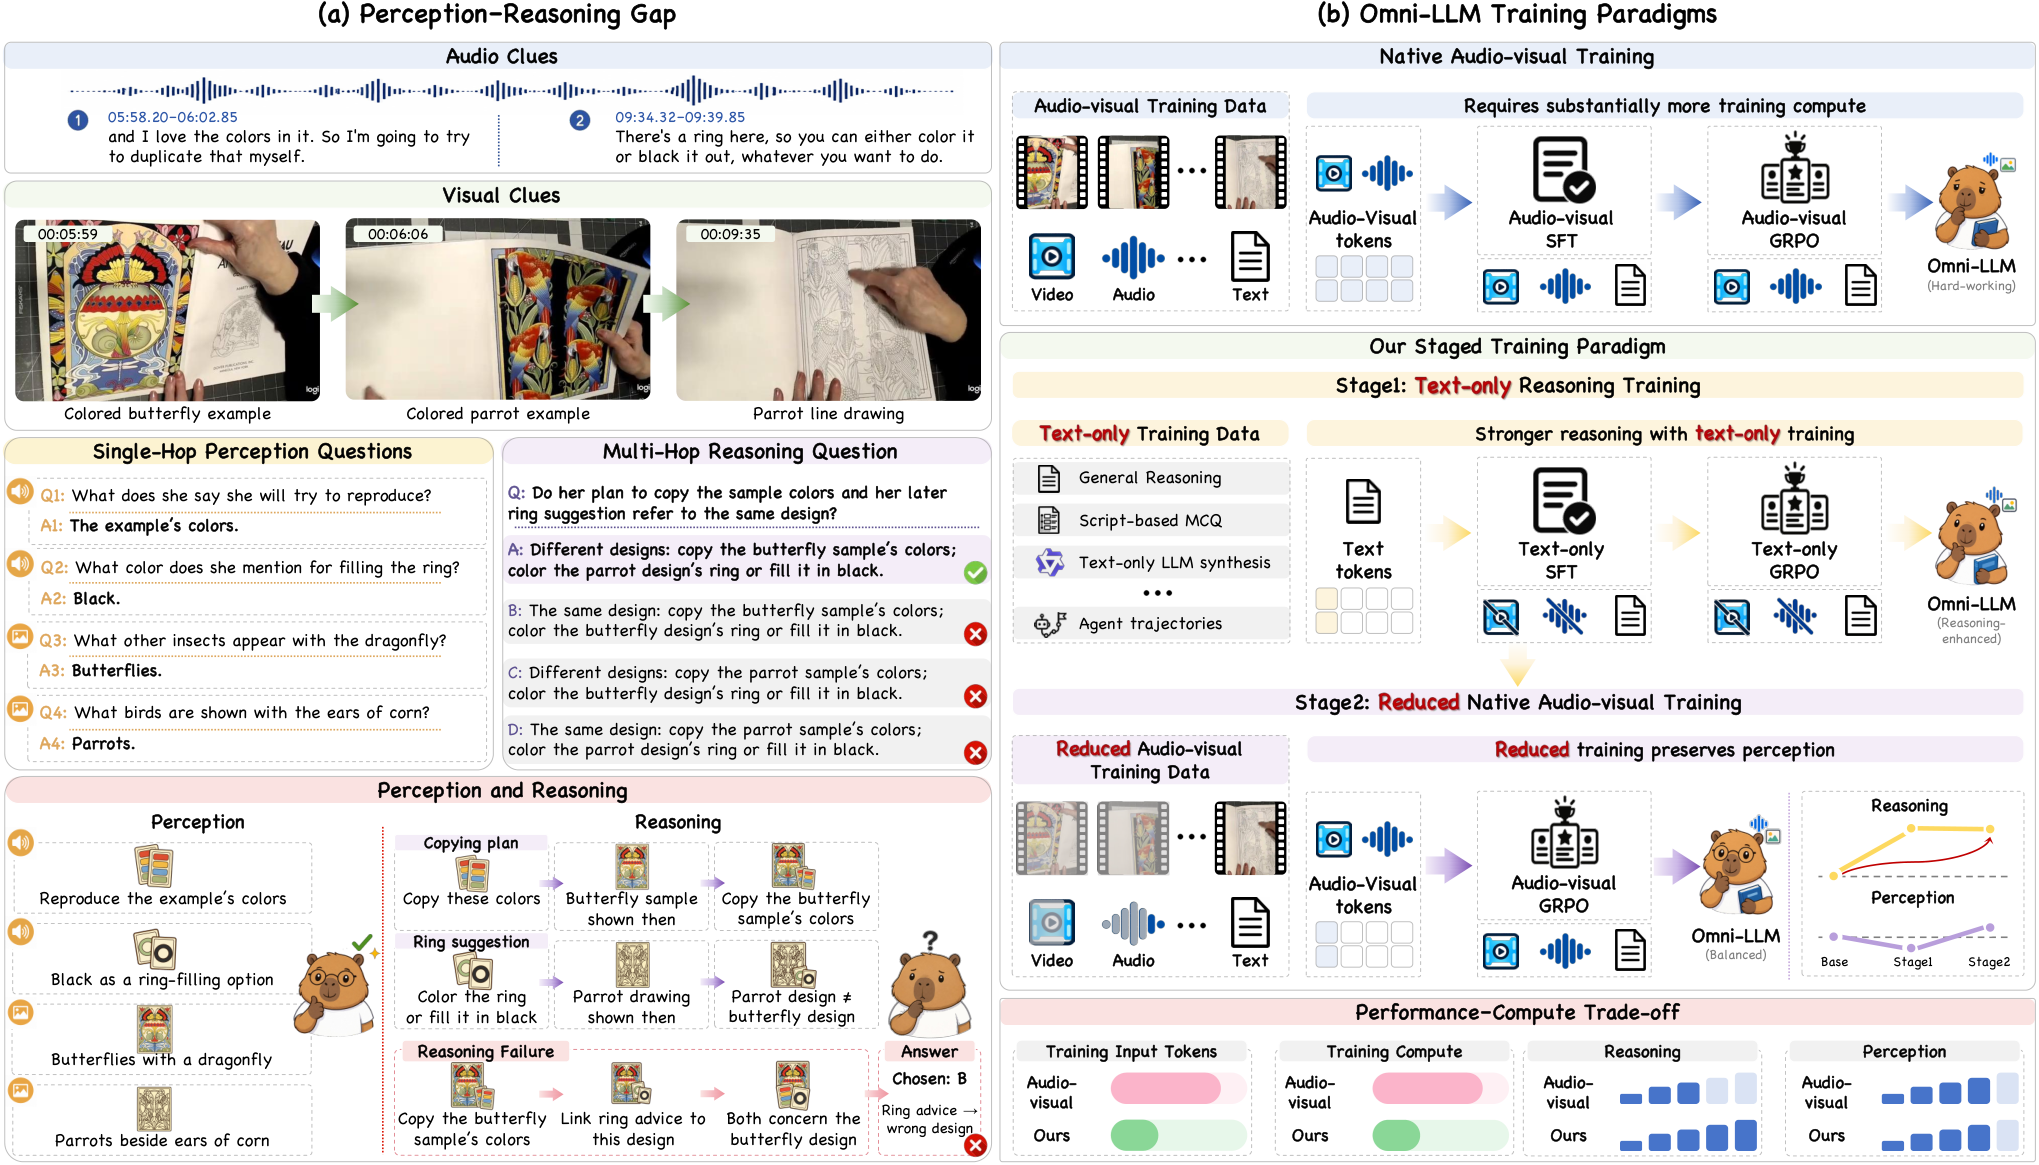
- 1
诊断单跳与多跳差距
FineVideo约4000单跳题由九模型评估,仅全答对事实构造约5000二/三跳题;按视频做五折,梯度在训练折构建,留出折看损失变化。
- 2
局部投影区分目标方向
只更新Thinker解码层及最终归一化,投影去掉另一平均损失梯度分量,固定相同参数步长。留出损失仍可变化,结论限于初始点附近的部分可分性。
- 3
文本SFT接GRPO增强推理
冻结视听编码器和投影,仅语言解码LoRA rank16/alpha32。SFT学推理格式,GRPO每题8生成,答案准确奖励加0.1格式奖励,主方案用脚本选择题。
- 4
单独构造全合成文本对照
文本LLM从抽象场景规划人物与状态,扩写可见事实并分离声音,再出唯一答案、合理干扰项和依据;程序检查时间/格式,模型审核和部分人工审阅,无需真的生成视频。
- 5
以少量音视频RL恢复感知
文本完整训练后追加减少数据的原生GRPO,仍输入音频及1FPS视频最多180帧;恢复感知时推理略降,最终按两组能力而非单分数比较。
实验与证据
全文及附录A–E全部实验、梯度分析、提示原图和四个案例读完;图1视觉核验,首发与许可实际查看。
来源证据原1跳宏均94.7%,由正确事实构成的2跳64.1%、3跳62.3%;投影推理更新保留81.7%目标损失降幅,感知降幅仅0.06%。 图2;附录A ↗
我的解读支持诊断差距和局部目标可分,不证明内部模块完全独立或训练全程无干扰。
来源证据Qwen2.5Omni7B文本SFT+GRPO推理均值39.80→49.39,九项比值几何均值增益25.83%;原生完整路线47.37。 表2 ↗
我的解读几何均值增益不是准确率增加25.83个百分点;异构九分数含SocialOmni子项。
来源证据文本完整路线284.17GPU小时、0.505B输入token;原生654.52小时、1.306B,分别少56.6%与61.3%。 表2;附录B ↗
我的解读同8张A100计时含GRPO在线生成和优化,但输入token计数不含GRPO生成输出,亦未计数据合成服务成本。
来源证据全合成文本路线7B推理均值47.50,较39.80+7.70,几何增益21.01%。 图4 ↗
我的解读比最佳脚本路线低1.89分,应明确不是25.83%那一配置。
来源证据纯文本感知宏均77.37→76.41;加小量原生GRPO后78.50,推理49.39→48.48。 表5–6;附录B.2 ↗
我的解读感知宏均实际取五项,AVHBench两子分不重复计;感知回到基座上方但低于原生完整路线79.07。
来源证据最后原生GRPO0.122B输入token、82.7GPU小时,对完整原生GRPO1.214B/642.3小时;推理几何增益24.15/25.83=93.5%。 表6 ↗
我的解读93.5%保留是增益比值,不是保留93.5%原始能力;最终流程仍需约284.17+82.7GPU小时。
来源证据另以16000工具轨迹SFT、8000RL训练,OmniGAIA总体3.6→13.1,原生OmniDPO13.3。 附录C.2 ↗
我的解读是另一套智能体实验,难题仍6.4且RL较SFT7.7下降,不能称所有难度同步提升。
开放情况与使用许可
论文公开训练超参与提示;文中GitHub/HF链接主要指基础数据和既有工作,未核实本工作官方代码、适配权重及全部新合成数据发布。
LICENSE论文为arXiv非独占许可,图1仅必要方法评论署名引用;基础模型、训练数据及合成生成服务条款分别适用。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
相同基座、同一主GRPO问题、同硬件计时,文本与音视频路线有可比性。
不仅报推理提升,也报告感知退化及恢复的代价;全合成文本另有独立结果。
反方 · 哪些结论还不够
诊断多跳问题来自所有模型已答对的单跳交集,回答分别调用,不能推出内部感知表征恒定。
默认脚本训练仍来自真实音视频注释;只有RQ3全合成实验在构建和训练都不用音视频。
90%节省是最后原生GRPO阶段的输入token,56.6%是纯文本完整路线GPU小时,不能混称最终全流程节省90%。
综合判断
文本后训练能够迁移到音视频推理,而少量原生训练可修复感知,这是可用的训练设计;证据不支持感知与推理彻底解耦或去掉所有多模态监督。
我会先做的验证
建议实验(尚未执行):独立验证集选数据与训练顺序,多种子报告区间;全流程计合成、裁判、输出token与GPU开销,检测感知长尾、听觉细节和跨时间错配,并与等总预算联合训练比较。