THAW:把世界模型特征蒸馏进 0.8B 机器人策略
教师离线缓存,部署图不变;收益不等于免费获得物理推理
THAW 用冻结世界模型的中间视觉特征监督紧凑 VLA,训练后丢弃投影器,部署无需运行教师。相同学生的对照显示仿真和小规模真机收益,但缓存、训练成本仍存在,较难操作中的改善也没有消除接触失败。
图解主要方法
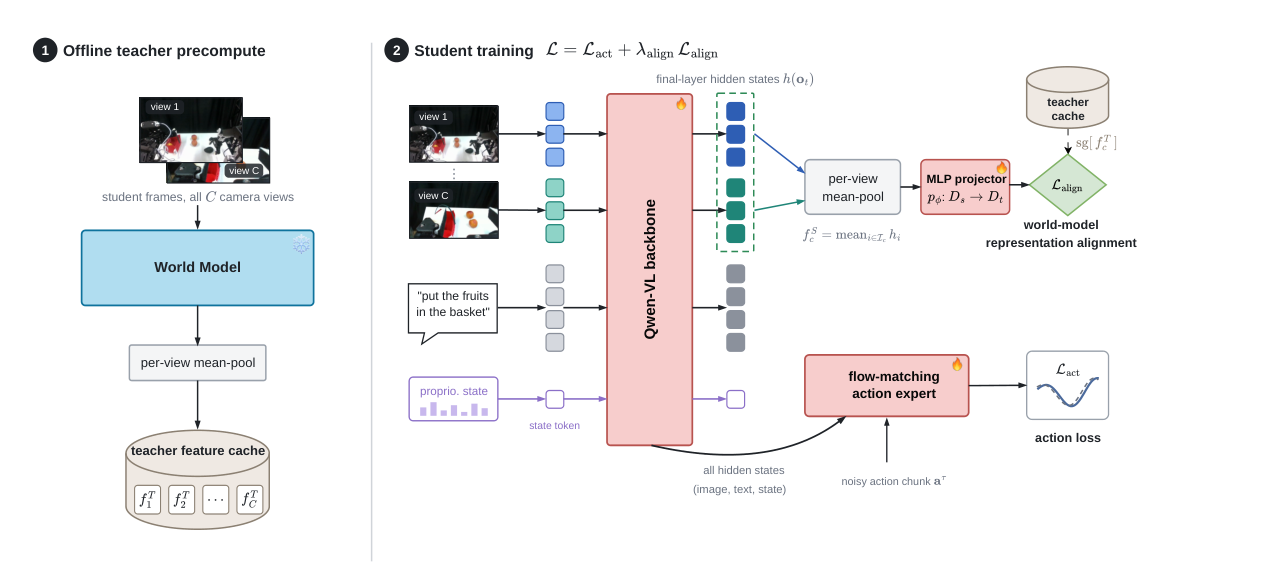
图 2 中哪个部分只在离线出现,学生究竟对齐了什么?
- 1
固定学生,先建立相同容量的行为克隆基线
学生将 Qwen3.5-0.8B 视觉语言骨干与 GR00T 风格流匹配动作头组合,输入相机图像、任务及状态。基线与蒸馏学生部署结构相同,从而避免把多加推理模块造成的收益误认成蒸馏效果。
- 2
图 2 左:一次性提取教师视觉特征
主教师是 Cosmos3-Nano 的理解塔,取 Qwen3-VL-8B Reasoner 第 24 层图像 token,按相机均值池化为 4096 维;双相机分别缓存。整个多塔模型约 16B,但学生没有在线生成未来视频。理解塔的有用特征也不自动证明教师已提供因果物理知识。
- 3
图 2 右:在动作损失上加余弦对齐
学生每视角池化视觉 token,通过两层 MLP 投影到教师维度,以权重 0.5 的余弦损失对齐缓存,和原动作训练共同更新。目标是方向一致的表征,不能把它说成直接监督每一步未来状态或复制教师轨迹。
- 4
部署时删去投影器和教师
学生仍执行一次骨干预填充与四步动作流采样。无需增加在线网络是明确优势;离线 LIBERO 缓存仍报告需要约四卡一小时,训练使用四张 A100 80GB,不能把“推理零额外成本”写成整个训练免费。
- 5
把任务难度和统计单位分开
LIBERO 四套任务每套十任务、每任务 50 次;论文均值跨两个评估种子和两个 GPU 执行配置,不等于四次独立训练。RoboCasa-GR1 为 124 任务,真实单臂和双臂各设置只有 30 次试验,接触、滑移和双臂协同仍是瓶颈。
实验与证据
以下为作者报告;已阅读 v1 全文及附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【表 I】相同 0.8B 学生在 LIBERO 从 95.3±0.7% 到 97.9±0.5%。 表 I,评估设置 ↗
我的解读支持该配方在此基准的收益;高成功率区间仍需独立训练种子与更强分布变化验证。
来源证据【表 II】RoboCasa-GR1 从 48.2±2.1% 到 50.5±2.3%。 表 II ↗
我的解读改变量相对波动较小,不能仅据均值断言所有任务显著提升。
来源证据【真机】水果单臂 25/30→28/30,鸡蛋 14/30→18/30,双臂 12/30→14/30。 真实机器人实验 ↗
我的解读不同精细程度的任务收益有差异;不能用水果成绩代替双臂或接触泛化。
来源证据【效率】RTX 5090 上 32ms、1.86GB;教师不参与在线决策。 推理成本实验 ↗
我的解读不同硬件上其他大模型的秒级结果不能直接除出可靠加速倍数,还应检查全系统感知与通信延迟。
开放情况与使用许可
已打开作者项目、实际训练/推理目录和蒸馏 YAML。仓库声明 MIT,但 LICENSE 另含保留上游提交的附加文字;Hugging Face 已列出 final_model.pt,所查 0.8B LIBERO 条目没有 README 模型卡或明确权重许可。未下载执行权重。
LICENSE代码有 MIT 标题及附加文字,须阅读原许可证;论文非独占分发;权重许可未明确,不能将代码条款自动扩展至权重。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
缓存教师、训练对齐、部署删去的路径清楚,且相同学生对照使新增计算的归因较容易检查。
反方 · 哪些结论还不够
主教师实际使用理解塔;小样本真机、评估种子口径和训练成本限制了“继承物理推理且零成本”的宣传。
综合判断
适合研究紧凑机器人策略的训练增强;先核查目标任务上的接触失败与统计稳定性,再决定是否增加教师缓存管线。
我会先做的验证
未执行的验证方案:固定示范、学生初始化及训练预算,跑多个独立训练种子;与普通 VLM 教师和打乱缓存对照,加入新物体、遮挡、摩擦变化,统计所有试验的成功率与端到端延迟。