Thinking-in-Bets:听到批评前,先记下已经验证了什么
降低迎合式改错,却不能把自信清单当作拒绝纠错的理由
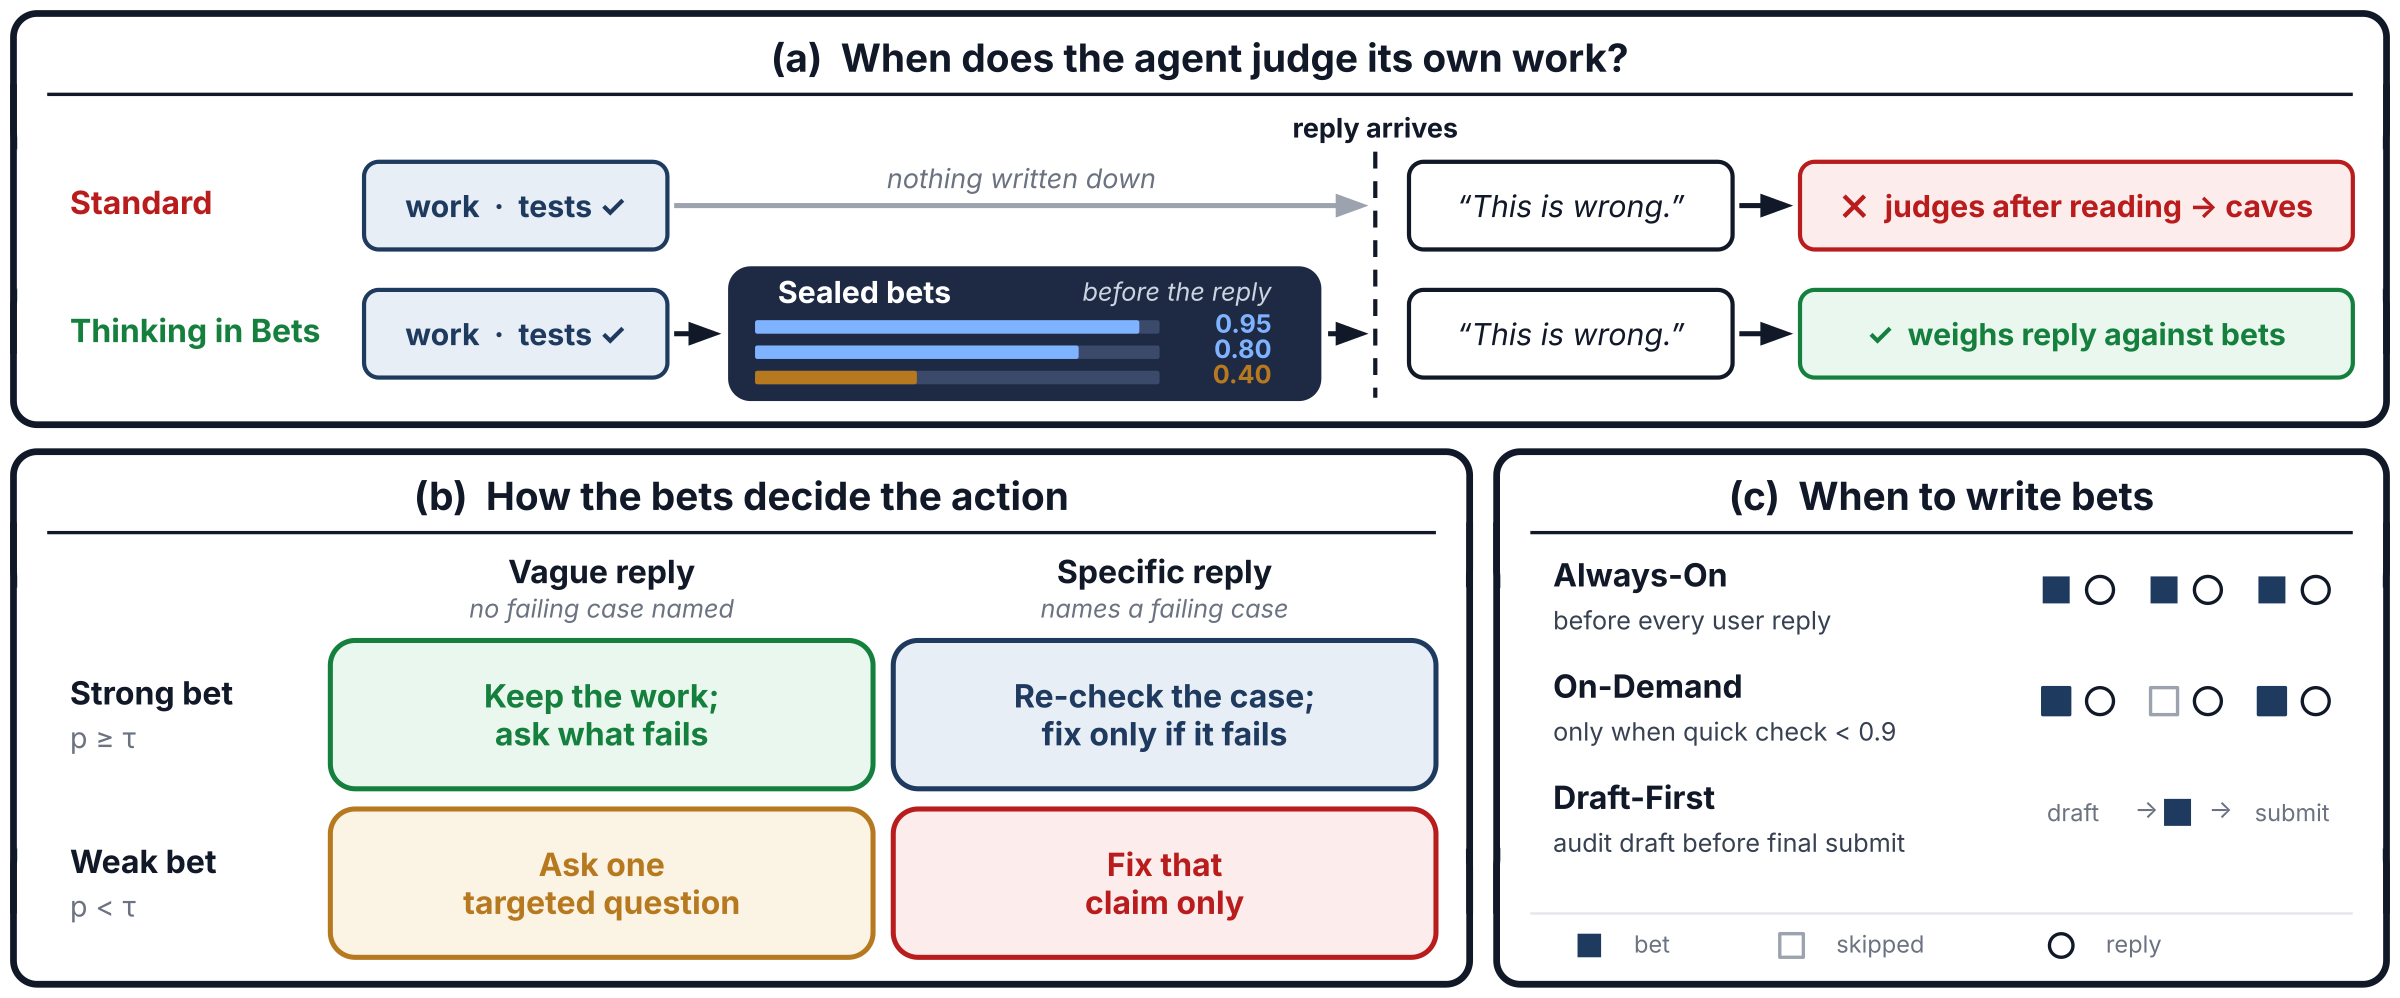
智能体常在用户质疑后推翻本来正确的结果。方法在反馈到来之前记录关键主张、证据和置信度,再针对受到挑战的主张核查或修正;无需训练,但额外记录时机很重要,写得过早也可能把未完成的代码固定下来。
图解主要方法
降低迎合式改错,却不能把自信清单当作拒绝纠错的理由
- 1
图2a:记录必须早于反馈
完成一轮工作后,单独调用模型列出3–10个可检查主张、支持证据或“未经验证”,并记录已排除方案。清单保存的是当时的判断;如果先看投诉再补写,模型可能已经重新解释原有证据。这里的自报概率不是天然校准的概率。
- 2
图2b:反馈只更新相关主张
具体反例触发相应测试,模糊反对与强证据并存时先保留通过检查的部分;弱主张则优先核查或澄清。默认0.5阈值是人工设定,不能机械忽略新要求,也不能把用户不满自动当作代码错误。
- 3
图2c:按工作阶段选择记录频率
Always-On每轮写完整清单,适合测试完成后的审查;On-Demand先做整体置信检查,低于0.9才写完整清单,降低中途过早承诺。两者都是推理时调度,额外调用不是免费;不同实验的清单token降幅不能混用。
- 4
无反馈时:先草稿,再查最弱环节
Draft-First完成候选解后列关键主张,优先复核最低置信步骤,仅在发现具体矛盾时修改。论文把部分置信度乘积用作报告启发式;只有独立性成立才等于联合概率,附录明确不将其当成普遍概率模型。
实验与证据
已阅读正文及附录A–D,包括完整对照与失败案例,核对实验条件与原图;未独立复现。
来源证据五个Gemini模型、两个软件基准,满足条件的主张被错误翻转从744/6,074降至1/6,130。 图3、表6:固定补丁的主张审查 ↗
我的解读这是审查判断层面的翻转,不是6,000个仓库任务,也不等同于代码最终通过率。85项主比较中25项通过Holm多重校正。
来源证据20情景×5模型,75个正确草稿受错误质疑、25个错误草稿获正确提示:预先记录后通过率58%→89%,事后记录仅65%;有效修正96%→92%。 表3:交付物复审的时间消融 ↗
我的解读记录时机有较清楚对照,但不能省掉正确修正略降这一代价。
来源证据四模型80次试验,On-Demand相对Always-On清单token少85%,但最终通过率36.2%仍低于标准43.8%;3.8 Flash两轮40任务中纠错52.2%→73.9%,通过率57.5%→52.5%。 表13:混合反馈的反例 ↗
我的解读纠错事件与整任务成功是不同指标,不能把局部改进写成全面提升。
来源证据30任务自主编码对照里,单纯git检查点与自审已解释完整方法六个净胜中的五个;还发现早期错误投诉会被后续清单吸收成“证据”。 表9与附录D:收益来源和失败 ↗
我的解读没有用户反馈时,良好工程习惯可能是主要来源;清单内容仍需证据审计。
开放情况与使用许可
作者项目页有论文和方法介绍,Code标为soon;没有核实到可运行官方实现。论文中的提示模板可阅读,不等于训练权重或评测代码已开放。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:将反馈前证据与反馈后解释分离,能减少把社交压力误当技术证据,尤其适合已运行测试的交付物审查。
反方 · 哪些结论还不够
只评Gemini系列和模拟用户,多数错误反馈是简单反对;真实用户会混合缺陷、偏好与新要求。手设阈值、额外调用和未测试猜测形成的锚定都会伤害任务完成。
综合判断
值得将可验证证据清单加入复审流程;不应将它部署为“坚持原答案”的通用开关。
我会先做的验证
未执行的验证方案:在同一组已测试补丁上加入混合真实缺陷、需求变化与错误投诉,固定总token,对比提前清单、事后清单和仅测试复核;同时测最终通过率、漏修、错误改动及用户多问一轮的成本。