TierKV:用分层 KV 缓存换取手机长上下文
预测、低秩与闪存协同的收益,必须和解码减速一起看
TierKV 在解码前预测缓存需求,把上下文分到内存精确、低秩和闪存三层,再用融合注意力与 I/O 调度降低额外开销。它扩展了可运行的上下文,但论文数据不支持“所有阶段都更快”或“精度几乎不变”的笼统结论。
图解主要方法
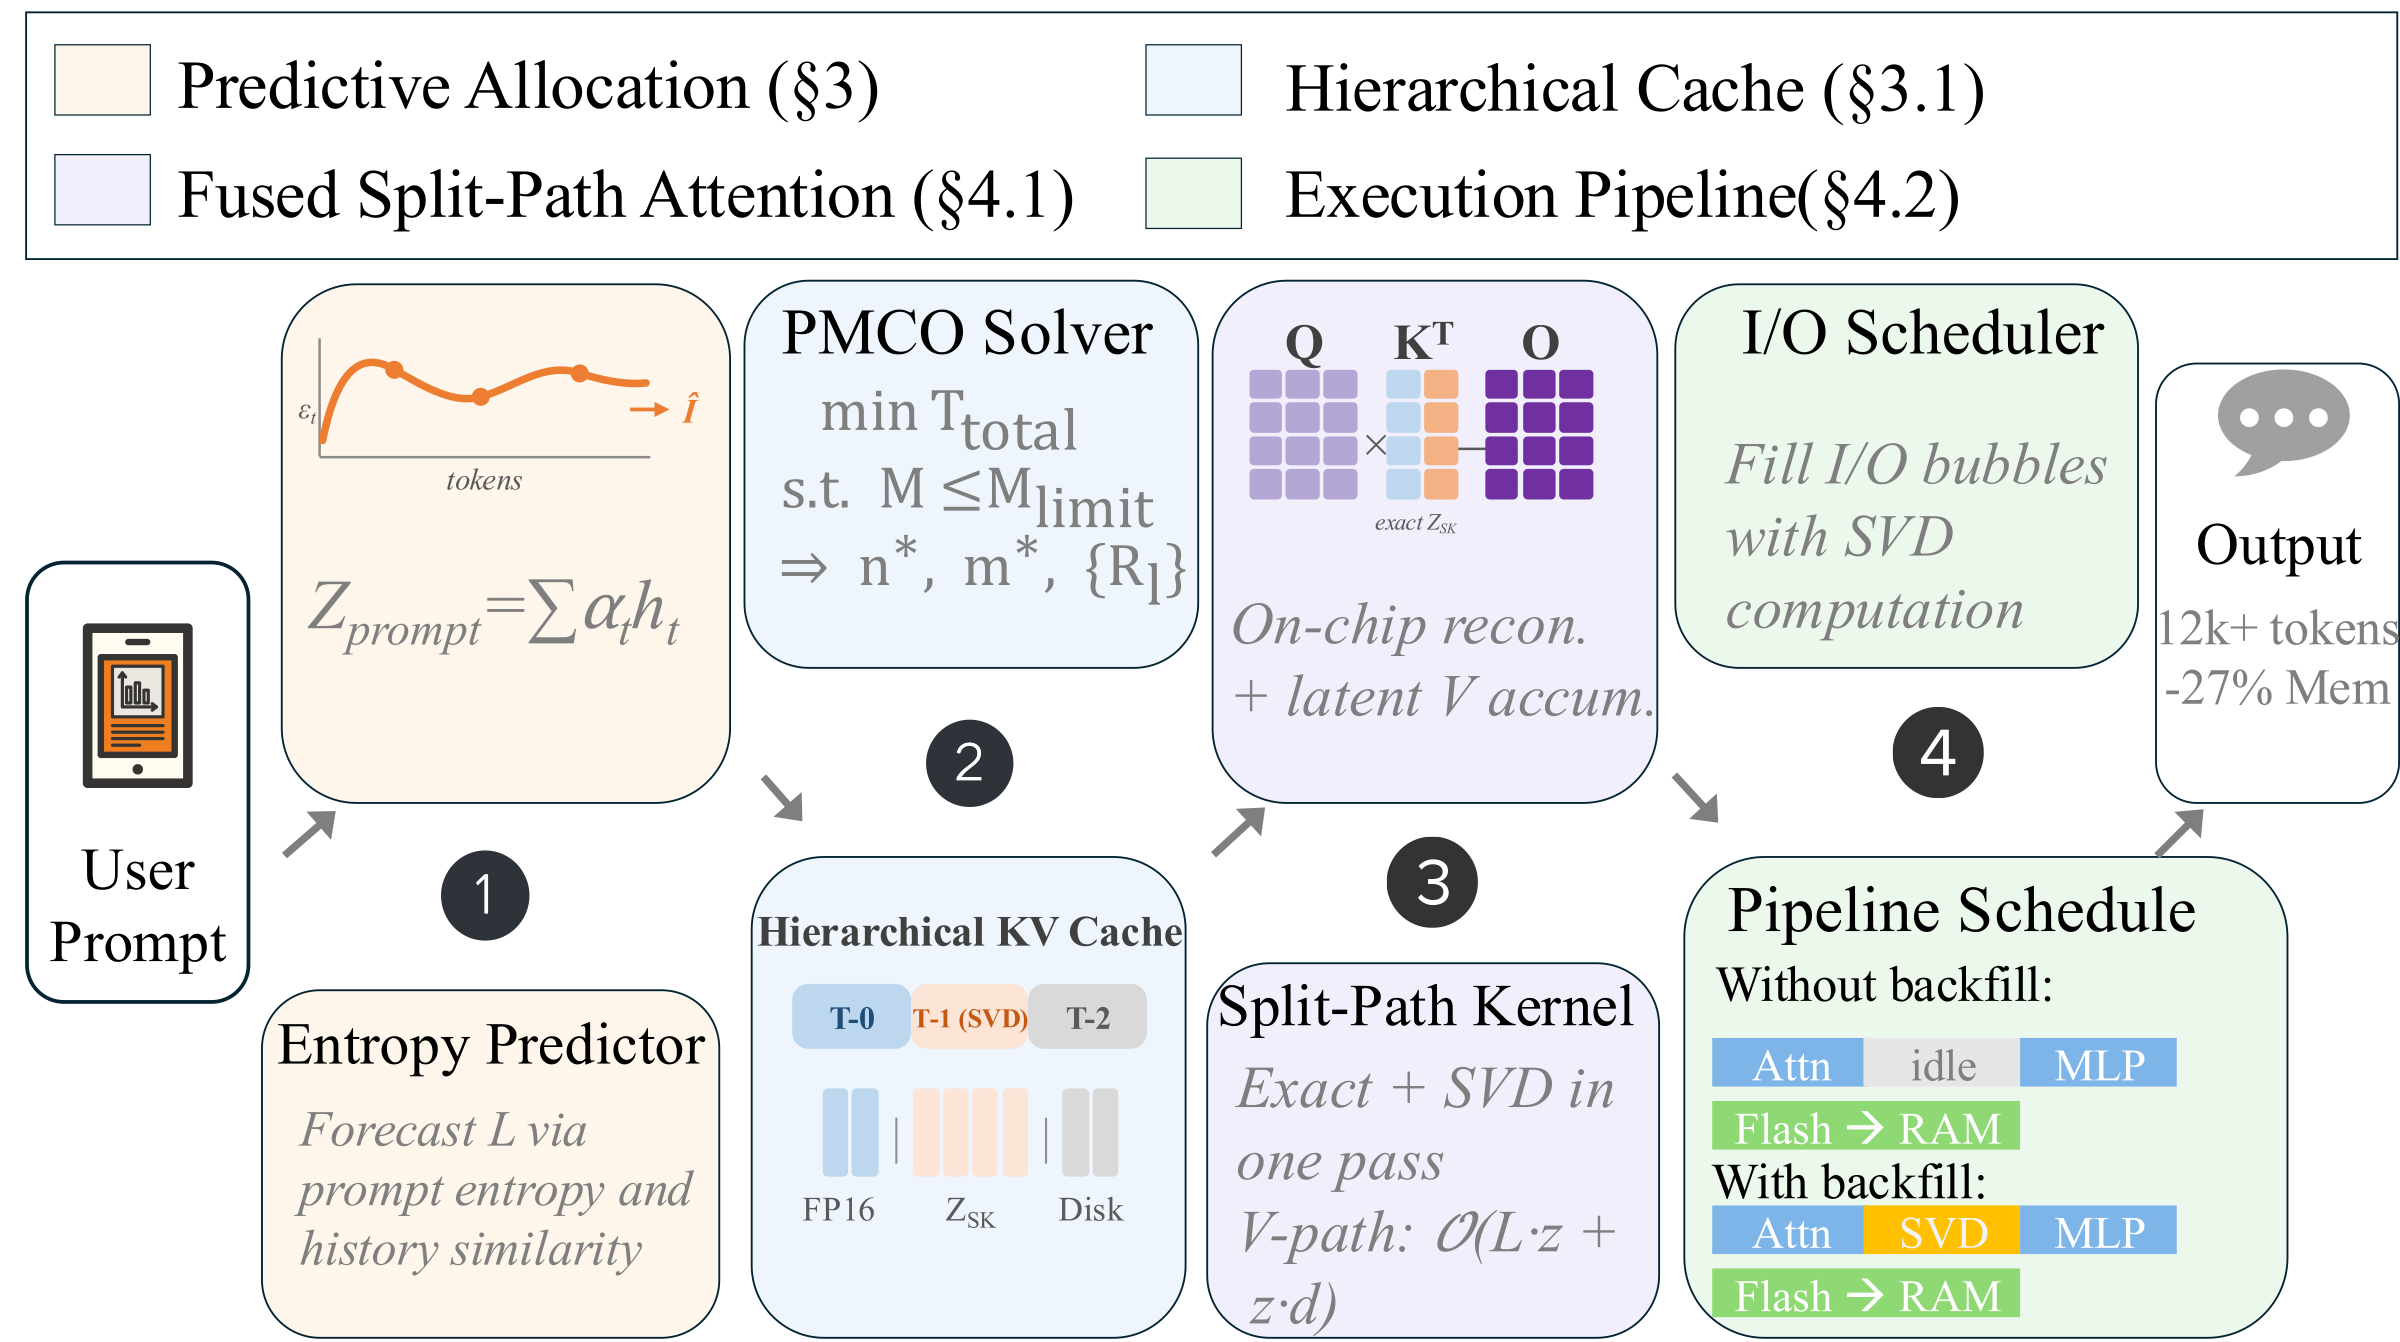
图 1 的四个模块怎样共同决定“能装下”与“跑得快”?
- 1
图 1①:先估算这次请求会产生多少缓存
预填充已有的隐藏状态按熵加权形成提示表示,再查询本地历史请求的近邻来预测长度,无需另训长度预测器。每层 SVD 的秩、保真度和运行成本事先标定;预测器无需训练不等于整套系统无需离线标定。低估长度时,超出部分走全秩闪存,代价转为额外读写。
- 2
图 1②:联合选边界和秩,而非等内存满了再驱逐
PMCO 把早段 token 保持精确,中段用 SVD 表示,后段完整卸载到闪存;联合选择两条边界 n、m 与逐层秩。对离散候选秩使用近似的时延、内存和保真度约束求解,请求级配置开销报告小于 0.1 秒。所有 token 仍可访问,但低秩部分的表示已经近似,不能等同无损。
- 3
图 1③:在注意力内部消化压缩表示
精确键值与低秩键值走不同计算路径,再由在线 softmax 合并。压缩键在片上重建,不把完整重建结果写回主存;值先在低维空间累加,再做一次投影。收益来自减少中间张量和内存流量,不是取消了重建计算。
- 4
图 1④:用重建计算填补闪存等待
调度器把按层读入与重建交叠。移动 GPU 的传输能力限制了可隐藏的时间;如果设备本来算得快、存储却慢,卸载仍可能成为瓶颈。图中示意的输出长度和内存降幅不是八个模型的统一结果。
- 5
把容量、首轮处理和逐 token 解码分别验收
论文以单批次移动端推理为主,在 OnePlus 12 约 6.8GB 稳定应用预算下比较八个文本、视觉和音频模型;另测 OnePlus 11 与 Pixel 8,后者含 CPU 回退。最大上下文还受至少 1 token/s 与训练位置上限约束,不能只按没有内存溢出来认定任务可用。
实验与证据
以下实验均为作者报告,本站已阅读论文正文及可用附录,未独立运行研究实验。实验条件、观察结果与编辑解读逐项分列。
来源证据【表 7】对 llama.cpp,平均预填充吞吐为 1.34 倍、解码吞吐为 0.71 倍,端到端为 1.10 倍。摘要的最高 17.6 倍来自对 MNN 的预填充比较。 §5,表 7 ↗
我的解读我的解读:收益高度依赖阶段和基线。长输出的交互任务可能放大解码损失,不能把预填充加速写成整段生成加速。
来源证据【内存与容量实验】RAM 中 KV 占用减少 12.5%–34%;Llama-3.2-1B 的可支持上下文从 32K 到 72K。 §5,容量实验 ↗
我的解读这里减少的是驻留 KV,不是总内存或权重大小;保持 token 可访问,也不证明任意长距离推理保持原质量。
来源证据【表 8】Qwen2.5-3B 的 MMLU、ARC、GSM 指标分别下降约 7.0、6.6、7.0 个百分点;Llama-3.2-3B 降幅较小。 §5,表 8 ↗
我的解读压缩误差明显依赖模型。45 次受控事实检索测试中的召回保持,只能补充说明,不能抵消更广泛任务中的退化。
开放情况与使用许可
已核实完整论文和作者主页中的该工作;未核实作者正式实现。搜索出现的其他同名 TierKV 项目不能视作本论文代码。
LICENSE论文 CC BY 4.0;未确认对应软件许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
不驱逐 token,避免检索证据被永久删除;逐层秩与设备预算联合考虑,比固定压缩比更贴近部署。
反方 · 哪些结论还不够
表 7 与表 8 显示时延、容量、准确率存在实质权衡,统一“更快且几乎无损”的宣传会误导选型。
综合判断
有价值的端侧容量方案,但应以完整请求和任务质量验收。
我会先做的验证
未执行的验证方案:固定同一模型、精度、手机和温度,交叉测试短输入长输出与长输入短输出;记录 p50/p95 首 token、完成时间、峰值内存、能耗与长文事实召回,加入长度预测失准和后台内存压力。