TokenGate:让模型学会跳读,而不只压缩 KV 缓存
先全读浅层,再让深层只计算被门控保留的上下文
长上下文的成本不仅来自保存 KV,也来自每层都计算每个输入 token。TokenGate 在模型早期插入可学习门控:先让浅层读完整上下文,再选出 K 个位置供深层处理。门控分数同时进入注意力,使选择模块可随 LoRA 一起训练。论文在小模型、任务定制微调与单请求设置下展示首 token 延迟和显存的改善;这不是对任意模型无需训练的压缩插件。
图解主要方法
先全读浅层,再让深层只计算被门控保留的上下文
- 1
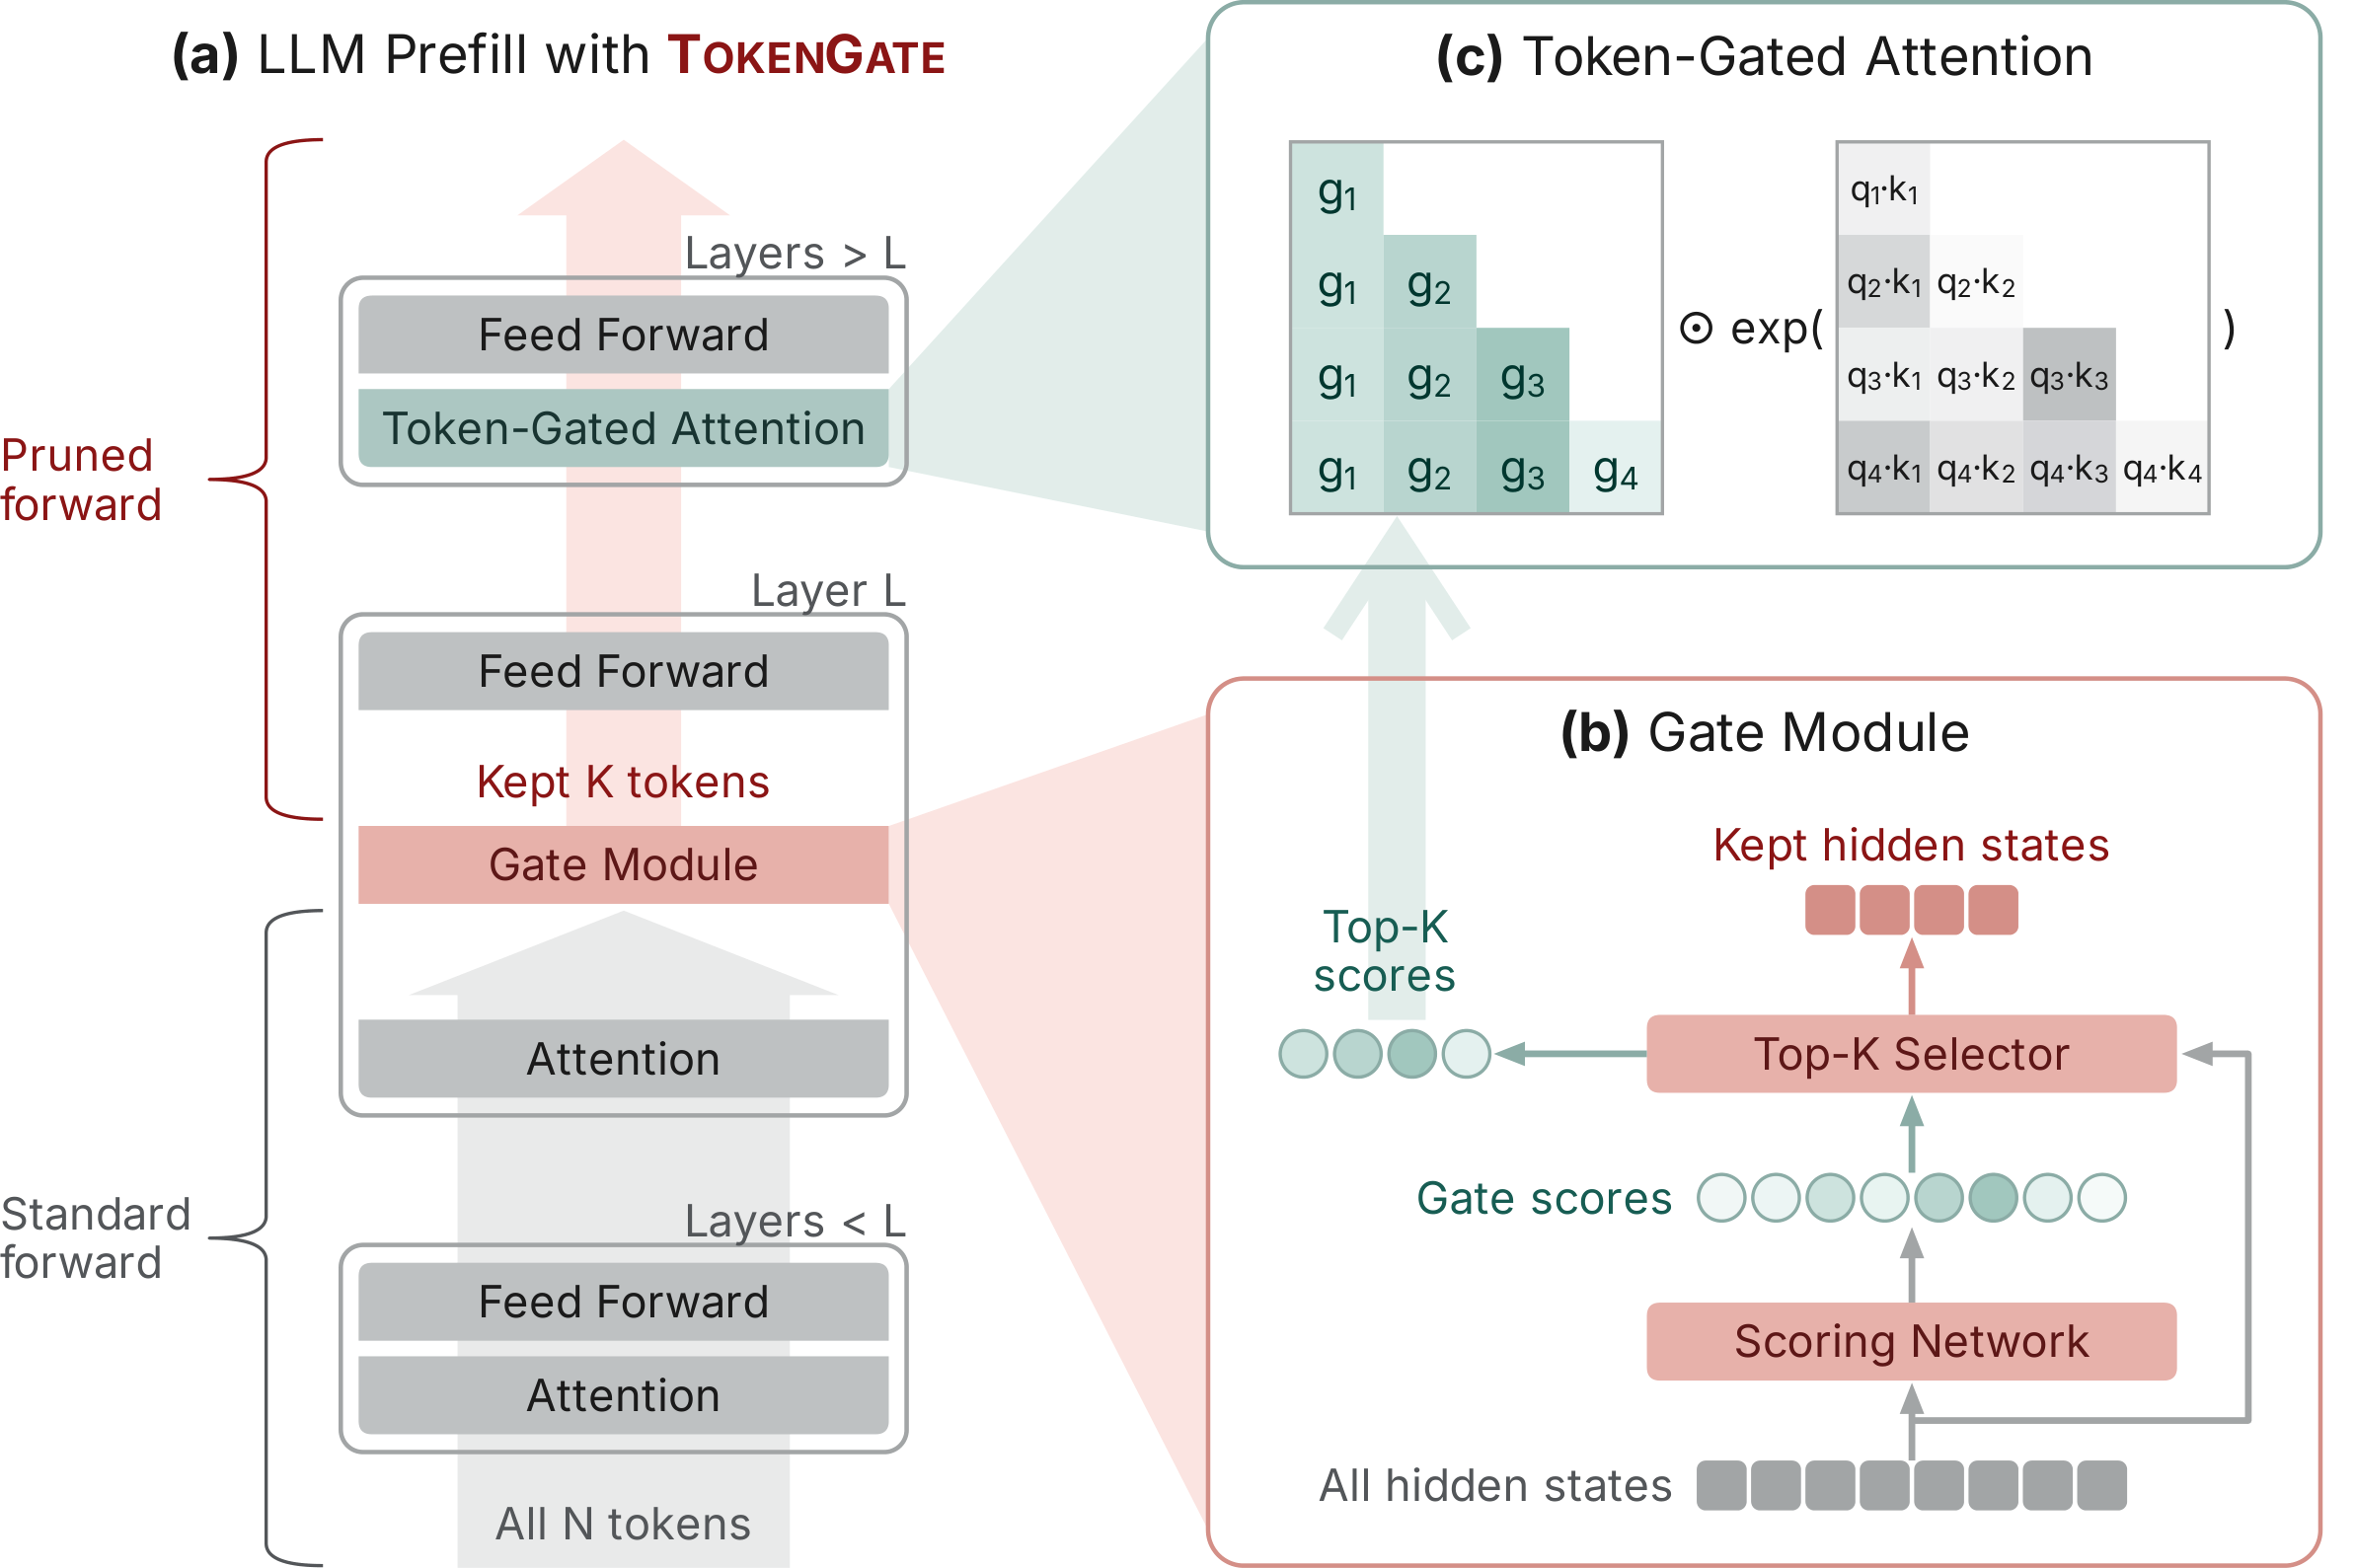
图1(a)(b):浅层先看全局,再选择位置
第 L 层之前处理全部 N 个上下文 token;小型评分网络读取隐状态,经归一化后选取 top-K,保留原位置编码。问题、指令和生成答案不参与删减。深层只为保留位置计算并存储 KV,而浅层在主要实验中仍保留完整缓存。
- 2
图1(c):给离散选择提供训练信号
top-K 本身不可微,因此作者将门控分数作为后续注意力的 key bias,使语言建模损失能改变分数。每个头的正增益与按保留长度调整的温度控制注意力锐度。它训练的是哪些信息值得继续计算,而不是固定按最近位置或注意力统计剪枝。
- 3
同一次训练兼顾完整与稀疏上下文
冻结骨干,联合训练门控和 rank-16、alpha-32 的 q/v LoRA。完整上下文损失与随机预算的稀疏损失取平均,共享门控前的计算;完整分支防止模型只适应极端压缩。随机采样 K 让一个检查点支持多种推理预算。
- 4
混合架构也要区分两类状态
在 Qwen3.5-2B 中,门控可位于线性注意力层之后;上层递归混合器只处理保留位置,但下层已经读入全部 token 的递归状态无法像普通 KV 一样删除。论文扩展因此不是所有层都按相同比例省内存。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据Qwen3-1.7B 上逐任务训练;推理使用单张 A100、bf16、batch=1、贪心解码。任务包括 RepoBench-P、2WikiMultihopQA、MultiNews、BioDEX 与合成 NIAH;不同任务用编辑相似度、F1、ROUGE-L或精确匹配。报告匹配任务精度时 TTFT 改善1.4–11.3倍、峰值显存改善1.5–3.4倍。 主文第5节与图3、附录实验设置 ↗
我的解读范围是跨任务的最好/最坏结果,不能将11.3倍当作通用部署速度,更不能替代完整生成吞吐量;比较基准包含任务微调,收益不是与未微调模型直接等价。
来源证据图1中2Wiki的3倍提速、2.7倍显存改善对应保留95%的完整上下文精度;混合模型更早门控可达7.8倍,但允许约6%的精度差。128k扩展约13倍来自NIAH。 图1(d)、图4与长上下文扩展 ↗
我的解读几个醒目数字对应不同条件,均不应写成所有真实长文任务无损13倍。
来源证据单训练步约慢1.3倍;总耗时平均2.2→1.8小时,但2Wiki为3.8→4.0、MultiNews为1.3→1.8小时。可视化使用事后选择的预算和高密度片段,MultiNews仍有实体错误,BioDEX样例只识别两种反应之一。 训练开销表与附录E定性样例 ↗
我的解读平均训练更快不能掩盖个别任务变慢;保留位置热图不是解释忠实性或关键信息完整性的证明。
开放情况与使用许可
2026-10-21核验:GitHub含 tokengate、kernels、train-scripts 与 benchmarks 实现,递归目录未见LICENSE文件。Hugging Face 的 liana313/tokengate-niah-qwen3-1.7b 模型元数据标Apache-2.0,确有gate与LoRA检查点;此许可声明仅按该模型卡范围记录,不外推为全部仓库代码获同样授权。
LICENSECC BY 4.0(论文及所引原图);实现许可另行核对
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
值得关注的是把上下文长度变成可学习的条件计算维度,并以完整分支和随机稀疏预算共同训练;它比只在解码阶段压缩缓存更直接触及预填充成本。
反方 · 哪些结论还不够
证据集中于1.7B/2B模型、逐任务适配、单请求硬件条件;稀有事实、跨段组合和分布外文档可能被删掉。训练成本并非每项都下降,模型卡许可也不能代替仓库代码许可证。
综合判断
是有机制和消融支持的长上下文效率方案,适合先在固定任务做预算曲线验证;尚不能推断为通用助手无损跳读。
我会先做的验证
未执行的验证方案:固定同一微调参考与数据划分,逐档测 K 的质量、TTFT、端到端延迟、批处理吞吐和显存;额外加入分散证据、否定条件、罕见实体及超训练长度输入,记录漏答而不只均分。