TokenRouter:逐token切换模型,瓶颈为什么在调度而不只在计算?
保留请求缓存状态,再让每个模型独立推进与等待成批
TokenRouter把路由策略抽象为route/send/receive,把执行拆成每模型子服务器。请求切走时标记pending保留状态,返回时追加未见token;延迟批调度通过短暂等待聚合同模型请求,用吞吐模型选择阈值。
图解主要方法
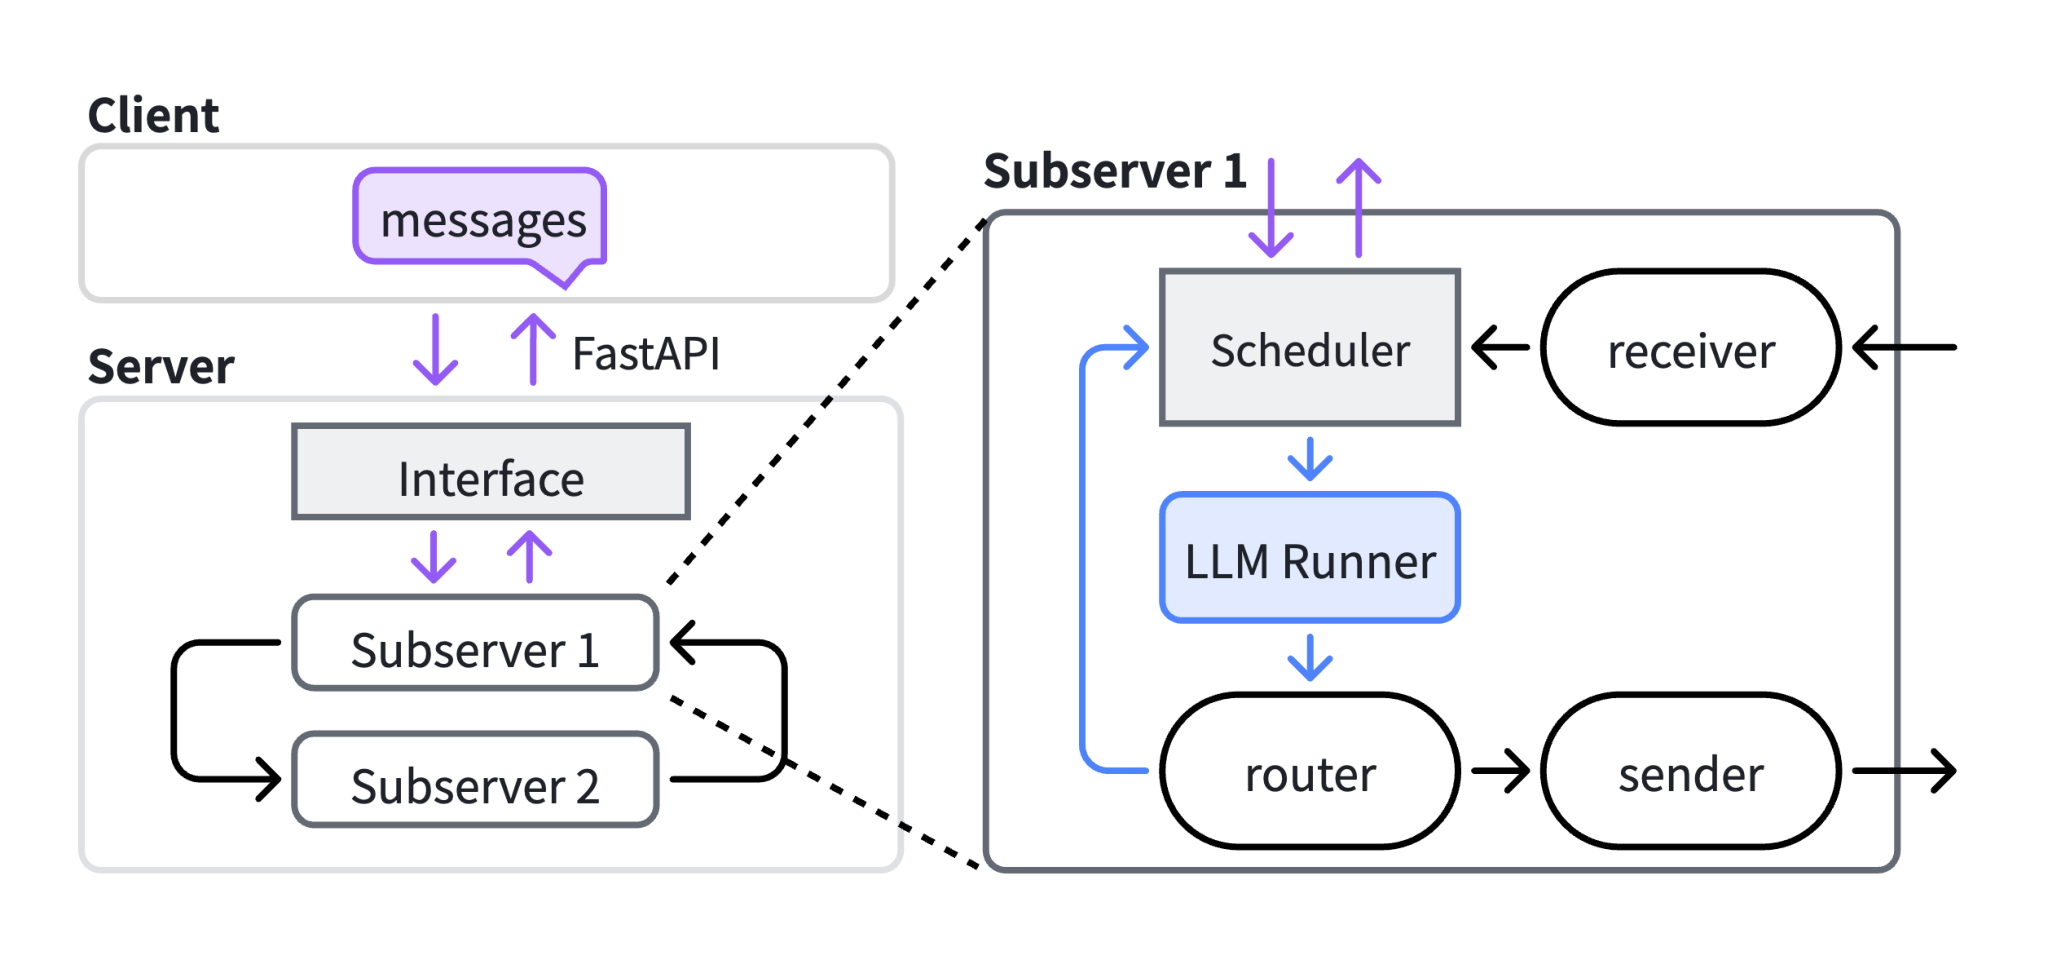
图2中的三条循环如何解除同步,为什么pending状态比多开模型服务更关键?
- 1
把每个请求写成三段接口
route在forward之后根据熵、预测分歧或ensemble权重决定去向;send带请求id和对端没见过的后缀及位置锚;receive决定提交哪些token。R-Stitch会去掉刚采样的不确定token,让大模型重生成。
- 2
沿图2分离三条事件循环
紫色连接客户端,蓝色负责本模型解码,黑色处理模型间消息。各子服务器独立KV池、scheduler与runner,慢模型工作时快模型继续推进其他请求,避免全批次等待最慢步。
- 3
切走后保留状态,返回不重建请求
pending状态让scheduler跳过暂离请求,但保留前缀与KV分配;返回后追加新token并恢复running。对extend路径捕获CUDA图、路由器放同进程,减少每token调用开销。
- 4
等待足够批量,但约束死锁与延迟
队列达到B才开批,用DTMC枚举等待数、运行批大小、剩余时长,求稳态提交token/时间最大值。阈值必须满足各模型(B−1)之和小于并发N;固定步时与几何停留分布是优化假设,不是任意负载定理。
实验与证据
已阅读v1完整正文及其公开附录、核对作者实验与必要原图;未独立复现实验。
来源证据主实验五算法×三负载、并发4,相对较强可用基线吞吐提升2.01–64.15倍;设备为A100-80G服务器。 §5.1–5.2 ↗
我的解读跨度反映基线与负载差异,不能称普通LLM推理普遍加速64倍。
来源证据并发8:CUDA等工程优化230.79 token/s,加异步296.86,再加延迟批372.48;官方R2R134.89。 表6 ↗
我的解读最终约2.76倍由多项共同产生,延迟批单项约1.25倍。
来源证据原算法设置Co-LLM并发4:TokenRouter76.02 token/s,LLM-only134.79;延迟11.46与13.39秒。 表2 ↗
我的解读路由系统相对原实现改善,仍可能吞吐不及单大模型;输出长度也影响吞吐与延迟关系。
开放情况与使用许可
官方仓库确有tokenrouter、配置、评估与示例代码;顶层未见明确LICENSE,当前仅标代码可见、许可待核。
LICENSE论文及图2 CC BY 4.0;未核实TokenRouter整体代码许可证,SGLang依赖许可不能自动覆盖新增实现。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
五种算法、三类负载以及原论文模型组合,另有缓存/CUDA图/异步/延迟批逐项消融。
反方 · 哪些结论还不够
标准基线是外部dispatcher逐token调用SGLang;相对该适配方式的收益不能等同任意单模型服务加速。部分官方实现没有连续批处理。
综合判断
有具体系统机制和实测支持;主要结论是降低细粒度切换开销,不是免费提升模型能力。
我会先做的验证
未执行的验证方案:同质量、同GPU和同到达轨迹对照新版服务引擎,记录吞吐、P50/P99延迟、缓存占用和切换率;再注入非平稳路由与低带宽网络。