ToolGrad:先跑通工具,再反推训练问题
回顾补收 v3:500 条数据的质量收益与扩展瓶颈
ToolGrad 从成功执行的 API 链反推用户问题,减少先写问题再找工具导致的失败样本。全文 v3 使用 ToolGrad-500,不能沿用旧摘要中的规模;“文本梯度”是流程选择的反馈,不是对工具进行数值求导。
图解主要方法
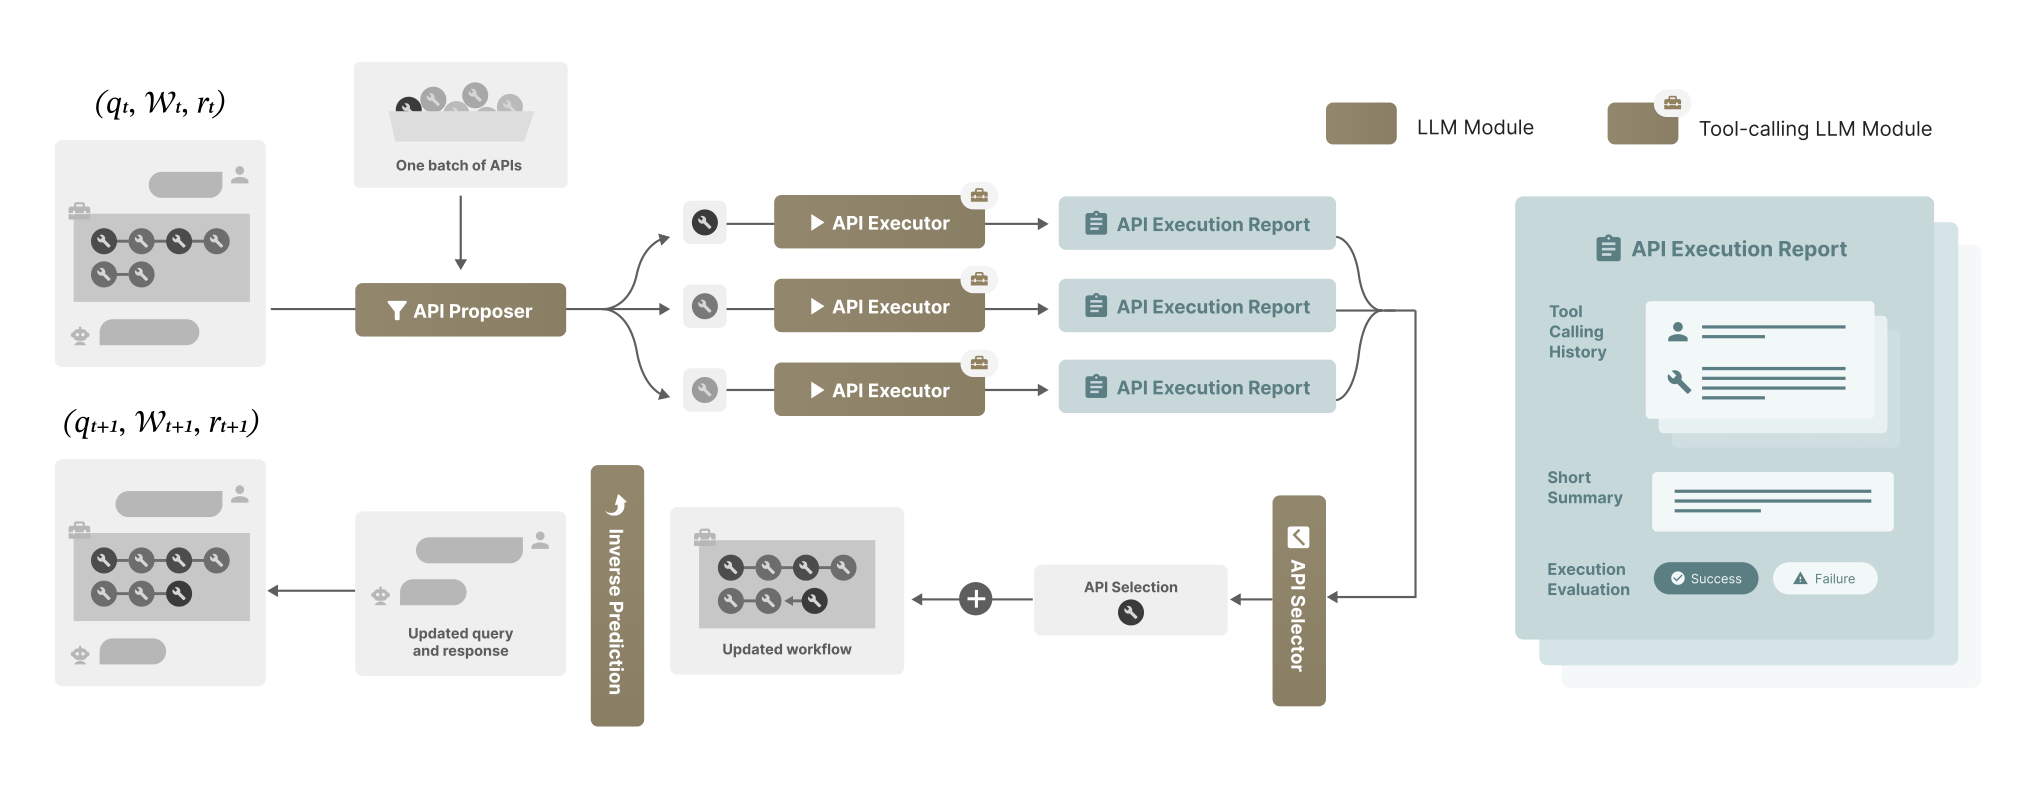
图 2 的四个模块怎样保证训练轨迹来自实际调用?
- 1
提出可执行的扩展
提议器读取当前工作流及一批 50 个 API,提出最多三个扩展。执行器分别实际调用并记录结果,10 秒超时或不可用响应会进入失败报告;选择器只考虑成功候选。先验证再写训练问题,降低不可执行链进入数据的概率。
- 2
用文本反馈选择下一条链
选择器判断候选能否扩展任务,并决定接到已有链还是新开独立链;更新器添加调用后重写问题与回答。这里的梯度指语言形式的方向建议,不计算模型参数导数,也不在每次扩展时微调学生。
- 3
把轨迹变成单轮工具预测
v3 以 Gemini-2.5-Flash-Lite 为主要生成器,500 个种子各迭代十轮。训练时学生一次输出所需调用,加入约 20% 无适用工具的负样本;候选池包含已知正确工具及检索到的干扰工具,因此没有端到端考察未知工具检索。
- 4
区分训练预算与推理方式
Gemma 3 的 1B 全参数训练,4B/12B 用 rank-64 LoRA,三轮、8K 窗口、只计算回答损失。BFCL 限 v1/v2 单轮;ReAct/DFS 与单轮输出的模板不同,解析失败会影响结果,不能据此推出开放式多轮智能体普遍领先。
- 5
检查数据规模的失效点
从 100 扩到 2000 条时,收益先增后降,作者归因于独立生成缺少共享记忆、重复使用相似工具。合成流程的高通过率并不自动保证语言多样性、真实用户分布或随规模持续提升。
实验与证据
以下为作者报告;已阅读 v3 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【表 2,v3】DFS 数据执行通过率 63.8%,ToolGrad 为 99.8%;平均工具调用量 34.3→20.0,LLM 调用量 64.5→63.9。 表 2 ↗
我的解读我的解读:大幅下降的是工具调用量,语言模型调用次数近乎不变;99.8% 不是部署后任务成功率。
来源证据【BFCL】相对对应 Gemma,1B/4B/12B 总分提升约 8.1/8.0/6.3 个百分点;12B 仍有平行调用子项下降。 表 4–6 ↗
我的解读我的解读:均值收益有用,但不同功能不齐头并进。
来源证据【附录 B】训练成本分别约 1/1.67/2.67 A100 GPU 小时;ToolBench 对照使用 H100。 附录 B ↗
我的解读我的解读:硬件和数据规模不同,GPU 小时不能直接解释为等条件总成本节约;生成 API 成本另算。
来源证据【人工核对】两位评委检查 8 问题、12 模型的回答,相关性约 0.88。 附录 D ↗
我的解读我的解读:小面板支持评委的一致趋势,不能替代广泛真实用户测试。
开放情况与使用许可
已检查正式仓库的生成模块、训练脚本、BFCL 评估入口及数据文件,并打开模块实现;代码许可证为 Apache-2.0。README 另提供 1B/4B/12B 模型入口,未下载执行模型。上游 Gemma、ToolBench 与 API 服务条款分别适用。
LICENSE代码 Apache-2.0;模型及上游制品按各自条款,论文许可见原图署名。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
先获取真实成功调用再生成问题,让工具数据的可执行性成为可检查的约束。
反方 · 哪些结论还不够
数据扩展出现平台期,单轮任务与已知正确工具池限制了“智能体能力自举”的外推。
综合判断
适合构建小规模高质量工具调用训练集;工程价值在有效样本率,后续仍要测检索、多轮恢复和真实需求覆盖。
我会先做的验证
未执行的验证方案:固定 API 池、真实用户测试集及总调用预算,对比先问题后执行与先执行后问题;将执行通过率、语义覆盖率、重复率和多轮任务成功率分开记录。