TTR Compressor:用推理时岭回归压缩相关 token
压缩器能否识别重复信息,而不只把邻近 token 平均?
把 token 块看成一次小型回归问题:在每次前向中求解压缩向量,以相关性抑制重复信息。语言和视觉实验支持其效率潜力,但压缩率不能直接当作端到端加速。
图解主要方法
压缩器能否识别重复信息,而不只把邻近 token 平均?
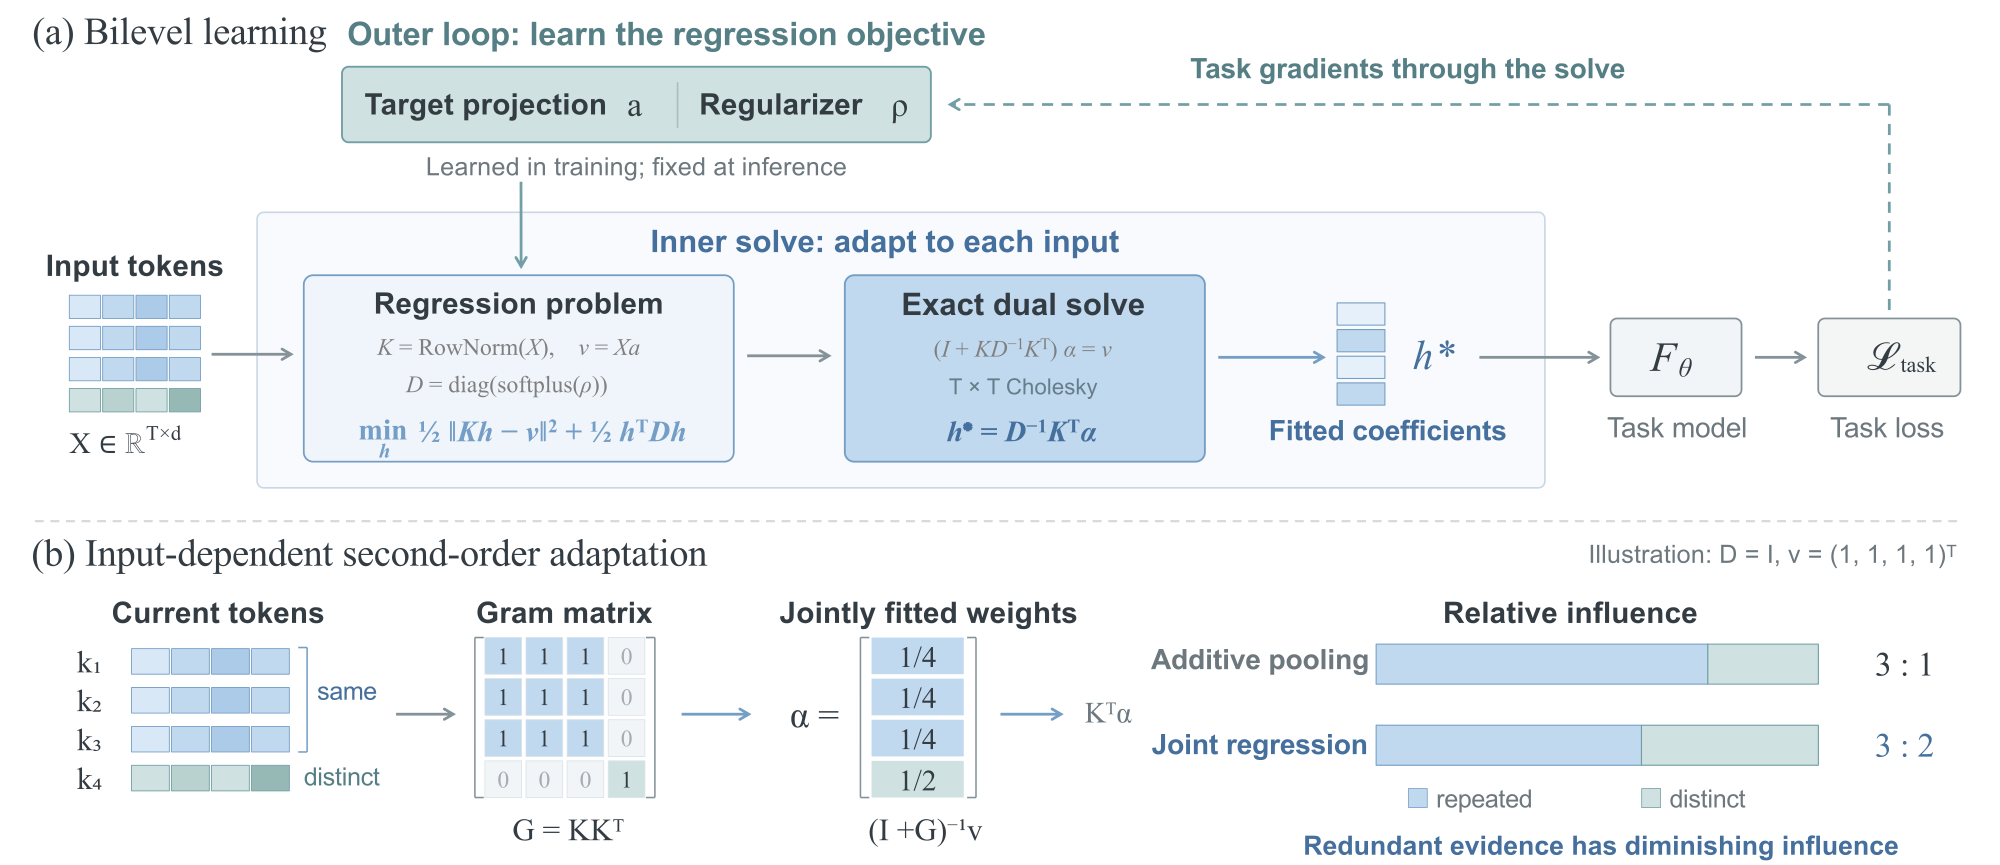
- 1
构造带范数的回归目标
图2先将输入归一化成键 k=x/||x||,目标却保留原始 x 的幅度,用可学习向量投影得到 aᵀx。若键和目标同时归一化,回归容易退化为近乎固定的投影,失去根据当前样本分配信息的作用。
- 2
在前向中解出压缩器
对每个输入块求带对角正则 D 的岭回归;D 由 softplus 参数保持为正。使用对偶形式在 token 数量大小的矩阵上做 Cholesky 求解,核心是 h=D⁻¹ᐟ² K̃ᵀ(I+K̃K̃ᵀ)⁻¹v。相关 token 在逆矩阵中相互抵消,因此重复出现不必获得成倍权重。
- 3
接入稀疏注意力或视觉降采样
语言端用压缩结果服务块级注意力,视觉端加入卷积局部混合再合并 patch。基础模块仅增加约2d参数,卷积语言/视觉版本约7d/11d;这指压缩模块参数,不是整个模型的规模。
- 4
区分测试时求解与测试时训练
回归解随输入改变,但不更新预训练模型权重。实现将数值敏感求解置于FP32、外围计算使用BF16,额外求解成本需要和节省的注意力成本一起核算。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据345M、16层、隐藏维1024模型在FineWeb训练30B token,8k上下文、30k步、batch128;块64、top32、局部窗口512。RULER平均从attention的0.3920升至TTR的0.5092,卷积版0.5144。 语言实验与RULER ↗
我的解读这是固定训练设定下的检索提升,不代表所有长度稳定占优:32k S-NIAH1中普通TTR为0.650,低于attention的0.740,卷积版才达到0.988。
来源证据1B模型训练100B token后RULER由0.735升至0.7996。短上下文常识评测中压缩器未激活。 规模扩展与短上下文 ↗
我的解读扩展结果增加了可信度;短上下文没有损失不能证明压缩机制在这些任务上带来收益。
来源证据Qwen3-VL视觉编码器配Qwen3-4B,使用LLaVA558k和1.3M训练;3×3卷积压缩得54.85分,2×2 MLP为54.93,视觉token减少55.6%。OCR为60,低于基线62.8。 视觉实验 ↗
我的解读token节省与接近的平均分有吸引力,但细粒度文字会受损;论文没有据此证明整个服务吞吐提高55.6%。
开放情况与使用许可
作者项目与Sphere-AI-Lab/ttr-compressor仓库已可访问,存在块稀疏注意力及视觉合并实现。未核实新代码统一许可证;仓库中的第三方许可证不能自动覆盖全部新增代码。权重开放尚未独立确认。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
同一压缩公式覆盖语言和视觉,并有相关性机制、规模扩展和组件消融,值得作为高分辨率与长上下文的中间模块。
反方 · 哪些结论还不够
求解器开销、数值稳定性和任务细节保留仍需实测;部分长上下文及OCR退步,平均分会掩盖退化。
综合判断
支持将输入相关的闭式求解作为压缩器候选;尚不足以替代真实部署中的时延、显存和长尾精度验收。
我会先做的验证
未执行的验证方案:在同一硬件、同一总上下文和batch下比较MLP、平均池化与TTR;分别测求解耗时、峰值显存、端到端吞吐,并固定OCR与32k检索样本检查失败分布。